
🧑💻 面试官:知识库里有很多图片,你会怎么做 RAG?
🙋♂️ 我:可以先识别图片中的文字,再按普通文本检索。
🧑💻 面试官:设备接线图里的两条线,文字识别出来以后,连接关系还在吗?
🙋♂️ 我:不一定,还需要保留图片,或者建立图像检索能力。
🧑💻 面试官:那我把文字向量和图片向量放进同一个库,就能直接比较了吗?检索到一张图以后,回答模型应该看到什么?
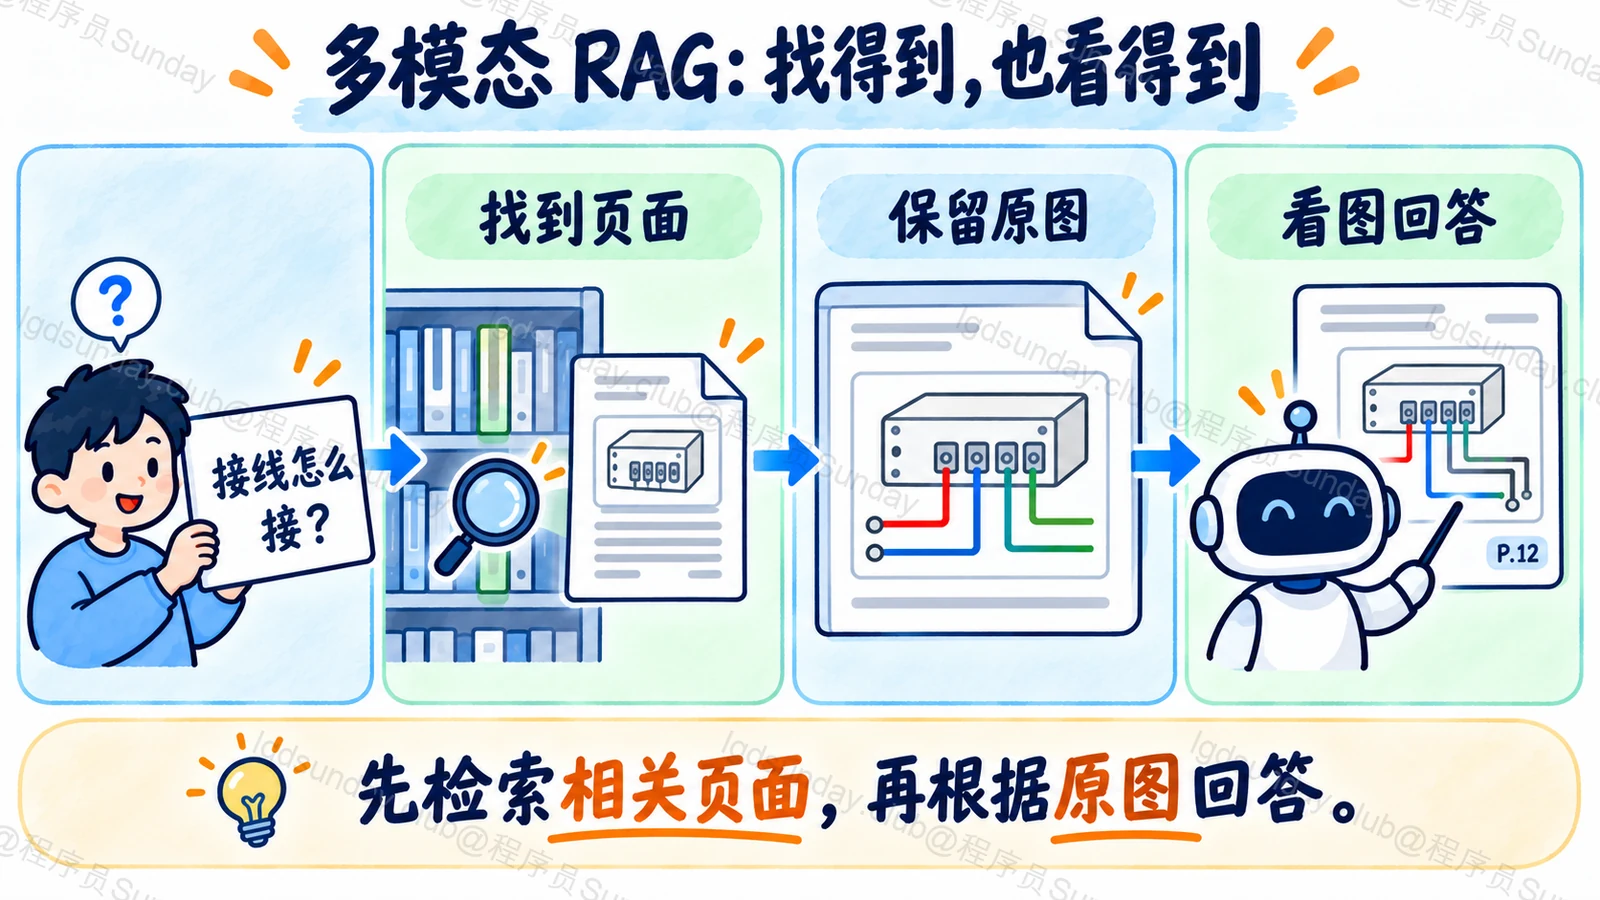
多模态 RAG 的重点是「找得到,也看得到」:检索要匹配问题与图像,生成时还要拿到足以支持答案的原始证据。
面试速答(60 秒版)
多模态 RAG 是把文字、图片等不同形式的资料用于检索增强生成。它不只是把图片做一次 OCR,再全部当成文字处理。
实现时,可以给图片建立文字描述,也可以使用能够匹配文字与图像的检索模型;文档页面还可以采用专门的视觉检索方式。选择哪条路线,要看问题需要的是文字内容,还是图中的位置、连接与变化趋势。
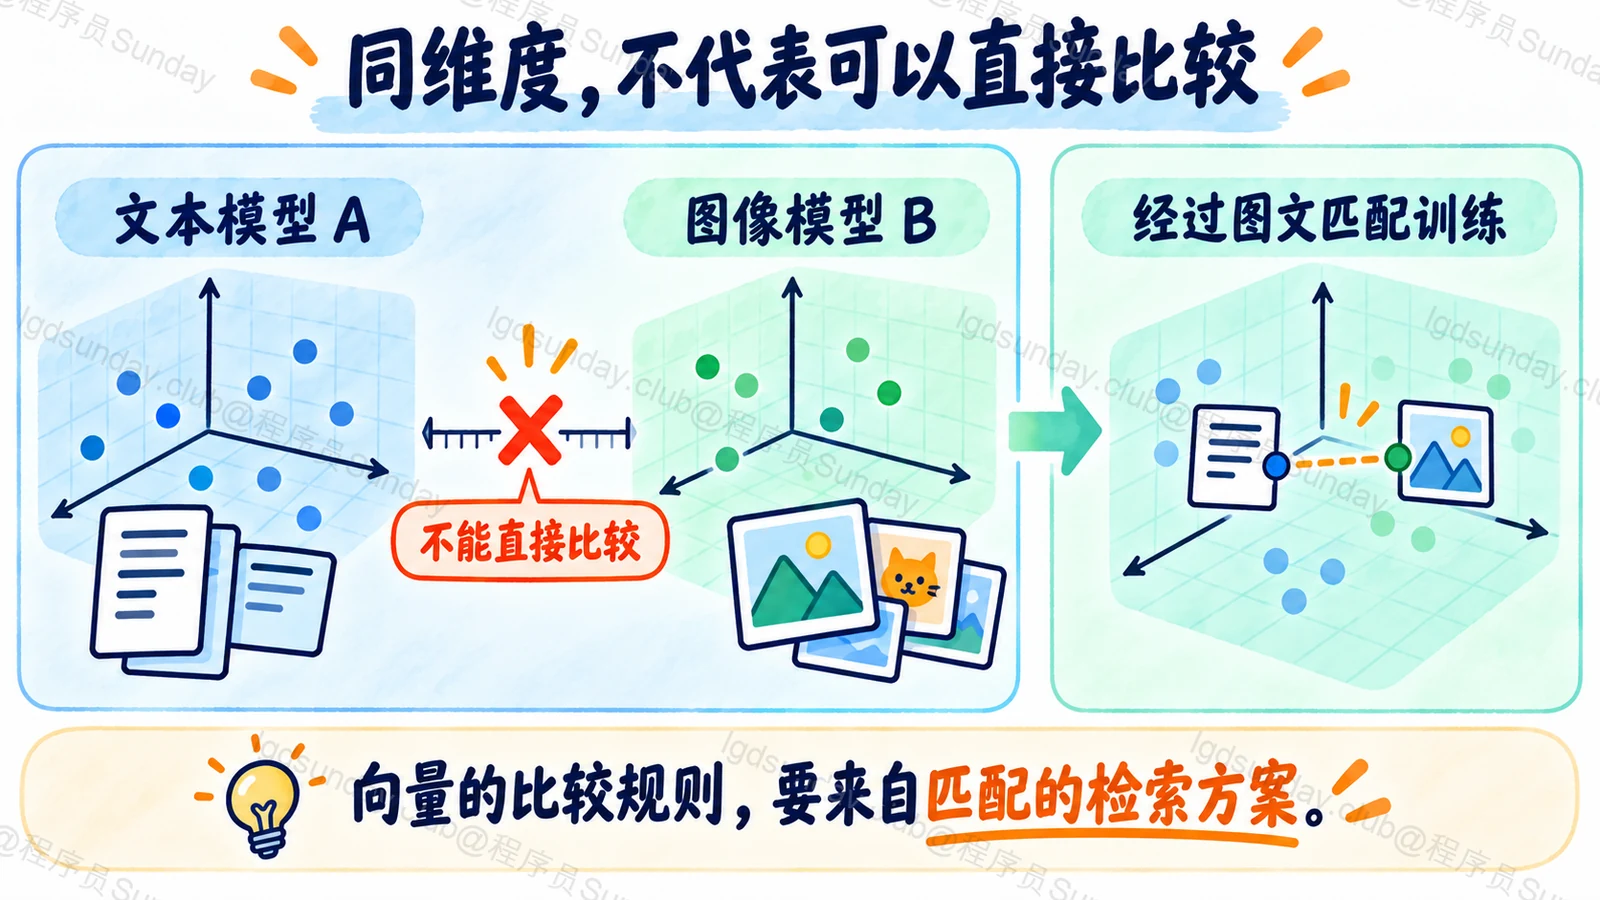
同时,文字和图片的向量不能因为维度相同就直接混用,它们需要能够在同一检索规则下匹配。
检索到相关图片以后,还要取回原图或必要区域,交给能理解图像的模型,并保留文档、页码与权限信息。最后用图像相关的问题检查检索与回答,而不是只看文本题的正确率。
知识点详解:图片怎样进入检索和回答?
先看文字转换会丢掉什么
假设咱们的知识库是设备手册。用户问:“控制器的报警端子应该接到哪一个接口?”
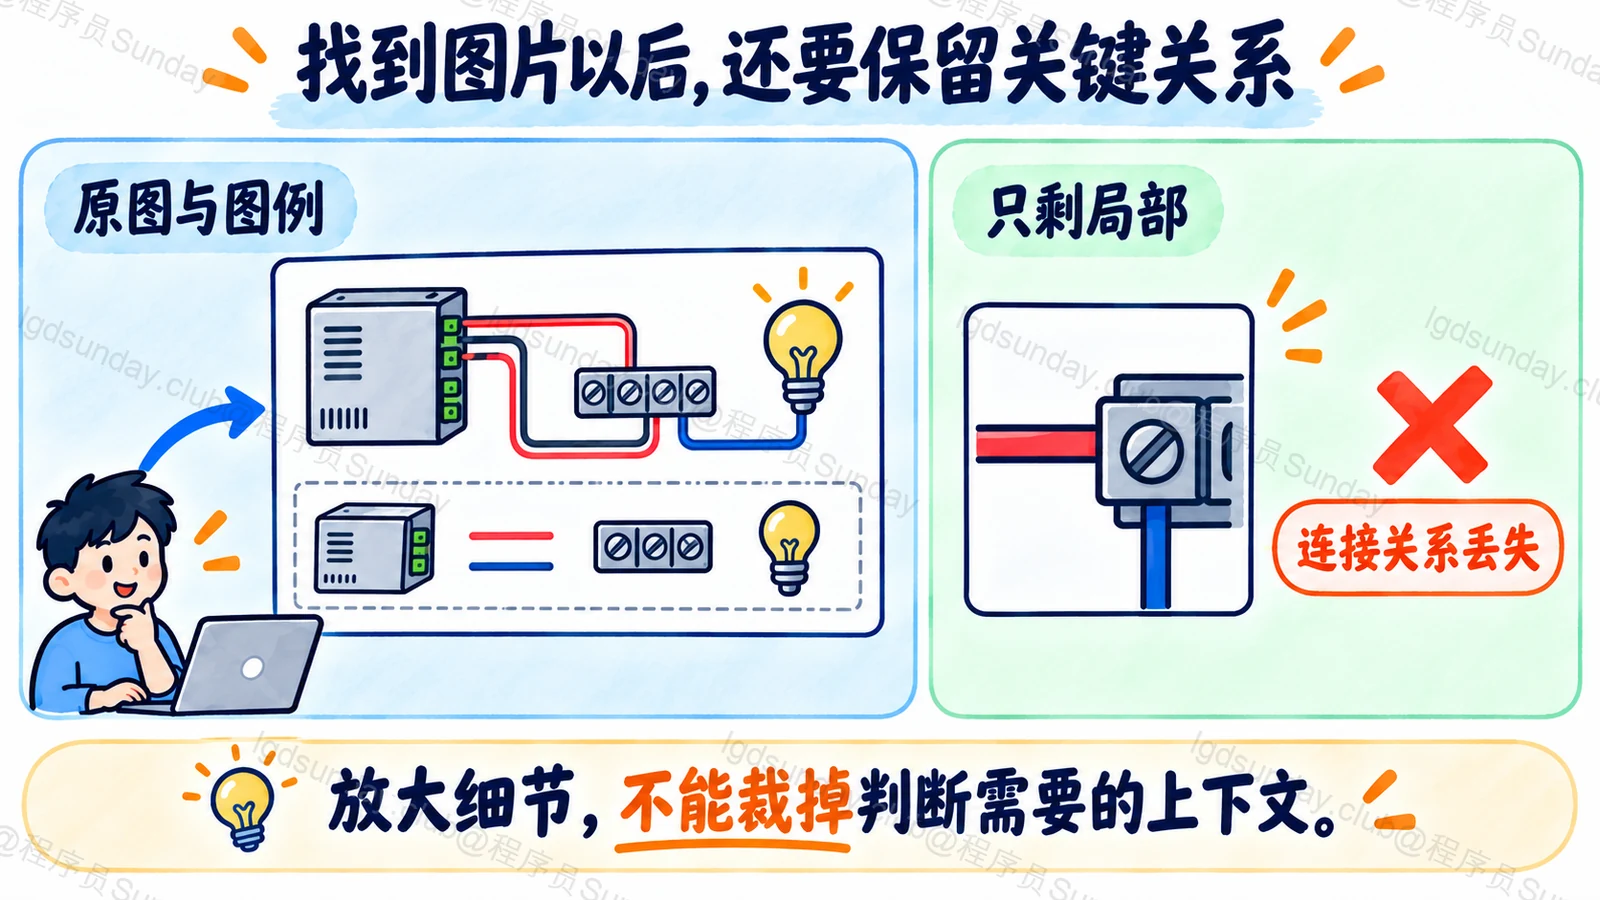
手册上有端子名称,也有线条、箭头和连接点。OCR 能识别出这些名称,但如果输出只是一串文字,哪个端子连向哪个接口就可能丢失。
因此,首先要问当前任务依赖什么信息。用户查产品型号,文字检索往往已经很好用;用户查接线关系,只保留文字就可能不够。
图片描述也有类似问题。描述模型如果漏写了一条线,后续检索不会自动补回来。它可以帮忙定位,但不能保证代替原图。
建索引时,可以选择不同的表示方式
一种路线是保留 OCR 文本、页面摘要和原图地址。搜索先用文字定位,回答时再取对应图片。
另一种路线是使用经过图文匹配训练的检索模型,让用户的文字问题能够找到相关图片。还有一些文档检索模型直接处理页面视觉信息,不要求先把页面完整转成纯文本。
VisRAG 的原始方案展示了从页面图像建立检索表示,再用视觉语言模型生成回答的路径;ColPali 论文则展示了利用页面视觉表示与多向量交互进行文档检索的做法。它们是具体方案,不代表所有多模态 RAG 都必须采用同一个模型或索引结构。
要特别注意:两个向量都是 1024 维,不代表它们表达的是同一种空间。一个模型产出的文本向量,和另一个无关模型产出的图片向量,不能仅凭长度相同就计算距离、期待有意义的结果。
分别建索引后融合候选,也是一种选择。融合前仍然要确认不同通道的分数怎样比较,不能随便把两个原始分数相加。
检索结果只是入口,原图才是回答证据
搜索阶段找到的是“这张图可能相关”,不是“图里的答案已经确认”。
因此,一条结果至少要能找回对应文件、页面和原始图片。接线图还可能需要附上相邻说明页,帮助模型识别符号或例外条件。
| 环节 | 给下一步什么 | 不能漏掉什么 |
|---|---|---|
| 索引 | 文本、图像或页面检索表示 | 稳定的原图与文档标识 |
| 检索 | 相关页面候选 | 权限、版本和页码 |
| 取证 | 原图、必要文字和局部区域 | 图例、连接关系与关键条件 |
| 回答 | 根据证据解释连接方式 | 可回看的出处 |
裁切图片时也要小心。把某个端子放大确实更容易看清,但如果把另一端的接口和图例裁掉,模型就可能无法判断整条连接。
对于无法看清的字符或接线,应该说明需要更清楚的原图,不能靠相似设备的知识补上本机型的答案。
怎样验证多模态路线真的有必要?
可以准备三组设备问题:纯文字说明能回答的、需要读图中文字的、必须判断连接或位置的。
分别比较纯文本路线、文字定位后看图、视觉检索后看图。先看正确页面是否取回,再看关键区域是否保留,最后检查回答与原图是否一致。
这样才能区分“没搜到图”和“搜到了却看错图”。同时记录页面数量、图像处理延迟和费用,避免为了所有简单文字题都启用昂贵的图像流程。
面试官继续追问
使用了视觉大模型,就一定是多模态 RAG 吗?
不一定。用户直接上传一张图让模型回答,是图像理解;从外部资料库检索证据,再用证据回答,才涉及 RAG。模型能看图和系统有检索,是两个不同能力。
图片很多,能不能只把图片摘要交给回答模型?
可以用于只依赖描述的任务,但要承认信息经过了压缩。接线、曲线和空间位置等问题,最好取回原图;否则摘要漏掉的内容不会因为模型更强就重新出现。
换了图像检索模型,需要重建索引吗?
通常需要检查并重新生成相应表示。模型、维度、归一化与相似度规则都属于索引契约。新旧表示不能未经验证混在一起比较。
面试速记卡
- 多模态 RAG:从文字、图片等外部资料中检索证据,再生成回答。
- 表示选择:文字描述、图文匹配与页面视觉检索,各有信息损失和成本。
- 向量边界:维度相同,不代表来自可直接比较的空间。
- 回答证据:取回原图及必要区域,保留图例、页码与版本。
- 验证路径:先检查页面召回,再检查视觉理解和答案依据。
