
🧑💻 面试官:知识库里有一份套餐说明 PDF。OCR 把数字都识别对了,但模型回答套餐容量还是错,可能是什么原因?
🙋♂️ 我:可能把表格的行列关系弄丢了,模型不知道每个数字对应哪个套餐。
🧑💻 面试官:那转成 Markdown 表格就可以了?
🙋♂️ 我:简单表格可以这样处理,复杂表格还要注意合并单元格和多层表头。
🧑💻 面试官:表格下面还有一句“存储空间为团队共享”,下一页又接着同一张表。这些也会自动保留下来吗?
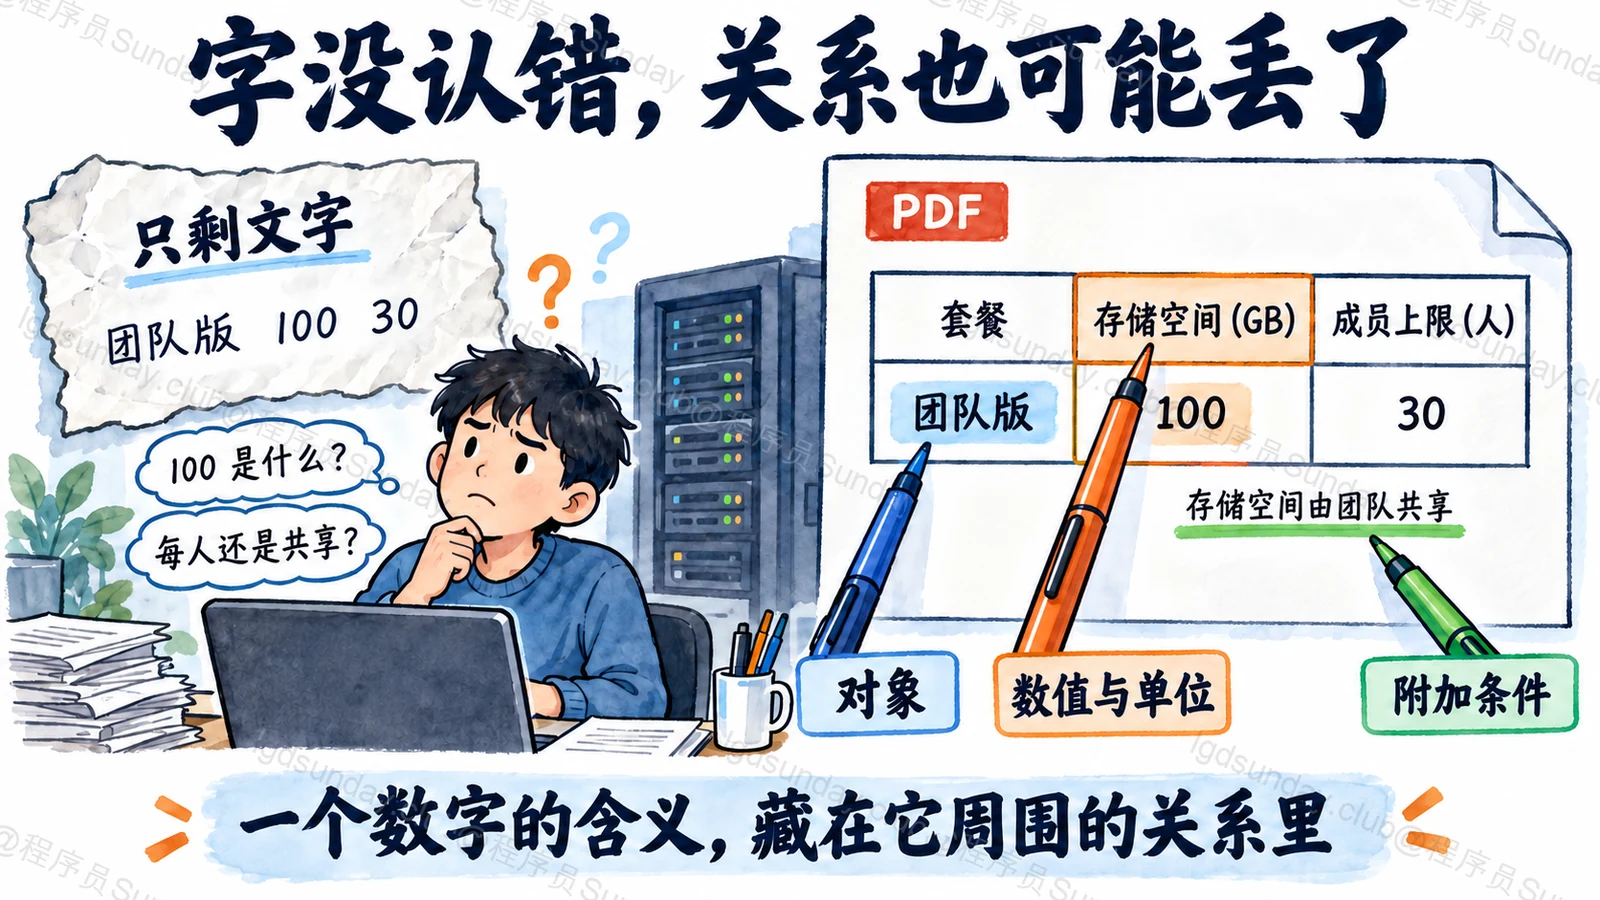
表格里,一个数字的含义来自它所在的行、列、单位和附加说明。文字没认错,不代表这些关系也被保住了。
面试速答(60 秒版)
处理 PDF 表格时,不能只提取文字,还要保留表格的结构。
例如“100”这个数字,到底是 100 GB 存储,还是最多 100 个成员,取决于它所在的行和列。解析时需要保存套餐名称、列标题、单位,以及合并单元格、脚注和跨页关系。
入库时,可以同时保留结构化表格和适合搜索的文本。搜索文本帮助找到相关套餐,回答时再把需要的行列、表头和说明一起提供给模型,并保留页码和原文位置。
如果问题需要计算,可以从确认过的单元格取值,再交给程序计算。验证也不能只看 OCR 准确率,还要检查行列有没有错位、单位有没有丢,以及最终答案能不能对应回原表。
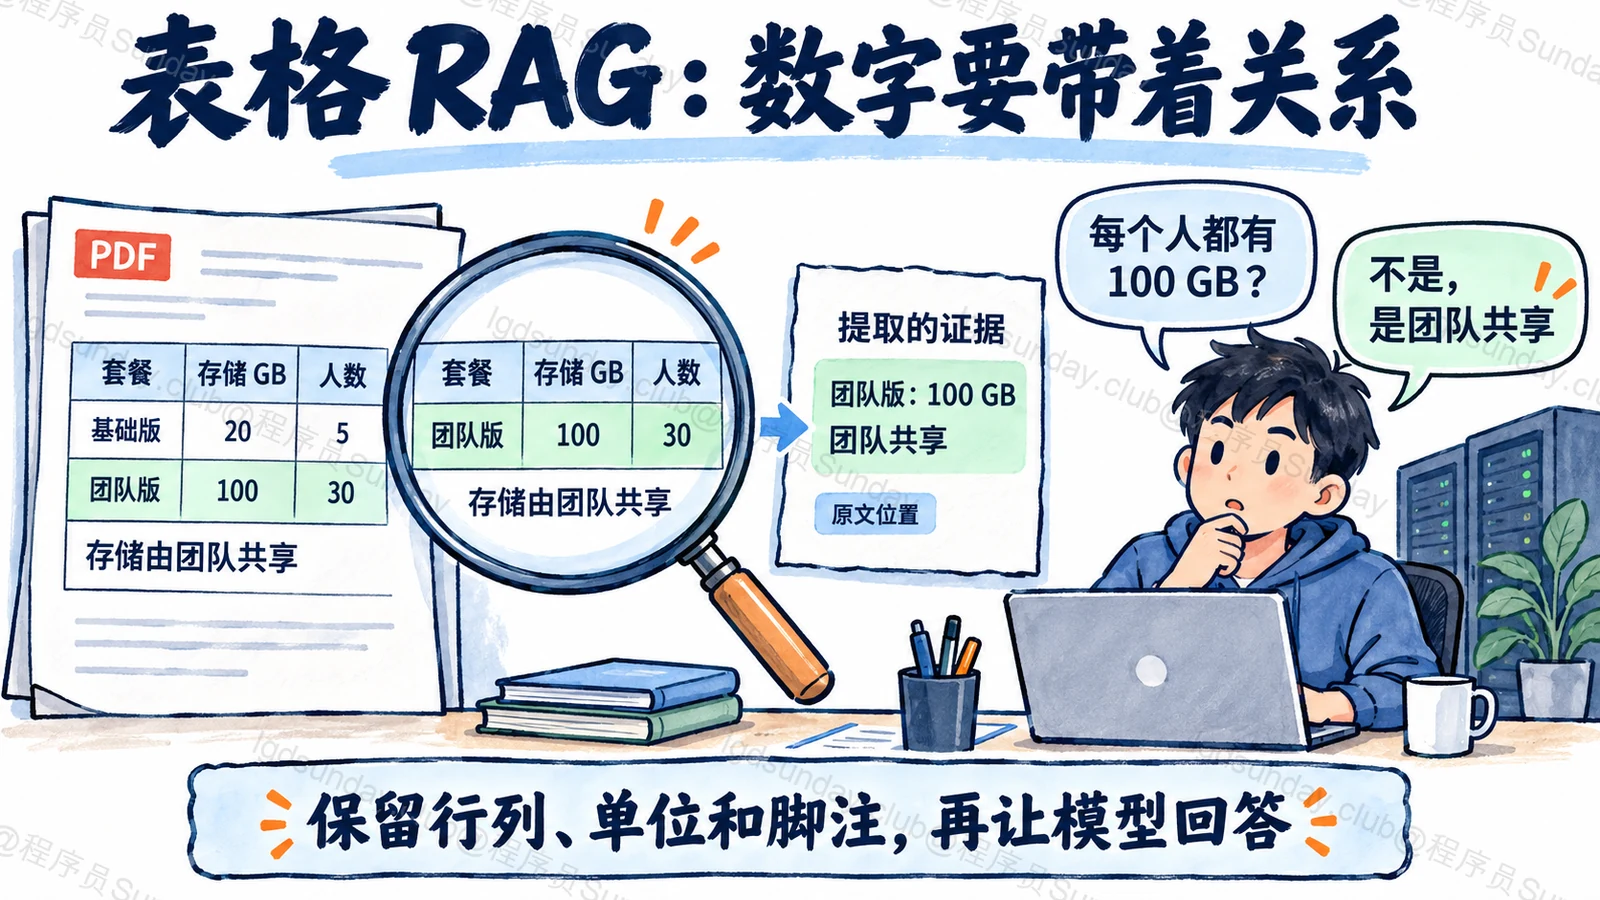
知识点详解:一个“100”,为什么会变成两种答案?
先看看表格里到底有什么信息
假设产品说明里有这样一张表,以下套餐和数字只用于讲解:
| 套餐 | 存储空间(GB) | 成员上限(人) |
|---|---|---|
| 基础版 | 20 | 5 |
| 团队版 | 100 | 30 |
表格下面还写了一句:“存储空间由同一团队的全部成员共享。”
用户问:“团队版每个人都有 100 GB 吗?”
正确回答应该是:不是,100 GB 是整个团队共享的空间。
但如果解析结果只剩“基础版 20 5 团队版 100 30”,数字一个都没错,模型仍然缺少必要关系。它可能搞错 100 对应哪一列,也可能知道是存储量,却漏掉“团队共享”。
OCR 解决的是把字认出来,表格问答还要知道这些字怎样组成一条完整信息。
怎样把行列关系留下来?
对于简单表格,保存成 Markdown 往往已经能表达行列关系。遇到多层表头、合并单元格和跨页表格,就不能只依靠把文本按顺序拼起来。
解析结果可以保存行号、列号、单元格文本、跨越的行列范围,以及所在页和坐标。微软的 Layout 文档就提供这类表格信息。
有了这些数据,后端才能把“100”对应到“团队版”这一行和“存储空间(GB)”这一列,必要时还可以在原 PDF 上找到这个位置,供人检查。
脚注也需要单独关联。不能因为解析器返回了表格对象,就认定表格下面的说明一定包含在里面。比如上述微软文档明确说明,相关版本的表格核心区域不包含标题和脚注。
跨页时同样如此。第二页只有几行数据、没有重复表头,就需要结合页序、列结构和内容判断是否延续上一页的表。不能看到两页列数相同,就直接拼成一张表。
这些关系可以借助版面解析工具处理,但重要文件仍然需要抽样核对,工具支持某个能力,不代表每份 PDF 都会解析正确。
搜索需要的文本,和回答需要的表格可以分别保存
原始表格有了,下一步才是让用户的问题能够找到它。
直接对一长串单元格做向量化,不一定好搜。可以从经过核对的结构中生成带上下文的文本,例如:
团队版:存储空间 100 GB,成员上限 30 人。存储空间由团队成员共享。来源:套餐说明第 3 页。
这段文本用于检索时,数字已经带上了对应对象和单位。但它不应该成为唯一保留的材料,原始表格结构和出处仍然需要留下。
这样,当用户问团队容量时,系统可以先找到这条记录,再取回对应表格行、表头和共享说明。模型不必看到整份 PDF,也能拿到足够完整的依据。
Unstructured 的文档分区说明也区分了表格元素及其结构化表示。实际项目可以选择不同解析工具,但不要把工具名当成验收结果。
如果表格非常长,可以按行组或主题分块,给每块重复补上必要表头、单位和表格 ID。否则切到后半部分时,又会变成一堆不知道含义的数字。
最后应该检查什么?
先检查解析,再检查问答,别把所有错误都归到模型头上。
对于前面的套餐表,可以分别问:“团队版有多少存储?”“最多多少人?”“每个人是不是都有这么多?”这三个问题使用相近的数字,却在检查不同关系。
再补一些更容易出错的文件:跨页表头、多层标题、合并单元格,以及单位从 GB 变成 TB 的情况。检查取出的行列是否正确,附加说明是否一起进入模型输入。
如果答案错了,就沿着这条路往回看:原 PDF 正确吗?解析后的结构正确吗?检索拿到了正确行吗?模型最终是否理解了“共享”?
还可以保留一个无法回答的问题,例如“团队版下个月会涨多少容量”。原表没有这项信息,系统应该说明资料不足,而不是根据表里的两个数字继续猜。
面试官继续追问
直接把 PDF 交给多模态模型,不就省掉解析了?
少量文件、临时问答时,可以评估这种方式。它可能更容易利用页面视觉关系,但同样会读错表格,也会受到页数、输入成本和模型能力影响。
如果要反复搜索大量文档、精确定位出处,预先解析和建立索引仍然有维护价值。两种方案可以比较,不必为了用 RAG 把简单场景做复杂。
用户问团队版比基础版多多少存储,谁来算?
先确认取到的是同一个指标和单位,再计算 100 - 20 = 80 GB。
这一步可以交给确定性的程序。模型负责理解问题、选择需要的数据和组织回答,程序负责算术。但如果上游把成员数当成了存储量,计算器也救不了这个答案。
解析不确定,能不能让模型自行补齐?
可以让模型提出候选关系,不能把猜测悄悄当成原文。
例如跨页衔接判断不稳时,保留原页图和结构位置,标记待复核;高风险数据不应直接进入可回答索引。比起给出一个很肯定的错误数字,明确告诉用户当前资料还不足以确认更合适。
面试速记卡
- 表格信息:数字必须带着行、列、单位和附加条件理解。
- 解析目标:不只提取文字,还要保留单元格关系和出处。
- 入库方式:可搜索文本负责定位,结构化表格保留依据。
- 计算问题:先取对值、对齐单位,再交给程序计算。
- 验收方法:分开检查解析、检索和回答,覆盖跨页与脚注。
