
🧑💻 面试官:假设我们做了一个企业知识库。员工上传了一份《差旅报销规定》,里面明明写着“出差结束后 30 天内提交打车票”。可他问系统“打车票最晚什么时候交”,RAG 却说找不到。你怎么排查?
🙋♂️ 我:可能是相似度不够。我会先把检索的 top_k 调大一点,再试试降低分数阈值。
🧑💻 面试官:文件页面显示上传成功,但后台解析任务还没跑完,索引里根本没有这句话。你把 top_k 调到 100 能找到吗?
🙋♂️ 我:找不到。得先确认文件有没有解析成功,那段文字有没有被切成片段并写进索引。
🧑💻 面试官:好,现在能按 chunk_id 查到那段“30 天”的文字,但用户正常提问还是搜不到。下一步呢?
🙋♂️ 我:我会看实际发给检索服务的查询内容、查的是哪个索引,以及这次请求带了什么过滤条件。片段在索引里,不代表它一定在当前用户能搜索的范围里。
🧑💻 面试官:一关掉部门权限过滤,片段就出现了。是不是把过滤关掉,问题就解决了?
🙋♂️ 我:不能。要检查这份文档的部门标记、员工的授权信息和过滤条件有没有对齐。为了搜到一份文档,把其他部门的资料也放出来,那是另一个更严重的问题。
🧑💻 面试官:如果权限没问题,正确片段只是排在第 12 位,而系统只取前 5 位呢?
这道题不是让你背一组 RAG 调参技巧,而是要找到答案所在的片段究竟在哪一步消失了。
面试速答(60 秒版)
RAG 检索不到文档时,先确认答案所在的那段文字,是不是真的进入了当前可查询的索引。
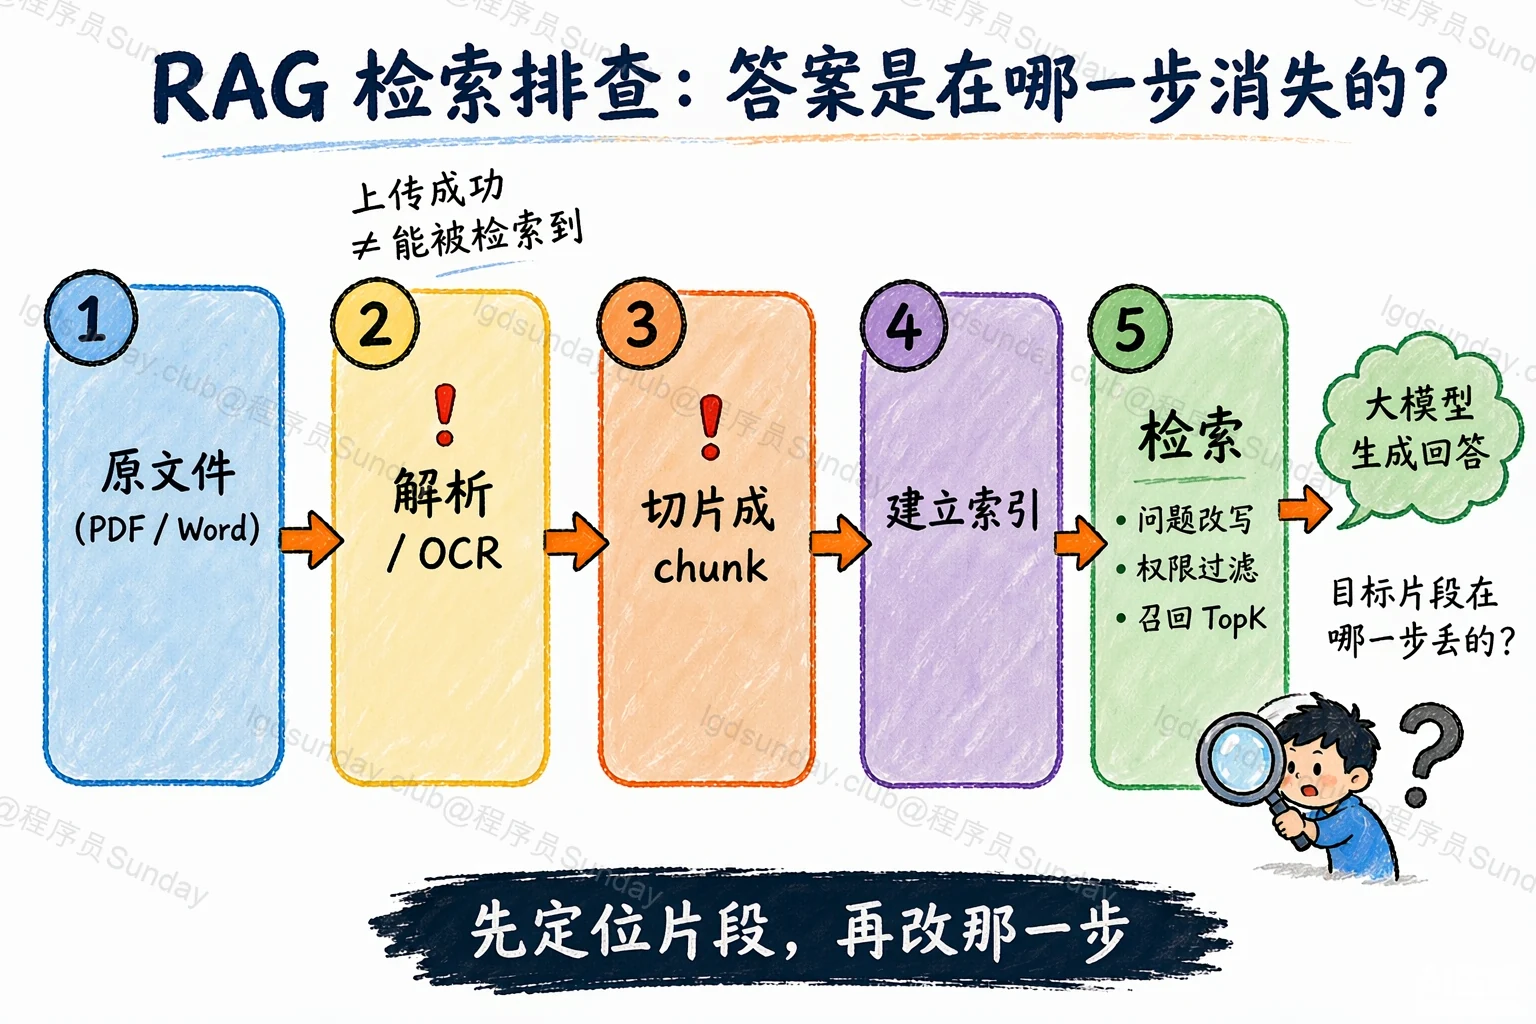
因为“文件上传成功”和“内容可以被检索到”是两回事。文件上传以后,通常还要经过解析、切片、生成向量和建立索引。如果原文里有答案,但解析结果或者切片里没有,调大 top_k 也没用。
如果目标片段已经在索引里,我会用同一个用户的问题和权限条件重放查询,看实际查询文本、过滤条件、初始召回和重排后的结果。这样才能分清它是被权限过滤掉了、没有排进前 K,还是在后面的处理里被丢掉了。
找到原因以后,再改对应的那一步。最后还要用一批标注了正确片段的真实问题做回归,既看能不能搜到,也要确认没有把无权限的文档放出来。
知识点详解:一段文字是怎样从 RAG 检索链路里消失的?
文件在知识库里,不代表答案已经能被检索
还是用刚才那份《差旅报销规定》举例。用户看到文件上传成功,说明原文件被系统接收了。但 RAG 检索的通常不是这个文件本身,而是从文件里提取、切分出来的内容。
一个常见的处理过程是:先从 PDF 提取文字,必要时对图片中的文字做 OCR;再把长文切成可以单独检索的片段;最后为片段建立文本或向量索引。
因此,排查的第一件事不是调模型,而是在原文件里找到“出差结束后 30 天内提交打车票”这句话,然后问:索引里有没有包含这句话的片段?
如果没有,就沿着入库过程往前查。
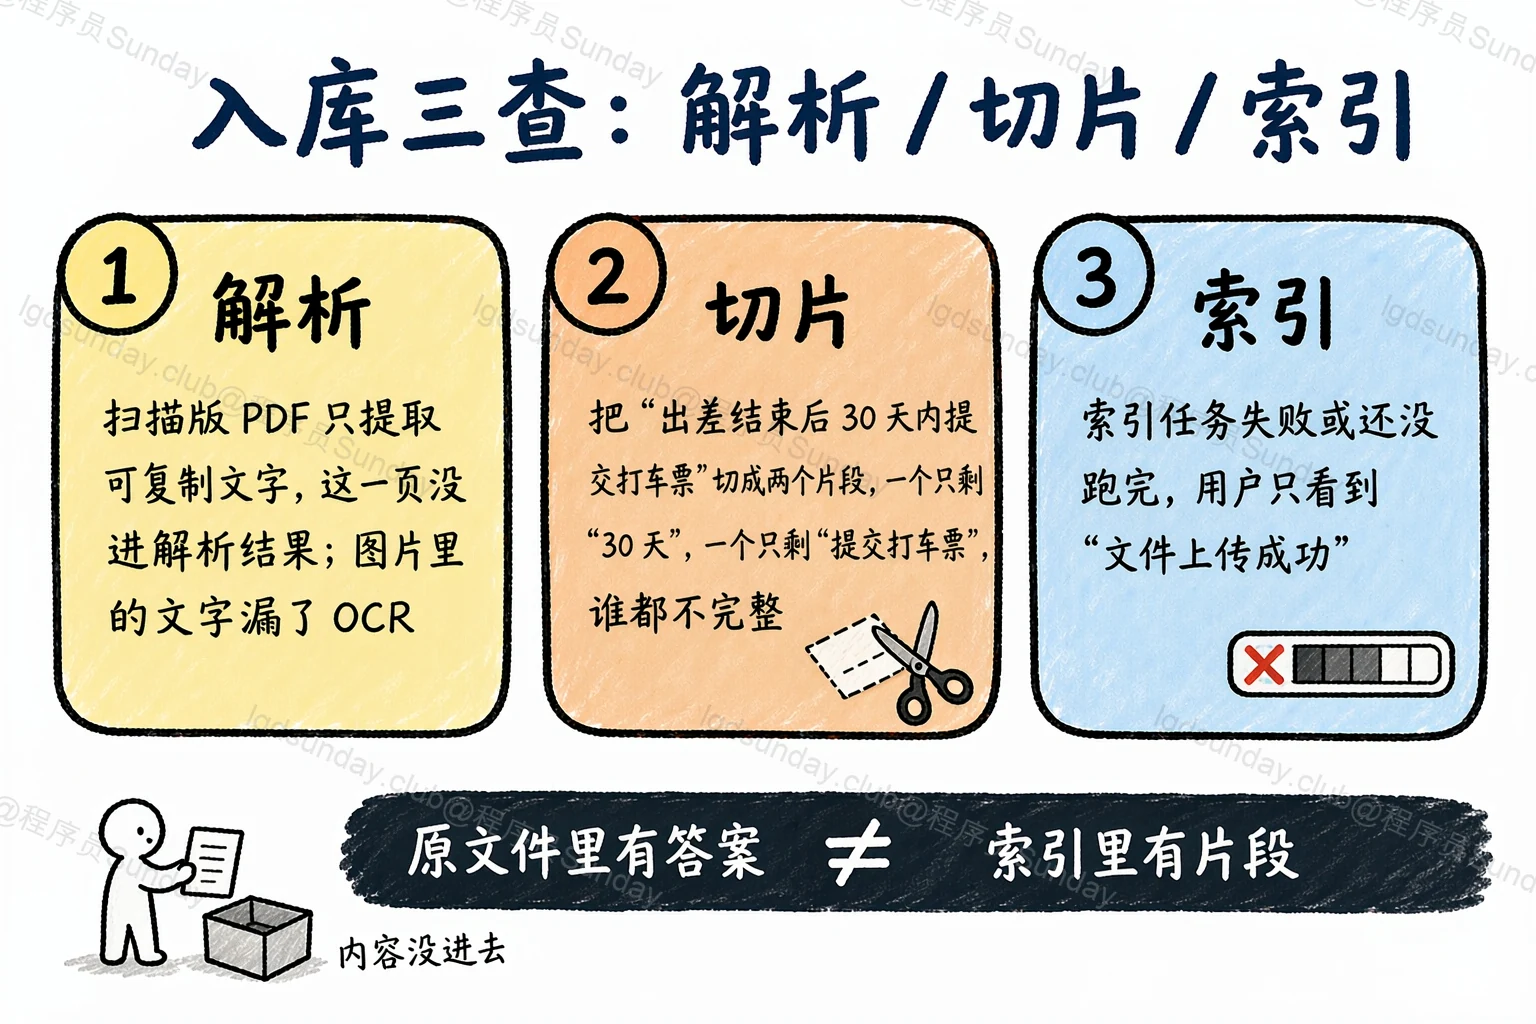
比如,规定是扫描版 PDF,但解析程序只提取可复制的文本,这一页可能根本没有进解析结果。也可能文字提取出来了,切片时却把“30 天”与“提交打车票”的条件切到了不同片段里,两个片段都在,但任何一个单独拿出来都说不清这条规定。还有一种情况是片段已经生成,但索引任务失败或尚未完成,用户仍然只看到了“文件上传成功”。
如果是解析为空或索引失败,目标内容根本不在索引里,调大候选数量没有用。如果是条款被切散了,单纯调参数也可能只是碰巧捞到其中一半;要先把切片内容和它的上下文检查清楚。
片段已经在索引里,再查这次请求到底搜了什么
假设我们按 document_id 或 chunk_id,已经能在索引中找到正确片段。接下来就该检查查询这一侧。
至少把这些记录放到同一条请求 Trace 里:用户原始问题、改写后的问题、使用的索引或知识库、过滤条件、初始召回的片段 ID,以及最后交给模型的片段 ID。没有这些信息,看到一句“未找到相关资料”,很难知道是哪一步出了错。
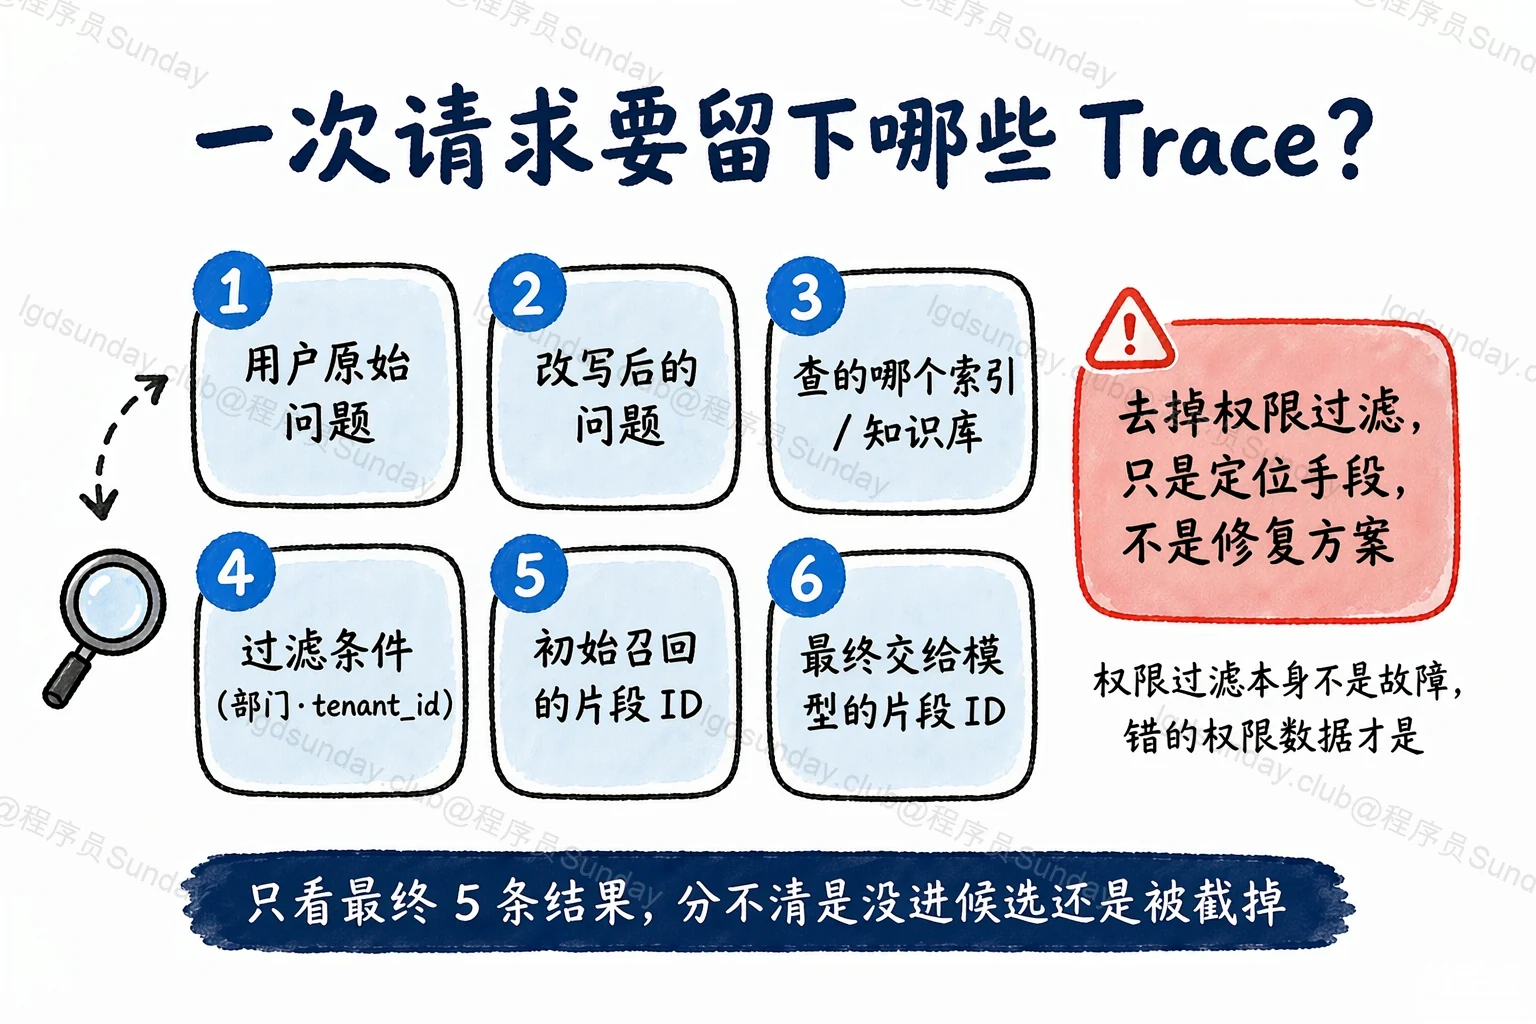
拿刚才的例子说,如果正常查询没有结果,但在受控调试中去掉部门过滤后能找到,不要直接删除过滤条件。先核对用户是否真的有权查看这份规定,再看文档上的 tenant_id、部门或授权组等标记是否写错,查询时的过滤表达式是否与授权关系一致。权限过滤本身不是故障;错误的权限数据或过滤规则才是。
如果过滤条件正确,目标片段仍没进入初始候选,再检查查询有没有被改写得太偏、向量检索是否覆盖这种问法。遇到制度编号、日期、产品型号这类需要精确匹配的内容,还可以比较关键词检索或混合检索的结果,而不是认定“向量检索一定更聪明”。
另一种情况是:受控调试时把候选范围放大,发现目标片段排在第 12 位,而正常查询只取前 5 位。也可能它已经进入初始候选,却被分数阈值淘汰,或者重排以后掉出了最终结果。此时才轮到我们比较候选数量、阈值和重排策略。要分清“片段有没有进初始候选”和“片段最后有没有交给模型”,不能只看最终那五条结果。
修好这一题,不等于整个知识库都修好了
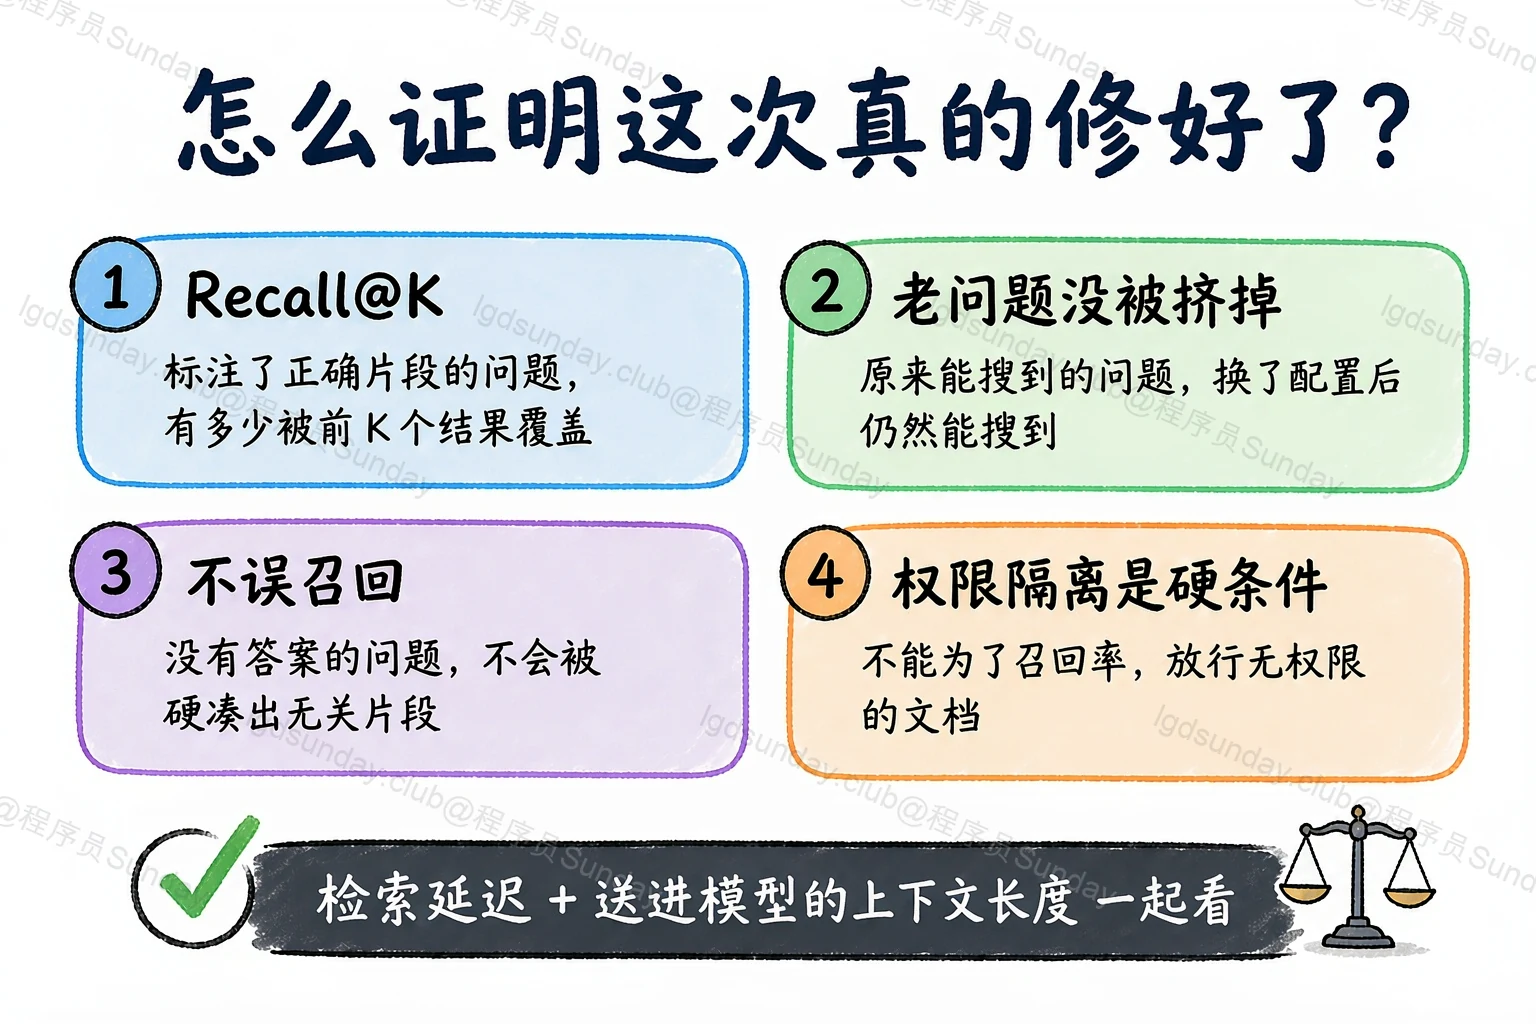
单独让“打车票最晚什么时候交”搜到正确条款,不能说明修复是有效的。我们还需要准备一批实际会出现的问法,并标出每条问题应该命中的文档或片段。
这样才能检查:正确片段有没有进入前 K 个结果;原本能搜到的问题有没有被新配置挤掉;没有答案的问题是否开始误召回。对于多条相关片段的任务,还可以看 Recall@K,也就是已标注的相关内容有多少被前 K 个结果覆盖。
同时要把权限当成硬条件。一个修改让召回率上去了,却使无权限用户也能检索到其他部门的文档,这不能算修好。检索延迟和送进模型的上下文长度也要一起看,不能为了这一条问题无限增加候选数量。
面试官继续追问
正确片段排在第 12 位,但只取前 5 位,直接把 top_k 改成 20 行吗?
可以作为一个对照实验,但不能只改这个数字就结束。
如果真实问题里经常出现同类情况,先看前 5 位为什么排的是其他内容。是片段缺少标题和条件,导致语义不完整?还是用户提问中有明确的制度名称,系统却只做向量匹配?这些问题处理好以后,正确片段可能本来就能排得更靠前。
增加候选数量也有代价:后续重排要处理更多内容,直接送给模型还会占用上下文。因此要用同一批问题比较命中情况与延迟,而不是凭一条案例定参数。
初始召回有正确片段,最终交给模型时却没有,应该改哪一步?
这时不用回头重建索引。把重排前后的 chunk_id、得分和最终截断规则放在一起看,就能知道它是被重排降下去了,还是上下文构造时被丢掉了。
只有确认丢失位置,修复才会落在正确的模块上。否则“重新切片、换模型、调阈值”全部试一遍,最后即使搜到了,也不知道是哪项改动起了作用。
去掉权限过滤后能搜到,可以把过滤暂时关掉吗?
不能。受控调试中对比有无过滤,是为了确定问题可能出在授权范围;它不是线上修复方案。
如果员工本来有权看这份规定,就修正文档的授权标记或查询过滤规则。如果员工没有权限,系统找不到这份规定反而是正确结果。检索不到有时是故障,有时是在守住边界,先把这两种情况分清。
面试速记卡
- 先定位目标片段:原文件有答案,不代表解析结果和索引里有。
- 入库排查:检查解析/OCR、切片内容和索引状态。
- 查询排查:检查实际问题、索引范围、权限过滤和初始候选。
- 排序排查:扩大候选范围或对比前后结果,再看
top_k、阈值、重排和最终上下文。- 验证修复:用标注问题检查命中与 Recall@K;权限隔离不能为了召回率而放松。
