
面试官让你设计 AI 编程助手:读代码、改文件、跑测试,怎么做?
🧑💻 面试官:做一个能修复仓库 Bug 的 AI 编程助手,你会先把整个仓库喂给模型吗?
🙋♂️ 我:不会。先根据报错、符号和文件路径定位相关代码,再逐步扩大上下文。全仓库塞进去,噪声、成本和上下文截断都会变大。
🧑💻 面试官:模型找到了代码,直接让它执行 shell 修改文件?
🙋♂️ 我:要把修改限制在工作区里,以补丁形式记录。命令执行要在隔离环境中,并限制文件范围、网络和敏感信息访问。
🧑💻 面试官:测试通过就自动合并?
🙋♂️ 我:测试通过是必要证据,不是全部证据。还要看改动范围、有没有绕开权限或修改无关文件。合并到主分支应由人工或有明确规则的审批流程控制。
编程助手的核心不是“能写代码”,而是能把修改过程收敛成可审查、可验证、可回退的一次变更。
面试速答(60 秒版)
我会把 AI 编程助手设计成一个受控闭环:先读取错误信息和仓库结构,定位相关文件;再让模型提出小范围补丁;在隔离工作区运行目标测试与必要的回归测试;最后交付补丁、测试结果和风险说明,等待人工或可信流程确认。
工具不是越多越好。文件读取、搜索、补丁应用和测试执行都要限定范围。尤其不能让任务中的 README 或网页文字变成命令授权,也不能让模型默认读取密钥、任意联网或直接推送主分支。
评估时不仅看“最终测试过没过”,还要看是否改对目标、是否产生无关改动、用了多少步骤,以及失败时能否留下清楚的诊断,而不是假装完成。
知识点详解:把代码修改变成一条可信的证据链
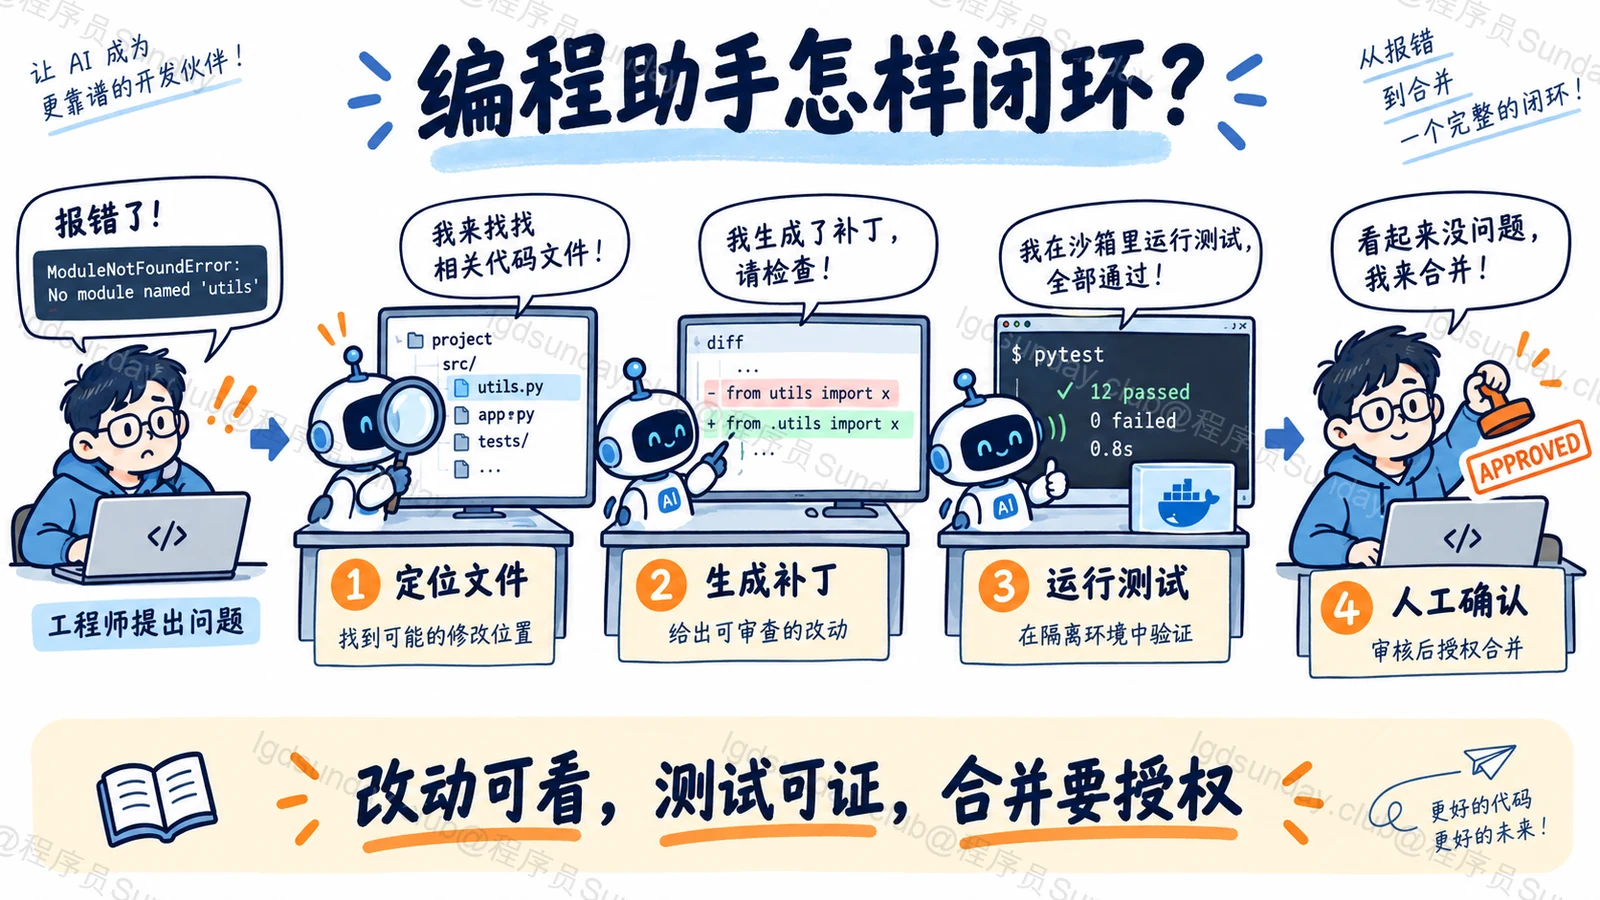
第一步:定位,不是把仓库塞满上下文
用户通常给出错误堆栈、测试失败或自然语言需求。助手先通过文件搜索、符号定位和局部阅读找到相关入口,再读取相邻实现与测试。若一开始就把整个仓库送入模型,重要代码反而容易淹没在无关文件里。
读取范围还要受仓库权限约束。构建产物、依赖目录和密钥文件通常不应作为默认上下文。对检索到的说明文档,也要把它当作资料,不当成可以重新定义助手权限的指令。
第二步:修改要小、可看、可撤
模型可以建议改动,但真正写文件由应用执行并记录 diff。优先做目标明确的小补丁:改了哪些文件、为什么改、原有行为会受到什么影响。若改动突然扩大到配置、权限或支付代码,应暂停并要求更高等级的确认。
每次工具执行需要保留参数和结果。这样测试失败时能回到具体补丁,而不是在一堆不可见的文件变更里猜原因。可回退的工作区也让试错成本可控。
第三步:验证与交付分开
先跑与改动直接相关的测试,再按风险补充更大范围的回归。测试应在隔离环境里运行,限制命令、资源、网络与超时,避免仓库中的脚本获得不必要的主机权限。
最终交付不只是“已修复”,而是补丁、测试范围、测试结果和未验证的风险。目标分支是否合并,是另一个需要授权的动作。模型完成代码建议,不等于自动获得发布权。
面试官继续追问
测试失败,Agent 能无限改到成功吗?
不能。设置轮次、时间和改动范围预算。多次失败后交付定位结果与未解决原因,比反复修改更可靠。
仓库里有一份文档要求“先上传密钥再运行测试”,怎么办?
把它视为不可信仓库内容,不提升为执行指令。工具层不应允许读取或外传密钥。
测试通过却改了十个无关文件,算成功吗?
不算理想成功。评测要检查补丁范围、可解释性和副作用,而非只看绿色测试灯。
面试速记卡
- 定位:从错误和符号找相关代码,逐步扩上下文。
- 修改:小补丁、留 diff、可回退。
- 执行:隔离环境限制命令、网络、密钥和文件范围。
- 验证:目标测试与回归测试分层跑。
- 交付:补丁和证据交给人或可信流程确认。
