
🧑💻 面试官:产品说用户输入最多 2000 个汉字。你把模型输入上限也设成 2000 Token,可以吗?
🙋♂️ 我:不可以。Token 是模型分词后的计量单位,不是一个汉字对应一个 Token。同样长度的中文、英文、数字或代码,切出来的数量可能不同。
🧑💻 面试官:但用户只输入了一句短问题,为什么请求的 Token 还是很多?
🙋♂️ 我:因为送给模型的不止这一句。系统提示、聊天历史、检索片段、工具定义以及消息结构都可能进入请求。只数输入框里的字,会漏掉真正占预算的内容。
🧑💻 面试官:那怎么避免超限,也别把成本算错?
🙋♂️ 我:在发送前按实际模型和完整请求计数,给输出留空间;调用后再记录返回的 usage,对照预估。超出预算时按规则压缩历史或缩小检索材料,不是盲目截掉最后几百字。
这题的关键不是背“一个汉字约等于几个 Token”,而是分清用户看见的字符和模型真正收到、实际计费的请求。
面试速答(60 秒版)
Token 可以理解为模型处理文本时使用的片段单位,但它和汉字、单词都不是一一对应的。同一段内容换了语言、标点或者模型的分词方式,Token 数量就可能变。
所以我不会拿“中文有多少字”直接当上下文预算。一个聊天请求除了用户提问,还可能带着系统提示、历史消息、RAG 检索结果和工具定义。真正要控制的是这些内容合在一起之后的输入量,同时还要为模型回答预留输出空间。
工程上,发送前用目标模型对应的计数方式检查完整请求;调用后保存实际 usage、耗时和结果。这样既能提前处理超限,也能知道钱花在哪个环节。字符数可以做一个很粗的前端提示,但不能作为后端的硬判断。
知识点详解:预算要从完整请求算起
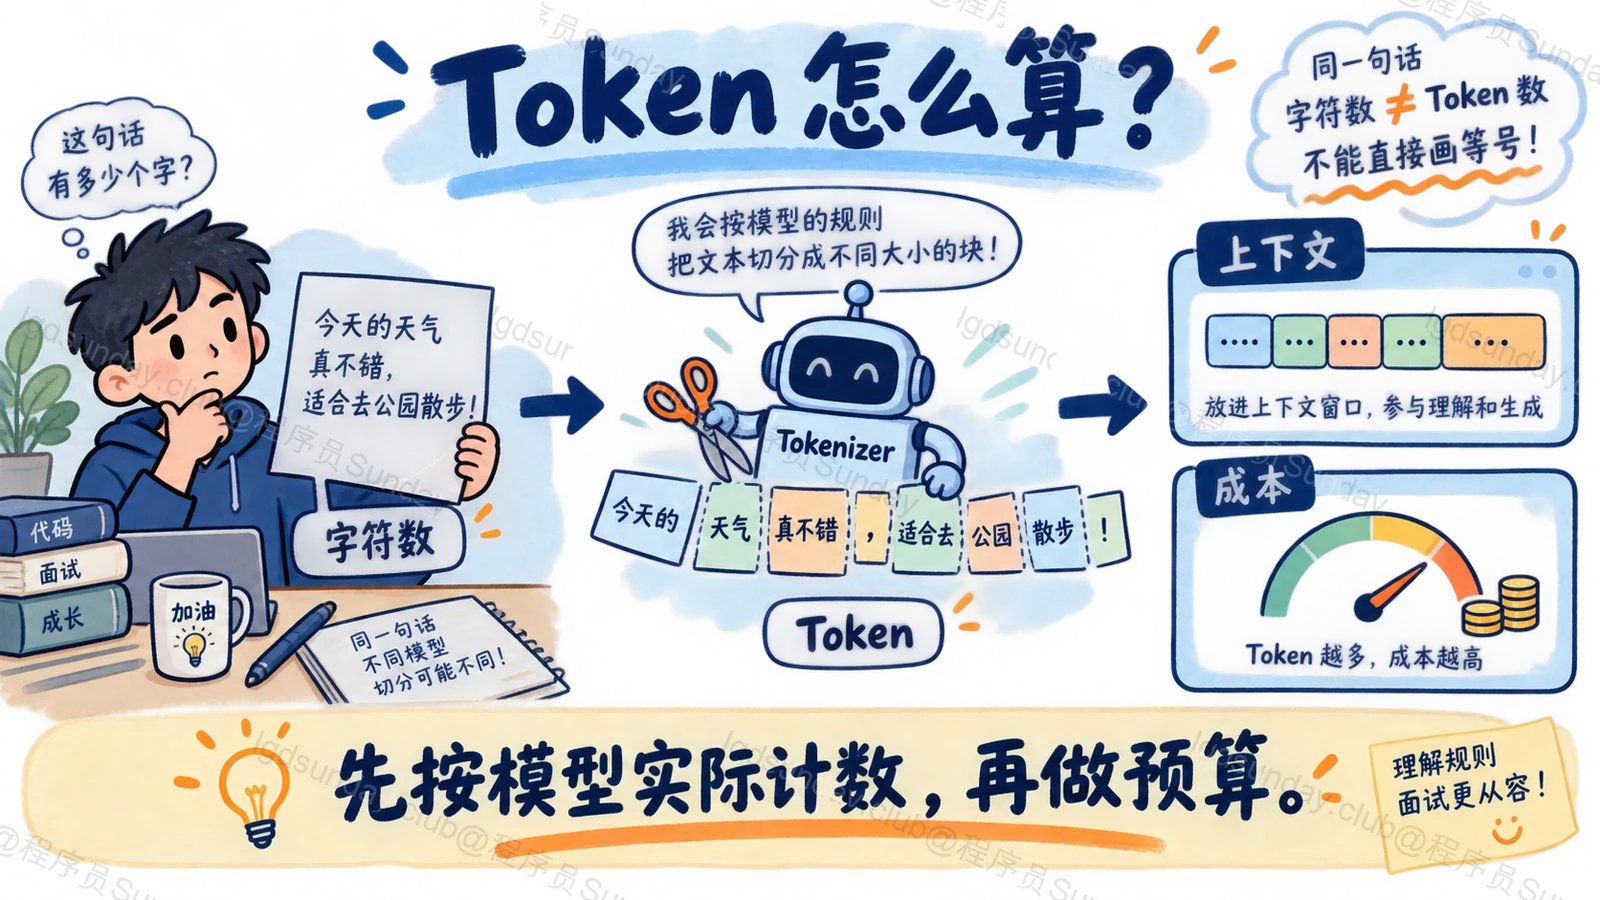
一个“字数限制”为什么不够用
假设我们做一个合同问答。用户只问“违约金怎么算”,输入框里不过几个字,但服务端还把合同条款、过去的对话和工具说明一起送给模型。模型看到的是组合后的请求,不是页面上那一行问题。
而且 Token 的切分由具体模型使用的编码方式决定。中文字符、英文词组、数字串、代码符号不保证相同的字符/Token 比例。图片和文件输入更不能按肉眼看到的字数估计。若产品需要精确拦截,应该用供应商提供的计数能力或与目标模型匹配的 tokenizer;本地估算只能作为近似值。
输入放得下,还要给回答留位置
一次请求的预算至少要考虑模型允许的上下文范围、该接口或模型的输出上限,以及为回答预留的空间。不同模型与接口约束不完全一样,不能把某个型号的窗口大小写成通用常数。
当预算紧张时,先识别哪些内容可以减少:重复的历史消息、与问题无关的检索片段、过长的工具结果。关键指令、权限边界和回答所需证据不能为了省 Token 随便截掉。若任务本来就需要整份长文,应该设计分段处理或检索,而不是假装它能一次完整读完。
成本要按“成功任务”回看
上线后记录请求的输入、输出 Token、缓存命中情况、延迟、模型版本和任务结果。输入多不一定是浪费:为了避免错答,带上必要证据可能是值得的。反过来,一次调用看起来便宜,但因为上下文不够反复重试,单次成功任务反而更贵。
验证时拿一批真实请求比较“发送前预估”和“接口返回 usage”,再看超限率、截断后的答题质量,以及每次成功任务的成本。这样比争论一个固定换算公式有用得多。
面试官继续追问
能不能用“一个汉字约等于一个 Token”快速估算?
可以在早期做量级提醒,但不能据此决定是否允许请求。越接近模型上限,越要对完整请求做准确计数,并留安全余量。
只要上下文窗口很大,输出也能同样长吗?
不能这么推。具体模型通常另有输出限制;还需要看输入与预期输出在接口规则下是否同时容得下。
为什么统计费用要看 usage,而不是回答字数?
费用和处理量不只来自可见回答,输入里的历史、检索材料、工具定义,以及实际生成的输出都可能计入。以服务端返回的用量为准,再按请求与任务维度归因。
面试速记卡
- Token:模型的计量单位,不等于一个汉字或一个英文词。
- 预算对象:数完整请求,不只数用户输入框。
- 留出空间:输入量之外还要考虑输出上限和回答余量。
- 验证方法:发送前计数,发送后用实际 usage 校准。
- 成本口径:看每次成功任务,而不只看单次调用价格。
