
🧑💻 面试官:现在要给 AI 编程助手选一个底层模型。排行榜第一的模型,能直接用吗?
🙋♂️ 我:我会先把它放进候选,但不会只凭排名就接进产品。
🧑💻 面试官:我让两个模型修同一个 Bug。A 不仅给了补丁,还把原因解释得很清楚;B 只交了补丁。你选 A?
🙋♂️ 我:先别急着看解释。得把补丁放回项目里,看看原来的 Bug 修好了没有。否则选出来的,可能只是一个更会写修复报告的模型。
🧑💻 面试官:A 跑通了现有测试,不过它顺手删了一段权限检查。测试刚好没覆盖到这里,还算修好了吗?
🙋♂️ 我:不算。登录跳转是好了,权限却出了问题,这次修复反而带来了更大的风险。不能因为大部分测试通过,就把这种错误算成“总体表现不错”。
🧑💻 面试官:B 没动权限,但单次调用更贵。还有个 C,调用很便宜,只是经常要反复试几轮。你最后怎么选?
🙋♂️ 我:让它们在同一批任务上先过质量要求,再看一次真正被验收的修复,各自花了多少时间和钱。光比 API 单价,算不出这笔账。
面试官真正追问的不是“哪个模型最强”,而是:你打算怎样确认它把活做完了,以及哪些错误绝对不能带进产品。
面试速答(60 秒版)
排行榜可以先看,它能帮我们找几个值得试的模型。但最后选谁,得回到自己的项目里判断。
比如做 AI 编程助手,模型回答“Bug 已修复”不算完成任务。我们要看它交出的补丁能不能解决原问题,改完以后有没有影响别的功能。像权限检查被删掉这种问题,即使其他测试都通过了,也不能放过去。
所以我会从项目里挑一批有代表性的任务,让候选模型在相同的代码、工具和限制下完成。先看修复结果,关键错误单独看;达到要求以后,再比较完成一次任务要等多久、要不要反复重试、人工还得花多少时间检查。
有些简单任务,便宜模型可能已经够用;遇到复杂任务,更强的模型虽然单次贵,做完一件事却未必更贵。这个结论要拿任务测,不能从排行榜或报价单上猜。
知识点详解:选模型,先想清楚你要验收什么
假设用户让 AI 编程助手修一个问题:“登录成功以后,页面有时会跳错。”
模型很快回了一句“已经修复”,还附上了一段像模像样的原因分析。到这里,我们其实什么都还不能确定。要打开它的改动,看它改了哪个文件;把原来的错误复现出来,再看改完以后还会不会发生。
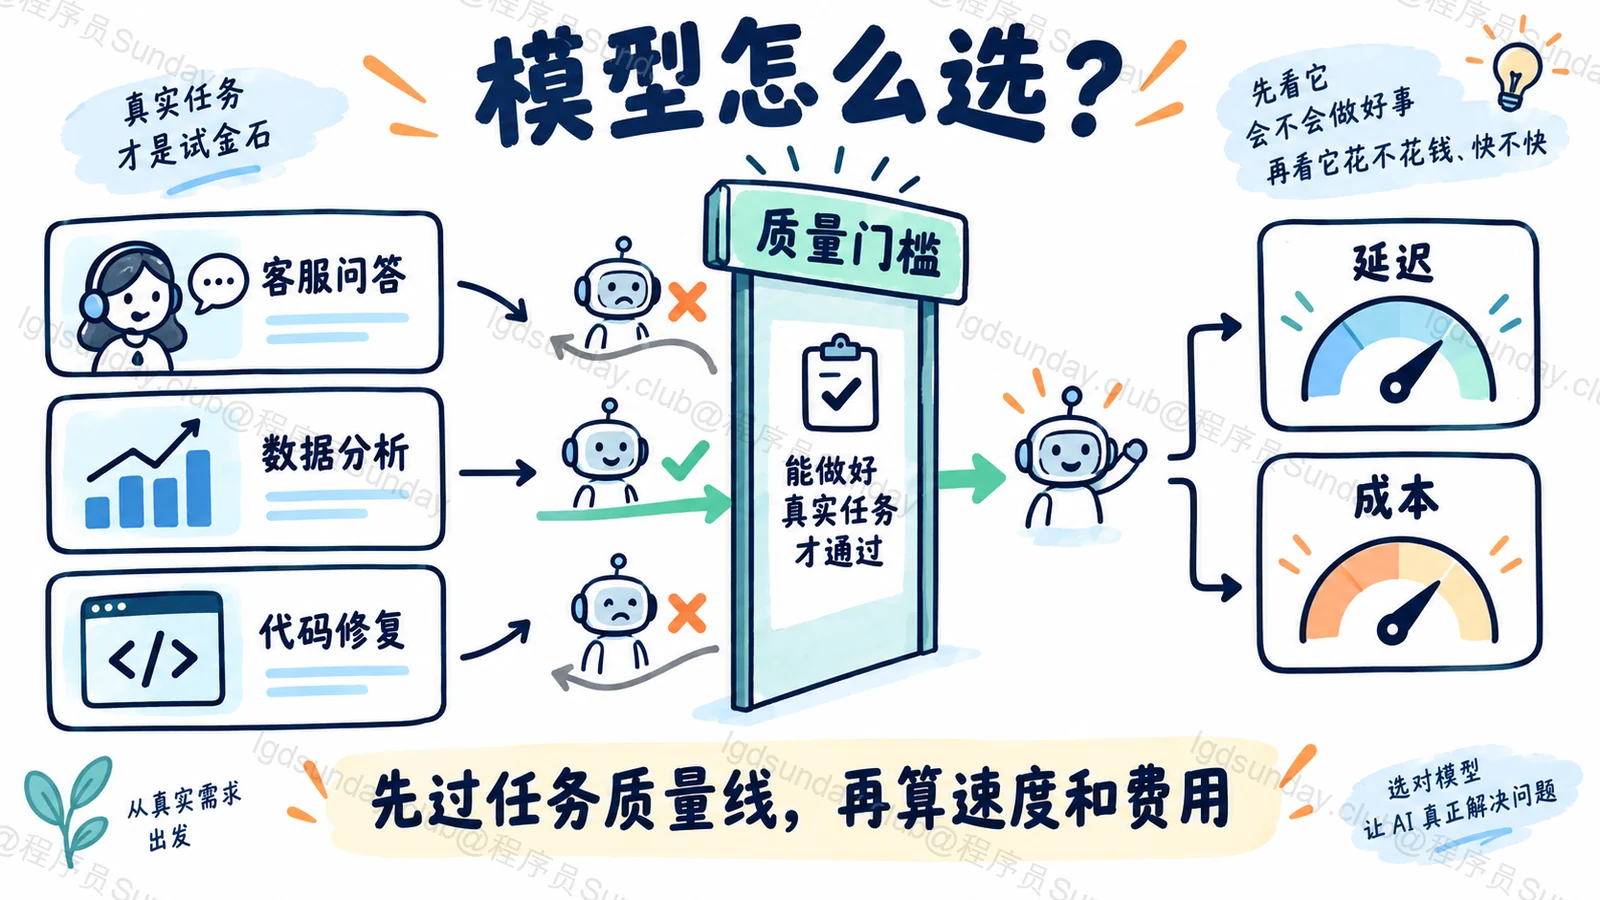
图里把客服问答、数据分析和代码修复分开看,也是这个意思:一个模型在某项任务里能用,不代表换到另一项任务也能用。我们先只看代码修复这件事。
测试通过了,也不一定真修好了
还是刚才那个登录问题。模型为了让页面正常跳转,把路由上的权限检查删了。现有测试如果只覆盖“登录后能进入页面”,它可能一路绿灯;但另一个本来无权访问的用户,现在也能进去了。
这也是为什么选模型时,不能只拿一个“测试通过率”排队。除了检查目标问题有没有解决,还得看它有没有越过修改范围、碰到权限或支付之类的关键逻辑。普通 Bug 没修好,可以退回去重做;权限被改坏,却可能让这个功能根本没法上线。这两类错误不能混在一个平均分里。
那是不是每道题都要准备一份标准补丁,让模型照着写?也不用。同一个 Bug 可以有不同的修法。要验收的是最终行为和改动边界,而不是代码长得像不像参考答案。
评测任务要从自己的项目里找
一份演示用的 Bug,往往太干净了:问题描述清楚,涉及文件不多,运行环境也早已准备好。真实项目未必如此。用户可能只说“刷新后又跳回登录页”,模型得自己找到相关代码;或者同一个登录流程里,不同角色走的是不同页面。
可以从项目里已经解决过的问题挑一些任务,把敏感信息处理掉,保留当时的代码起点、问题描述和复现方法。普通的页面改动要有,容易牵连权限、状态或其他模块的改动也要有。这样测出来的结果,才更接近模型将来接到的活。
比较时还要让候选模型站在同一起点:同一份代码、问题描述、工具权限、执行时间和验收方式。如果 A 能读完整个仓库、运行测试,B 却只能看几段粘贴的代码,最后差距就不全是模型造成的。
而且,这批任务测出来的结果,也只能说明模型适不适合做这些编程任务。如果产品还要做工单分类、文档问答,就得另外测。模型没有一张对所有工作都有效的“总成绩单”。
便宜不便宜,等任务做完再算
我自己平时用编程模型,也会考虑价格。普通的小改动,没有必要每次都开最贵的模型。但如果要给用户做产品,个人觉得“它用着还行”就不够了。
假设便宜模型修一个问题要试三次,期间每次都要重新读代码、运行测试,还得让人检查哪一版终于能用。另一个模型单次贵一点,却能更快交出可接受的补丁。只看每次调用的报价,便宜模型看上去占优;算到任务真正完成,结果可能反过来。
给每个被接受的补丁算总账时,模型调用、失败重试、等待和人工验收都要算进去。尤其别把那些没修好的任务从账单里删掉。选定以后也别一次全部切换:先让一部分任务使用新模型,看看它在真实请求里还会犯什么错,必要时退回旧方案。
面试官继续追问
项目本来就没多少测试,怎么评测模型?
至少先给选出来的任务补上复现方法和关键行为的检查。测试补不全时,就需要人工看补丁有没有改到不该碰的地方,尤其是权限、金额和数据写入。没有办法验收的高风险改动,不应该仅凭模型一句“已完成”就自动合并。
一个模型修得对,但用户要等很久,怎么办?
这得看产品承诺的是什么。如果用户正在编辑器里等一个即时建议,太慢确实会影响使用;如果是让助手在后台处理一个复杂问题,允许等待的时间就不同。可以先减少无关输入、调整产品的等待方式,再看是否需要换候选模型。但不能为了让进度条走得快,就把关键错误更容易发生的模型接上去。
新模型的榜单成绩更高,要不要立刻替换旧模型?
不用急。拿原来的任务集重新跑一遍,尤其看旧模型曾经犯过的错有没有回来,再用少量真实任务观察延迟、成本和新坏例子。等它在我们这里也表现得更好,才有切换的理由。
面试速记卡
- 排行榜:用来找候选,不替项目决定最终选谁。
- 验收对象:看模型交付的结果,不看它怎样宣称“已完成”。
- 质量门槛:关键错误单独拦,不能让平均通过率盖过去。
- 公平比较:相同任务、代码起点、工具权限和验收方式。
- 成本:算一次被验收的任务,而不只看单次调用报价。
