
🧑💻 面试官:你做一个合同问答系统。条款写着“提前解约需付违约金”,下一段又写“供应商未达服务标准时除外”。你把文档每 100 字切一块,检索命中了前一句,回答却漏了例外。怎么办?
🙋♂️ 我:这不是简单的“检索没命中”。切片把主规则和例外拆开了,单个命中片段不足以支持回答。我会先按条款或段落结构切,再看是否需要把相邻片段或父条款一起带回来。
🧑💻 面试官:那切得越大,不就越不容易拆散条件?
🙋♂️ 我:大块确实更容易保留上下文,但也会带来噪声和成本。比如一个块里混了三种解约情形,检索可能命中“解约”,模型却不容易分清哪种适用。
🧑💻 面试官:到底选 200 字、500 字还是 1000 字?
🙋♂️ 我:不能脱离文档结构和用户问题给固定数字。先拿真实文档和标注问题做几组切片实验,比较“能否找回完整证据”“最终回答是否正确”,再看索引量和输入成本。
这题的关键是:切片不是为了把文档切得整齐,而是要让一次检索能带回足以回答问题的证据单元。
面试速答(60 秒版)
RAG 切片不是越小越好。小块通常更聚焦,检索时容易定位到某句话,但可能把主规则、前提和例外拆开;大块能保留更多上下文,却可能混入无关内容,增加重排和模型输入的负担。
我会先看资料类型:合同、制度、技术文档有天然的章节和条款边界,优先按这些结构切;对没有明显结构的文本,再试固定长度和适度重叠。如果检索需要小块精确命中,但回答又需要完整条款,可以“用小块找,再带回它所属的大段或相邻片段”,同时保留来源和版本。
尺寸不能拍脑袋定。准备一批带有答案依据的真实问题,对比不同切法的召回、证据完整度、回答正确性、延迟和成本。最后选的不是某个通用数字,而是在当前资料和问法下更稳的方案。
知识点详解:Chunk Size 到底在交换什么?
小块为什么会把答案切坏
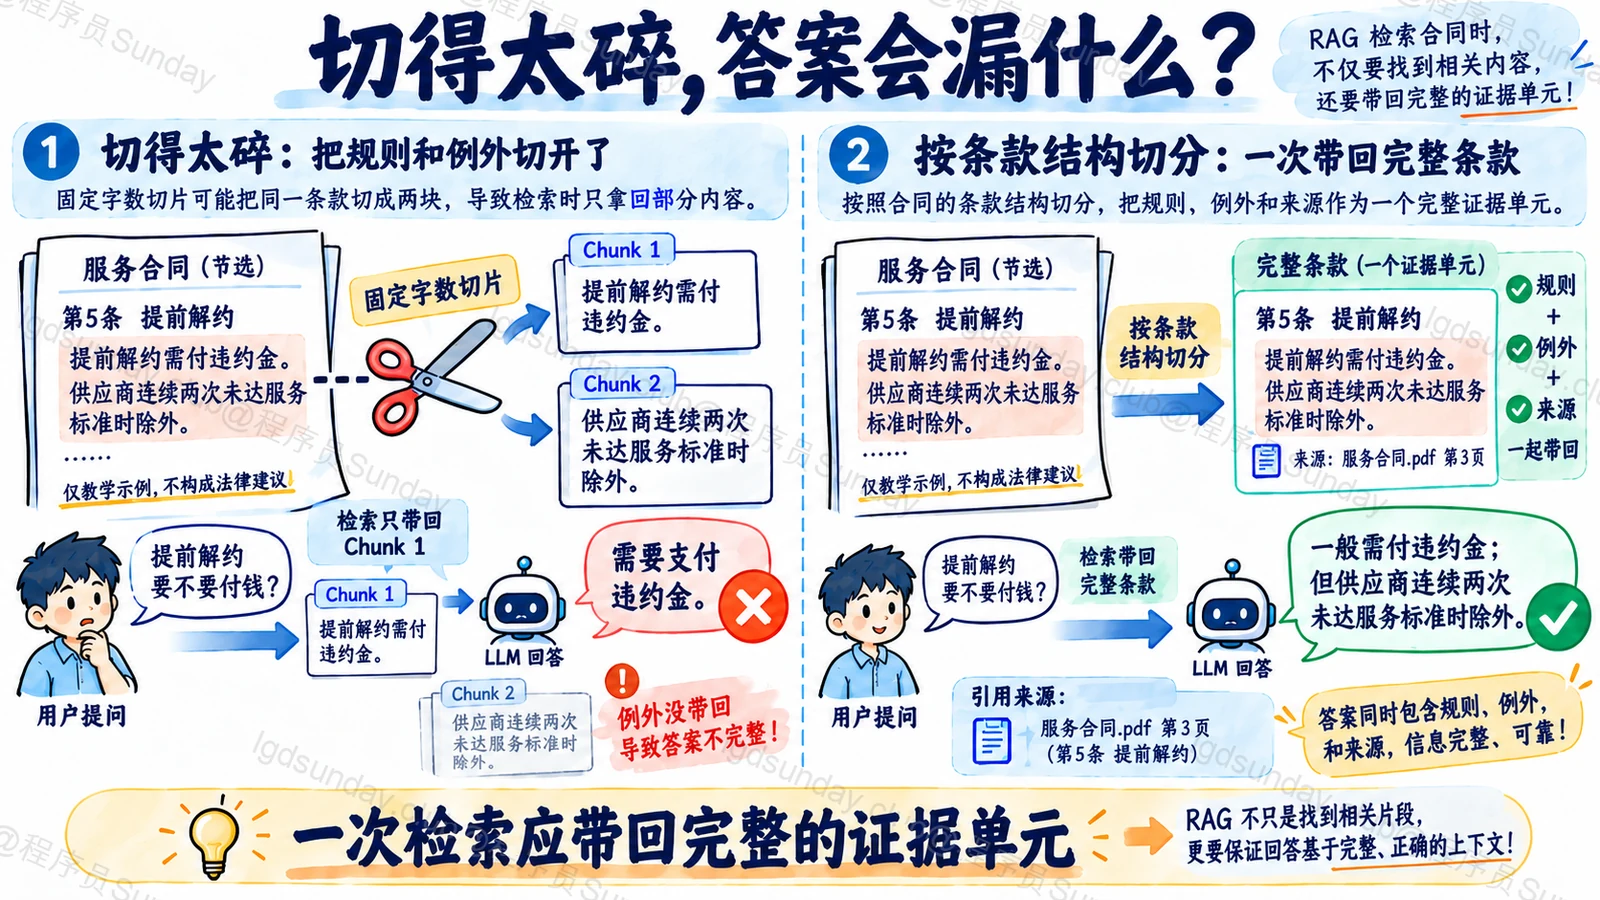
还是前面的合同。主条款说“提前解约需付违约金”,例外段说“供应商连续两次未达服务标准时可以免除”。这份合同是教学假设。
如果机器每隔固定字数切一下,主条款与例外可能落到不同 Chunk。用户问“供应商违约,我提前解约要付钱吗”,检索只带回第一块,模型得到的信息就是不完整的。它答错不一定是生成模型“不听话”,也可能是切片阶段已经把完整条件拆散。
适度重叠能缓解边界处的断句,但不能保证解决跨段落、跨页或引用其他条款的关系。对有结构的资料,更值得先利用标题、条款编号、段落和表格边界,让一块内容尽量表达一个相对完整的意思。
大块也不是免费午餐
把整章合同塞成一个 Chunk,主规则和例外大概率都在,可检索结果会更宽泛。它可能同时包含履约、付款、解约三类规定。用户问具体违约金,命中这大块以后,模型仍需要从大量无关文字中定位正确条件;而且每次回答都把整章送入模型,会占用更多上下文和成本。
所以切片大小影响两件事:检索时能不能精准找到相关位置,以及找到以后带给模型的证据是否完整。这两件事有时方向相反。
一个常用思路是分离“检索单元”和“回答单元”:用短片段做精确匹配,命中后回溯它所属的完整条款或父段落,再交给模型。这样也不是万能的。如果父段太大、权限不同或版本混杂,仍要过滤和裁剪。
不是只调一个数字
Chunk Size 通常还和重叠长度、文档解析质量、标题元数据、检索方式和重排一起作用。扫描 PDF 如果解析出错,调 Chunk Size 不会让缺失的表格回来;新旧版混在同一索引里,改切片大小也不会自动解决版本适用。
做实验时,我会先固定一组文档和问题,给每题标出支持答案的原文位置。然后试几种切法:结构化段落、固定长度及不同重叠、短块检索后回溯父条款。比较目标依据是否被找回、例外是否完整、最终答案有没有漏条件,并记录索引量、延迟和输入 Token。按问题类型分组看结果,避免整体平均分掩盖合同例外类错误。
面试官继续追问
加大 Overlap,能不能解决所有切片边界问题?
不能。相邻两块重叠能补一部分断句,却可能增加索引量和重复证据;跨章节的适用条件仍可能离得很远。结构化切分和父子回溯更适合这类关系。
检索命中了条款,为什么还要看最终回答?
命中只能说明某个片段被找到。要看主规则、例外和适用条件是否一起进入模型输入,以及模型最后有没有按这些材料答对。这和 Q009 的证据使用问题相连,但本题重点是切片设计。
知识库里既有 FAQ 又有长合同,用一个 Chunk Size 吗?
不建议强求。FAQ 的问答对可能天然就是一个单元;合同应按条款与条件切。可以按文档类型采用不同策略,再用同一批业务问题比较结果。
面试速记卡
- 小块:定位更细,但容易拆散主规则与例外。
- 大块:上下文更全,但噪声、成本和定位难度可能上升。
- 优先边界:按标题、条款和段落切,不只看固定字数。
- 折中做法:小块检索,再带回完整父条款或相邻证据。
- 选型依据:用标注问题比较证据完整度、答案质量、延迟与成本。
