
🧑💻 面试官:公司想微调一个大模型,但训练资源不多。你知道 LoRA 吗?
🙋♂️ 我:知道。它不用更新模型的全部参数,只训练少量新增参数,所以训练成本会低一些。
🧑💻 面试官:原来的参数都不动,模型为什么还能改变回答?
🙋♂️ 我:新增参数会参与计算,相当于给原来的计算结果加一部分调整。
🧑💻 面试官:那是不是训练完以后,只保留这部分小参数就能运行?基础模型那么大,可以不要了吗?
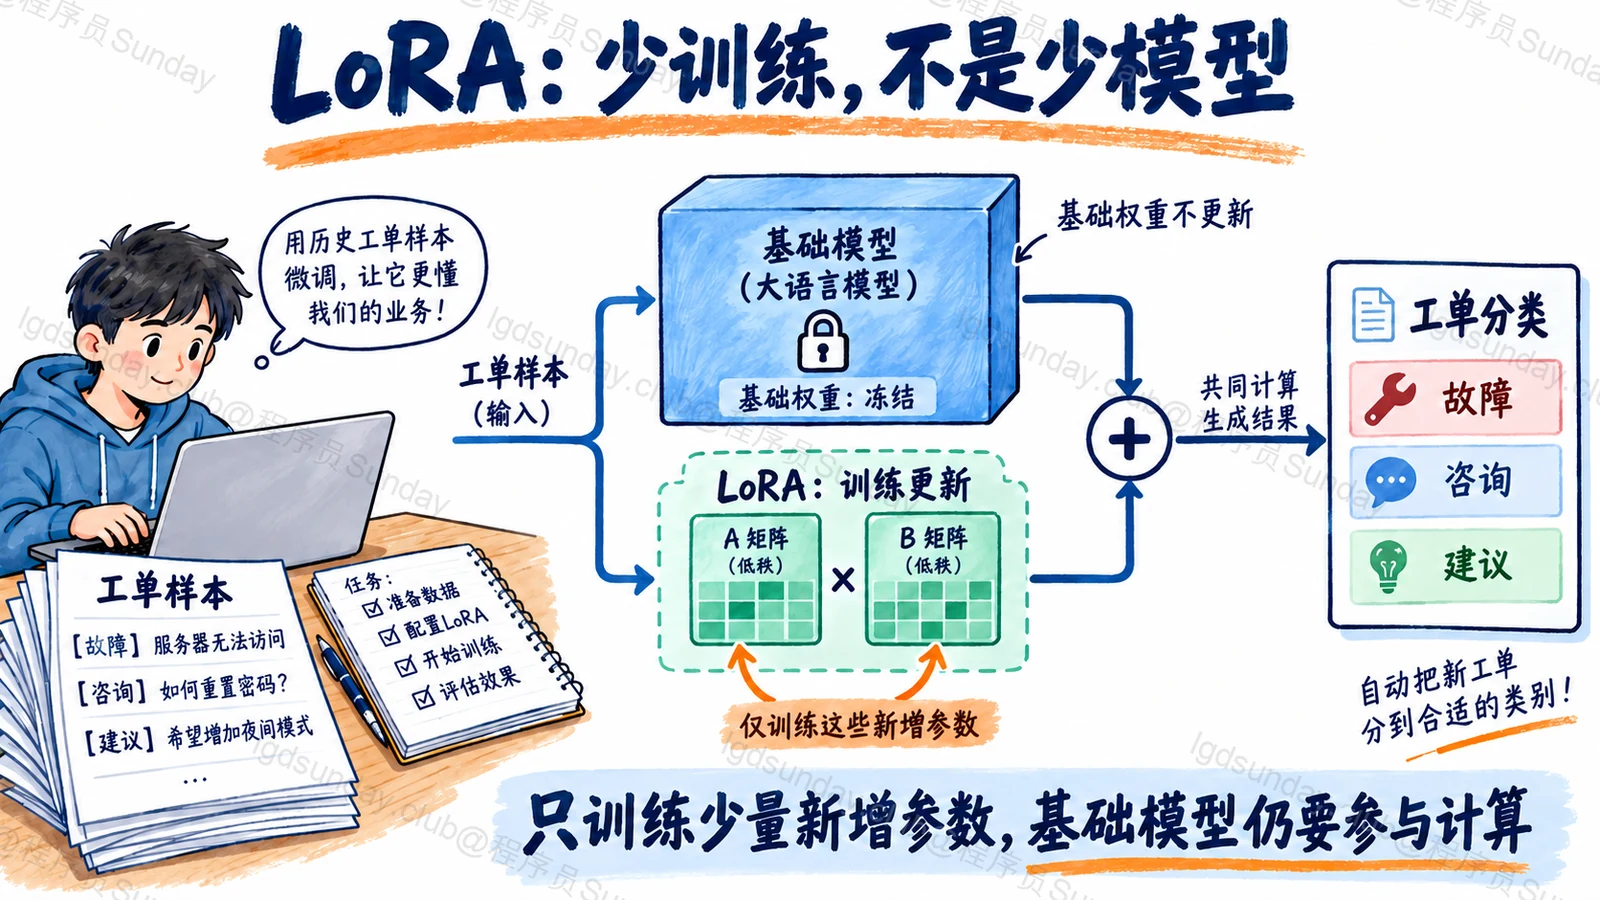
LoRA 要分清两件事:训练时哪些参数需要更新,运行时又需要哪些参数参与计算。少训练,不等于基础模型可以不要。
面试速答(60 秒版)
LoRA 是一种参数高效微调方法。它保留基础模型已有的权重,在选定的层旁边加入少量可训练参数,用这部分参数学习任务需要的调整。
具体来说,原来一个很大的权重改变量,会用两个较小矩阵的乘积来表示。训练时主要更新这两个小矩阵,基础权重保持不变,因此能减少需要训练的参数,以及这部分参数对应的梯度和优化器状态。
例如,我们希望模型按照公司的标准给工单分类,就可以用核对过的工单样本训练 LoRA,再用没参与训练的数据检查效果。
不过,LoRA 没有把基础模型变成一个小模型。运行时仍然需要基础权重,只是可以另外加载适配器,或者在支持的情况下把更新合并进去。它是否适合项目,还要看数据质量、任务效果和部署成本,不能只比较适配器文件有多小。
知识点详解:原来的权重不改,新的任务怎么学?
先看全量微调在改什么
假设咱们要做一个工单分类助手,把用户提交的内容分成“故障”“使用咨询”和“功能建议”。
基础模型理解这些词,但不一定符合公司的划分标准。比如“我想增加一个批量导出按钮”,应该归为功能建议;“批量导出按钮点了没反应”,才是故障。
准备好工单和正确类别以后,可以继续训练模型,让它逐渐适应这套标准。
如果采用全量微调,就会更新参与训练的全部模型参数。参数很多,训练时除了存放权重,还要处理梯度和优化器状态,所需资源就比较多。
LoRA 换了一个做法:原来的大部分基础权重先固定住,只让一小部分新增参数接受训练。基础模型原有的能力仍然参与计算,新增参数负责学习这次任务的调整。LoRA 原始论文提出的就是这种低秩更新方式。
两个小矩阵,怎样改变一个大矩阵?
假设模型中有一个权重矩阵叫 W。微调之后,我们希望它变成“原来的 W,加上一份调整”。
这份调整通常写成 ΔW。
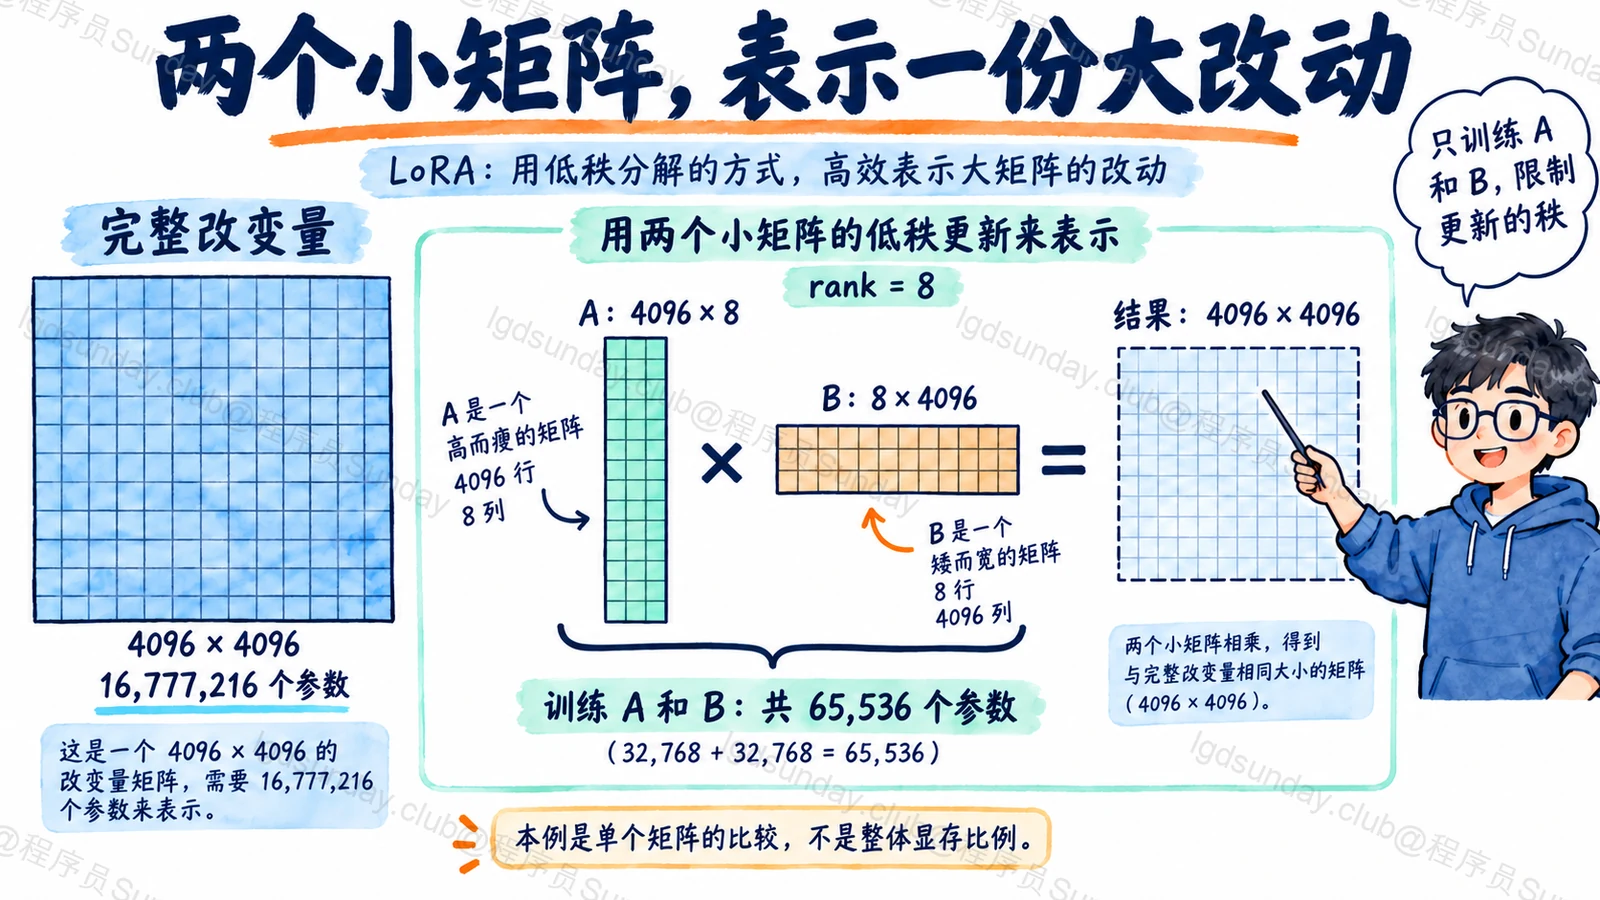
LoRA 不直接训练完整的 ΔW,而是用两个较小矩阵相乘来表示它。为了方便理解,这里把它们命名为 A 和 B,暂时省略缩放系数:
新的权重效果 = W + A × B
注意,这里的 A、B 命名只是本例约定,不同资料可能用相反的字母顺序。关键在于矩阵维度能对应上。
假设 W 的大小是 4096 × 4096,选择的秩,也就是 rank,为 8:
| 要学习的内容 | 矩阵大小 | 参数数量 |
|---|---|---|
| 直接学习完整改变量 | 4096 × 4096 | 16,777,216 |
| LoRA 的 A | 4096 × 8 | 32,768 |
| LoRA 的 B | 8 × 4096 | 32,768 |
A 和 B 一共只有 65,536 个参数,是这个完整改变量参数量的 1/256。两个矩阵相乘以后,结果仍然是 4096 × 4096,可以和 W 对应。
少的是这份调整的可训练参数,不是把 W 删掉了。 这个比例也只针对表里的一个矩阵,不能直接说整个训练显存降低到了 1/256。基础权重、激活和其他开销仍然存在。
为什么这样也能学到东西?
因为模型原本就已经有大量能力,我们不一定需要把每个参数都重新调整一遍,才能适应一个具体任务。
以工单分类为例,模型已经理解“按钮”“没反应”“增加功能”这些表达。训练要改善的,是遇到这些组合时,更符合公司的分类方式。
LoRA 对调整方式加了一个限制:通过低秩矩阵来表达变化。这样可以减少训练参数,但也限制了它能表达的改变量。它不是一个“再复杂的任务都能用很小 rank 搞定”的保证。
选哪些层加入 LoRA,也会影响结果。rank 和 target_modules 都是实际训练时需要配置的内容;具体模块名还取决于模型结构。PEFT 文档提供了这些配置入口。
因此,训练完不能只看训练集分类得多准。要另外留一批工单,尤其是“既像故障又像咨询”的边界例子,看它是否学到了标准,而不是记住样本措辞。
训练产物很小,部署时为什么仍然要大模型?
如果保存的是 LoRA 适配器,里面主要是新增参数和相关配置。单独拿着它,就像只拿到了“要改哪些地方”,基础计算还没准备好,自然不能独立完成任务。
部署时,一种做法是加载匹配的基础模型,再加载对应适配器。这样切换不同任务的适配器比较方便,但推理系统要支持这种组合。
另一种做法,是在模型、精度和工具链支持的情况下,把更新合并到基础权重里。合并后按普通权重运行,不再单独走这条适配器计算路径。
两种方式都要记录基础模型的具体版本。拿同一个名字下不同版本的权重随意拼接,不能因为维度对得上,就当结果一定正确。
项目验收时,除了分类效果,还应保留一组原有能力测试。新任务做得更好了,却把原本正常的回答能力明显改坏,也需要在上线之前发现。
面试官继续追问
rank 越大,效果是不是越好?
更大的 rank 能表达更多变化,也会增加可训练参数和资源需求,但不保证验证集效果更好。
数据量不大、标签还不统一时,先把 rank 往上加,可能只是更容易拟合这些样本。可以从资源允许的几组配置开始,对比同一验证集,而不是只看训练损失。
LoRA 和 QLoRA 是一回事吗?
不是。LoRA 解决的是怎样用低秩更新减少可训练参数;QLoRA 还结合了低比特量化的基础模型,进一步减少基础权重的存储开销。训练时仍然主要学习适配器参数,不是简单地把所有参数都改成低比特后直接全量训练。PEFT 量化指南说明了这类组合。
公司制度经常更新,应该反复训练 LoRA 吗?
先看需求。如果只是让助手查到最新制度,RAG 通常更容易更新和追溯。LoRA 可以用于改善模型按规则分类、提取或回答的表现,但不适合被当成一份随时能精确修改的制度表。
面试速记卡
- LoRA:冻结基础权重,训练低秩更新参数。
- 核心机制:用两个小矩阵的乘积表示较大的权重改变量。
- 节省范围:减少可训练参数及相关训练开销,不等于整体显存同比缩小。
- 部署要求:适配器仍依赖匹配的基础模型,也可按支持情况合并权重。
- 效果判断:用独立任务样本验证,不能只看训练损失和文件大小。
