
🧑💻 面试官:线上每个请求都用最强的模型,效果不是最稳吗?
🙋♂️ 我:质量可能更稳,但简单问题也付出更高的延迟和成本。可以让轻模型处理稳定、可验证的任务,把复杂任务交给强模型。
🧑💻 面试官:关键词里出现“退款”就走强模型,没出现就走轻模型,够不够?
🙋♂️ 我:不够。真正困难的可能是跨条款推理或例外判断,未必有固定关键词。路由本身也要用标注任务集评测。
🧑💻 面试官:路由错了怎么办?
🙋♂️ 我:对低置信度、高风险或轻模型校验失败的请求,回退强模型或人工。既要量化节省的成本,也要量化错路由带来的质量损失。
模型路由的目标不是“尽量多用小模型”,而是在质量门槛内少花不必要的成本。
面试速答(60 秒版)
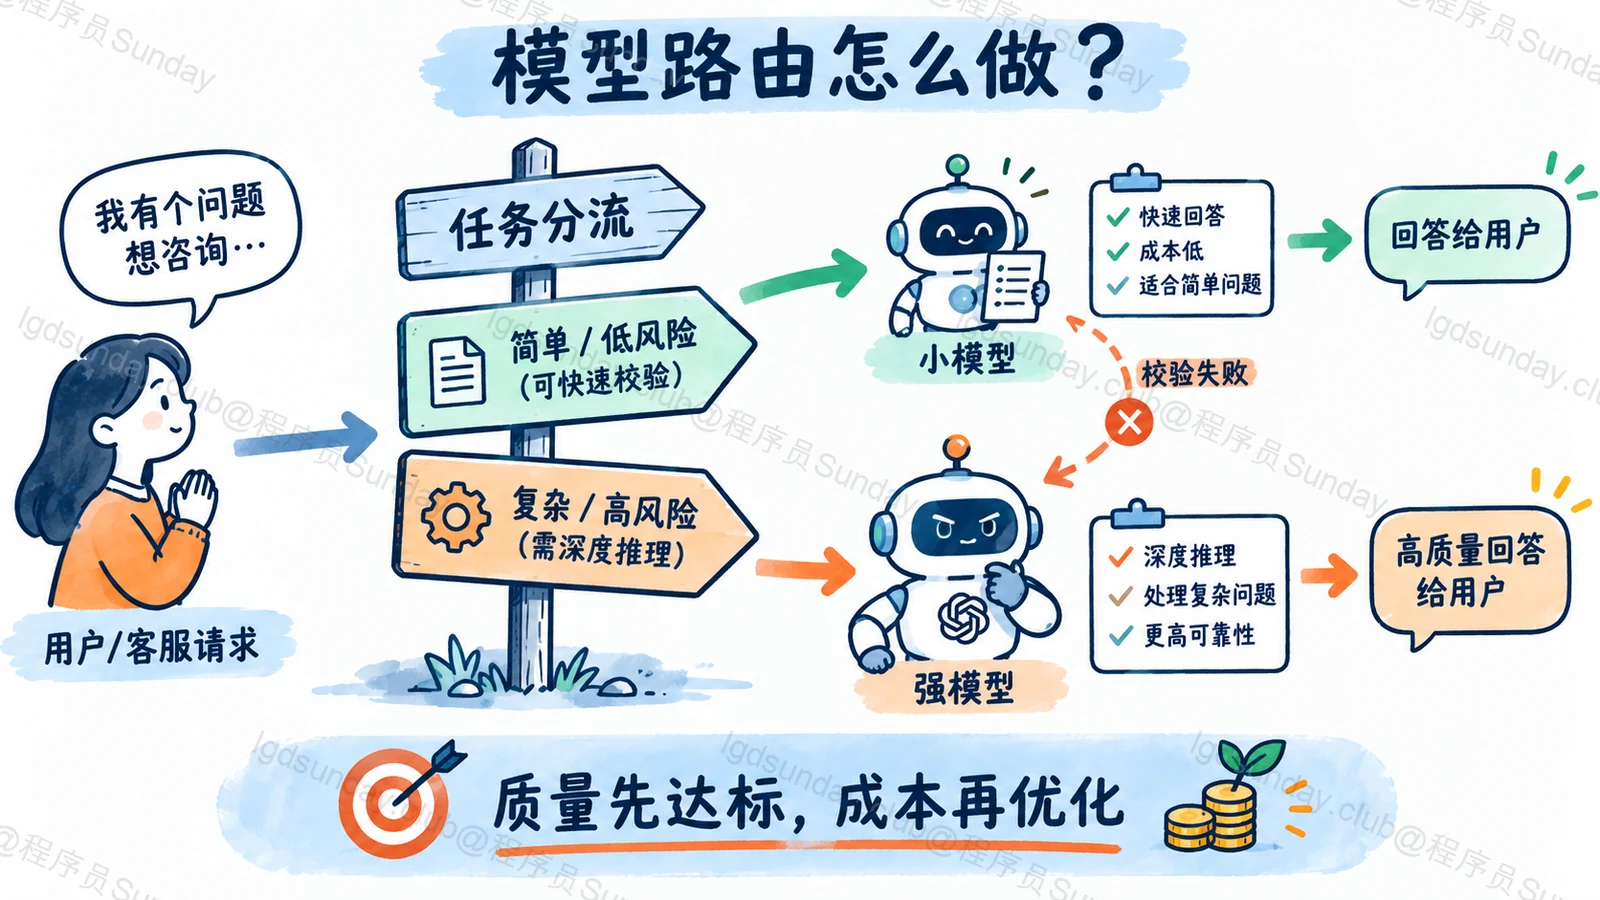
模型路由就是根据任务难度、风险、时延要求等,把请求交给不同模型处理。比如格式固定的意图分类可先试轻模型;跨多个条款推理、需要复杂工具规划的请求,交给更强模型。
做法不是凭感觉写一堆关键词规则。我会先用真实请求建立评测集,找出轻模型可以稳定完成的任务类型,再设计路由和回退条件。轻模型结果如果缺关键字段、校验失败或置信度不足,就升级处理;高风险任务可以直接走强模型或人工审核。
验收时看整体任务正确率、误路由率、延迟和成本。若省了调用费,却让重要请求答错,路由没有成功。
知识点详解:路由器本身也会犯错
为什么不能“一模到底”
假设一个客服系统既要识别“查询订单状态”,又要解释复杂退款例外。两类请求对模型能力的要求不同。全部用强模型会浪费;全部用轻模型又可能在例外条件上失误。路由把这种差异显式化。
但路由不是看一句话长短。短问题可能需要复杂推理,长问题也可能只是简单抽取。应该根据任务标签、历史表现和业务风险设计,而不是只用表面词数判断。
怎样给轻模型划定范围
先收集一批真实请求,标注任务类型、正确答案和风险级别。分别让候选模型处理,找出轻模型稳定通过的子集。能用程序校验的任务尤其适合先走轻模型,例如固定字段提取后验证字段完整性。
线上可使用规则或分类器做第一层路由,但要保留兜底:输入超出已验证分布、输出校验失败或涉及高风险决策,就升级强模型或人工。升级条件要能解释、能记录。
怎样证明路由划算
离线比较同一批请求在“全部强模型”和“路由方案”下的答案质量、耗时与成本;线上小流量灰度,监测升级率和用户反馈。特别要看“本该升级却没升级”的误路由,而不只看平均账单。
路由策略会随模型版本、价格和真实流量改变而失效。因此路由规则与评测集也要版本化,不能上线一次就永久不管。
面试官继续追问
让轻模型自己说“我有信心”,就能决定不升级吗?
不能直接信。自报置信度需要在任务集上校准,最好再结合结构校验、证据检查和任务风险。
强模型也答错怎么办?
升级是提高能力,不是保证正确。关键结果仍要用业务规则、证据或人工确认约束。
为什么要分开看路由成本和任务成本?
路由器本身也消耗时间和费用。如果分类开销大于节省,整体收益可能为负。
面试速记卡
- 目标:质量达标前提下减少无谓成本和延迟。
- 依据:真实任务集,不只看关键词或字数。
- 回退:低置信度、校验失败、高风险请求升级。
- 指标:质量、误路由、延迟、成本一起看。
- 维护:模型和流量变了,路由规则要重测。
