
🧑💻 面试官:我们做企业知识助手,A 公司和 B 公司共用一套服务。向量检索加 tenant_id 过滤,是不是就隔离好了?
🙋♂️ 我:还不够。聊天会话、文件下载、检索缓存、答案缓存和工具调用都可能绕开这一个过滤点。
🧑💻 面试官:那客户端请求里带上 tenant_id,各层照着传?
🙋♂️ 我:租户身份要从已认证的用户和服务端授权关系里确定,不能信客户端随意传入的 ID。访问每个对象时还要检查它是否属于这个租户。
🧑💻 面试官:检索确实只拿了 A 的片段,但 A 用户点引用链接却打开 B 的文件,问题在哪?
🙋♂️ 我:文件下载接口没有做对象级授权。RAG 链路每一跳都要守同一条边界,不能只在向量查询时守一次。
多租户隔离不是某个数据库条件,而是一条从身份到回答、引用和缓存都不能断的约束。
面试速答(60 秒版)
多租户 AI 应用要把租户范围作为服务端确认的安全上下文,贯穿聊天会话、上传文件、解析片段、向量检索、工具调用、答案缓存和引用下载。不能相信客户端传来的 tenant_id,更不能只靠提示词告诉模型“不要泄露别家数据”。
每次访问具体对象,都要检查用户是否有权访问这个会话、文件或片段。检索时按租户和文档权限过滤;返回引用时,下载接口仍要重新授权;缓存键也要包含决定可见范围的身份、权限和版本因素。
验收时用 A、B 两个租户做交叉测试:改会话 ID、文件 ID、检索条件和缓存命中路径,确认任何一条都拿不到对方内容。只测“正常提问能答对”远远不够。
知识点详解:为什么一个 tenant_id 过滤条件守不住全链路
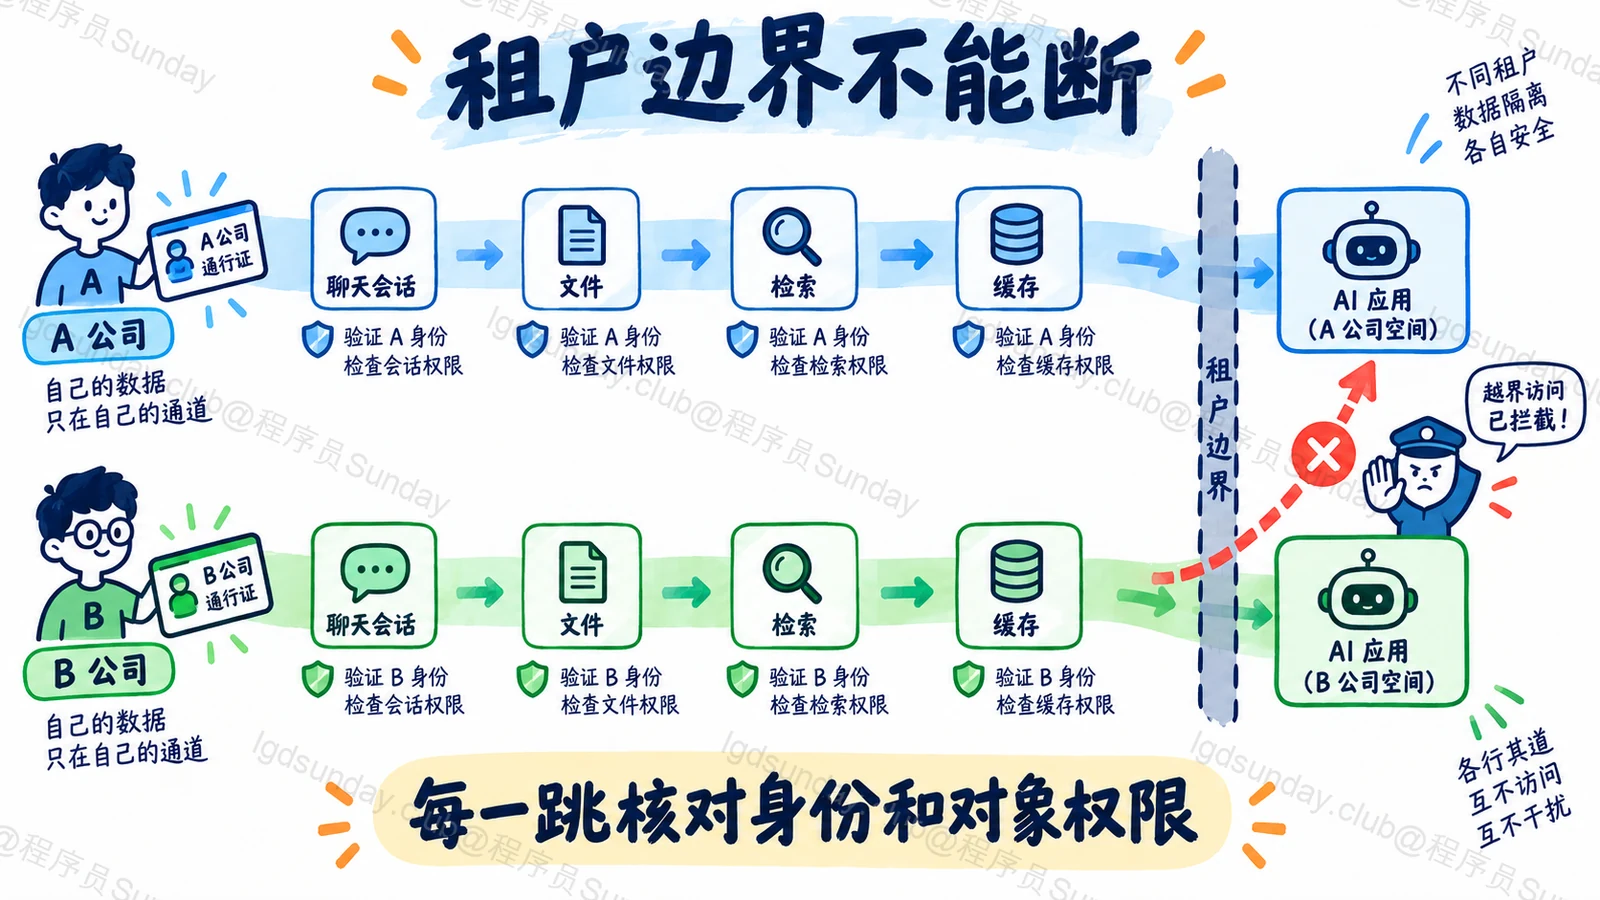
身份必须来自服务端可信上下文
用户登录后,服务端根据身份和组织成员关系确定可访问的租户。若直接接受请求体里的 tenant_id,攻击者把 A 改成 B,就可能让后续检索走错范围。
即使前端隐藏了这个字段,也不能当安全措施。服务端应在每次对象访问时核对归属,比如会话记录是否属于该用户和租户,文件是否允许该成员查看。
检索、引用、缓存都可能漏
向量库里的片段加租户元数据并过滤,是必要的一层。但答案还可能引用原文件 URL;若下载接口只凭文件 ID 返回内容,B 文件仍会暴露。工具读取业务数据时也要用同一身份上下文,不应直接执行模型生成的对象 ID。
缓存尤其容易被忽略。A、B 都问“今年销售额是多少”,若答案缓存只用问题文本作键,B 可能拿到 A 的旧答案。缓存键必须包含权限范围和相关数据版本,或者对私有结果不做跨用户复用。
用故意“串线”的测试证明隔离有效
准备两个租户各自的文件、会话和相同问法。尝试替换会话 ID、文件 ID,构造相同缓存键,测试用户权限变更后的访问。检查最终回答、引用、工具返回和日志记录,确认既没有直接泄露,也没有把对方内容带进模型上下文。
若有管理员跨租户能力,应单独定义授权和审计,不能把它当成普通用户路径中的例外分支。隔离的核心是每一跳都能回答“这个人现在能访问这个对象吗”。
面试官继续追问
向量库按租户建独立索引,是不是就不用授权了?
仍要授权。谁可以查询这个索引、下载对应文件、调用相关工具,都需要服务端检查。
用户从 A 公司离职后,旧聊天还能看吗?
要根据当前权限重新判断,不能因为会话创建时有权就永久可见。缓存和引用也要跟着失效。
把租户 ID 写进系统提示词有用吗?
可作为上下文,但不能替代后端过滤和对象级授权。模型不是权限系统。
面试速记卡
- 身份:服务端确认租户,不能信客户端 ID。
- 链路:会话、文件、检索、工具、缓存、引用逐跳检查。
- 缓存:私有答案不能按问题文本跨租户复用。
- 变更:撤权后旧会话和引用也要受当前权限约束。
- 验收:做跨租户对象替换与缓存串线测试。
