
🧑💻 面试官:ReAct 和 CoT 有什么区别?
🙋♂️ 我:CoT 会把问题分成几步来推理,ReAct 还会在推理过程中调用工具。
🧑💻 面试官:模型写了一段“我准备查询监控”,这就算调用过工具了吗?
🙋♂️ 我:不算。应用还需要执行查询,把结果交回模型。
🧑💻 面试官:如果工具返回的结果和模型最初的判断相反,它应该继续原计划,还是调整下一步?这一步才是 ReAct 的作用吗?
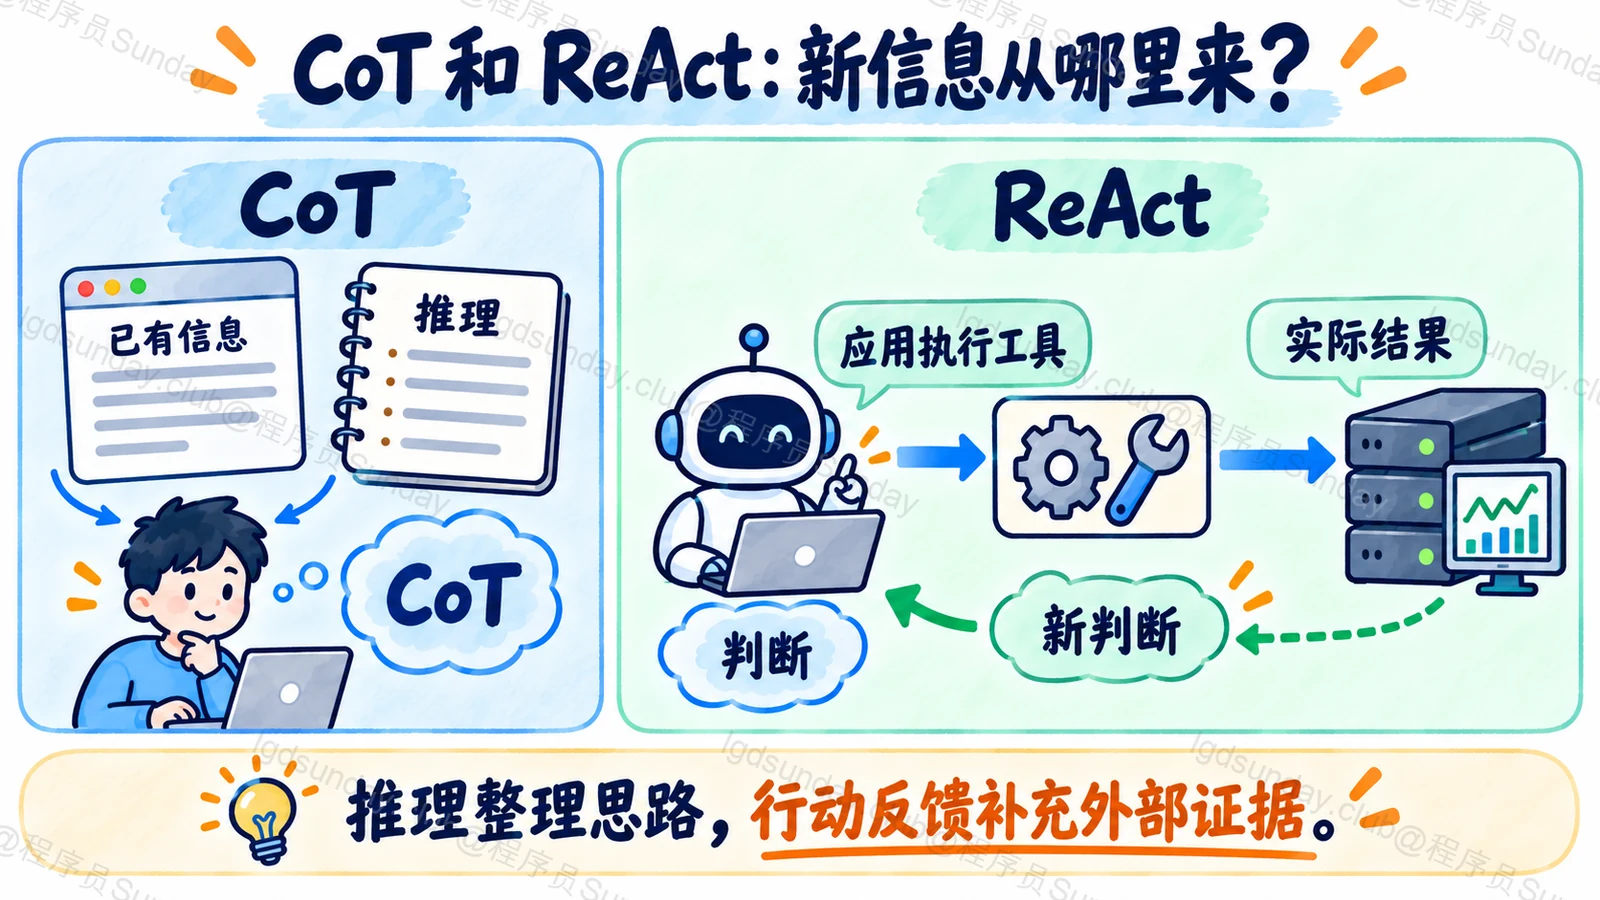
抓住「新信息从哪里来」:CoT 可以在已有信息上继续推理,ReAct 则把实际行动得到的反馈带回下一轮判断。
面试速答(60 秒版)
CoT,也就是思维链,主要是让模型通过中间推理步骤来解决问题。它本身不要求连接工具,也不保证能拿到新的外部信息。
ReAct 则把推理和行动交替安排。模型根据当前信息决定做什么,应用执行工具,把实际结果交回来,模型再判断下一步。
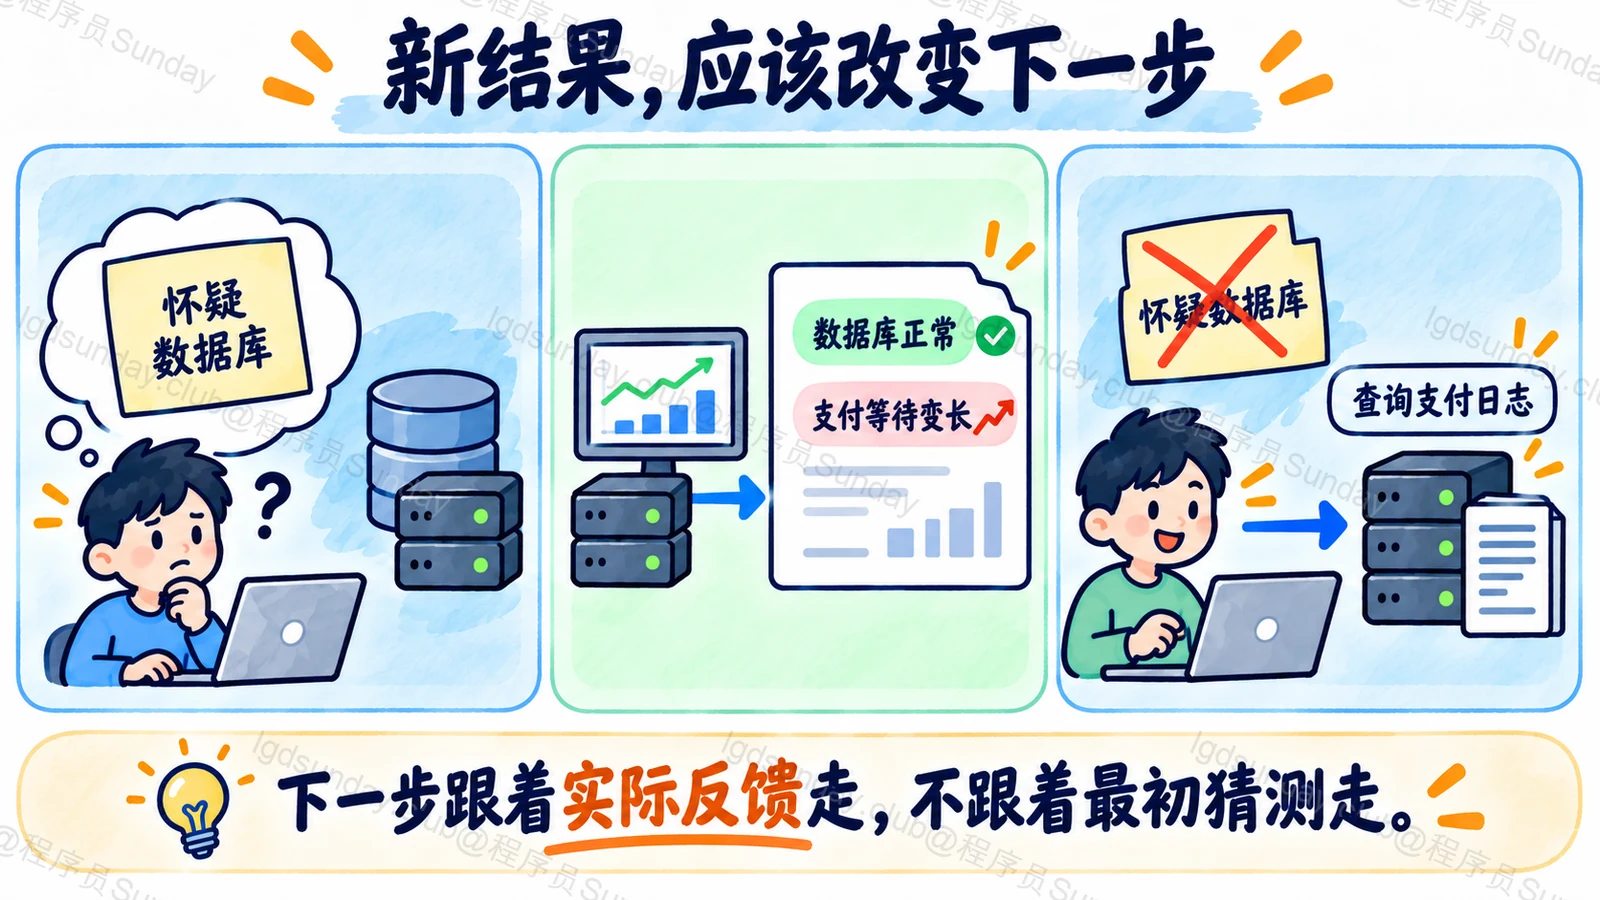
例如排查接口变慢,模型光推测“可能是数据库问题”,仍然只是推理;查询监控以后发现数据库耗时正常,它再转去检查外部接口,这才体现了反馈对行动的影响。
因此,写了很多推理步骤不等于做好 Agent,调用了一次工具也不必然是 ReAct。重点是模型能不能利用实际反馈调整行动。同时,权限、步数和停止条件仍然要由应用控制。
知识点详解:推理怎样和实际行动接起来?
CoT 能帮助推理,但不会凭空增加证据
假设咱们要判断订单接口为什么变慢。已知的信息只有一句:“最近半小时,响应时间明显升高。”
模型可以据此列出数据库、缓存、网络等可能原因,再逐个分析。这样的推理有用,它能帮我们整理检查方向。但是,写到第三步时,它并没有自动获得第三份监控数据。
如果输入里没有数据库耗时,模型就不能因为推理写得连贯,便认定数据库真的变慢了。
CoT 论文讨论的是中间推理步骤对任务求解的帮助。它不是一种监控查询协议,更不是事实校验机制。
ReAct 多出来的是行动之后的观察
现在给模型提供查询监控和查询日志两个工具。模型提出“先查订单接口的分段耗时”,应用检查参数与权限,再执行查询。
工具返回:数据库耗时没有变化,外部支付接口的等待时间明显升高。
这时,模型下一步就应该围绕支付接口继续查,而不是把第一轮猜测包装成结论。
咱们可以把这个过程理解成:
- 模型提出当前判断和行动请求。
- 应用执行请求,取回真实结果。
- 模型结合结果,修正判断并决定下一步。
在 ReAct 的经典描述中,这些部分通常对应 Thought、Action、Observation。原论文强调的正是推理与环境交互的结合。下面的排查流程只是用这一思路设计的教学例子,并非论文里的实验。
| 当前信息 | 下一步行动 | 行动后新增的信息 |
|---|---|---|
| 订单接口变慢 | 查询分段监控 | 数据库正常,支付接口等待变长 |
| 支付接口可疑 | 查询超时日志 | 大量请求在同一上游超时 |
| 已有监控和日志对应 | 整理结论 | 不再继续无目的查询 |
注意,Action 是模型提出的请求,Observation 是执行器实际取得的结果。不能让模型自己写一句“监控显示正常”,就当作工具已经查过。
有工具,不代表一定采用了 ReAct
如果开发者提前规定“先查监控,再查日志,最后总结”,模型只负责生成摘要,那么这仍然可以是固定 Workflow。
反过来,Agent 可以采用不同的决策方式,也不必把每一轮都显示成 Thought、Action、Observation 三段文字。
因此,这几个词最好分开理解:CoT 描述推理方式;ReAct 描述推理与行动交替的任务求解方式;Agent 系统还包括执行、状态、权限等运行能力。它们不是三个只能选一个的产品。
现代模型的内部推理也未必对应用公开。工程上不需要强迫模型输出完整私有思考过程;记录工具选择、执行结果和简短决策说明,通常就足以检查这条任务链路。
怎样判断这套交互真的有帮助?
给测试任务故意安排一条和初始猜测相反的工具结果。例如模型最初怀疑数据库,而监控证明数据库正常。
然后检查:后续是否换了检查方向,最终回答有没有引用真实结果,是否仍然把最初的猜测说成事实。再对照不调用工具、固定工具流程和动态交互三种方案的完成情况与成本。
如果工具失败,模型也应该说明证据不足,而不是补写一个看起来合理的 Observation。多执行几轮,不能替代拿到有效信息。
面试官继续追问
ReAct 会不会减少幻觉?
可靠工具可以补充证据,但不保证模型一定正确使用证据。它仍然可能查错对象、误读日志,或从“同时发生”推成“存在因果”。
因此,工具反馈必须保留来源与范围,结论也要对应这些证据。不能把“调用过工具”当成答案可靠的证明。
工具结果不支持任何一种原因,怎么办?
可以围绕明确的证据缺口继续查询,但要限制次数。没有足够证据时,输出已经排除的方向、尚未确认的部分和下一步检查建议,比编一个原因更合适。
为什么不能一直循环,直到模型满意?
模型满意不等于目标完成。任务要有可检查的结束条件,并限制耗时、工具次数和预算。连续几轮都没有得到新信息时,也应该停止或转交人工。
面试速记卡
- CoT:在已有信息上组织中间推理,不自动取得外部证据。
- ReAct:推理、行动、观察交替进行,新反馈影响下一步。
- 执行边界:模型提出调用,应用执行工具并返回真实结果。
- 判断重点:不是步骤写得多,而是行动是否带来了新信息。
- 工程要求:保留证据,设置权限、预算和可检查的停止条件。
