
🧑💻 面试官:假设我们做了一个售后知识库。用户问:“上个月买的设备进水了,能免费修吗?”这台设备适用的新版保修规则写着“进水故障不在免费维修范围”,检索结果里也有这段话,可系统却回答“保修期内可以免费维修”。你会先改什么?
🙋♂️ 我:我不会马上换 Embedding 模型。先看这次请求的检索结果和最终发给大模型的内容是不是一样。搜到了那段话,不代表组装上下文时没有把它截掉。
🧑💻 面试官:这段话完整地进了模型输入,回答还引用了这份规则。是不是说明检索和引用都没问题?
🙋♂️ 我:还不能这么说。引用了这份文档,不等于回答用对了其中的条件。我要对照答案里的“可以免费维修”,看引用的原文是否真的支持这个结论。这里恰好漏看了“进水故障除外”。
🧑💻 面试官:检索结果里还有一份旧版规则,写着“保修期内进水可免费维修一次”。如果用户没说设备购买时间,你会让模型直接选新版吗?
🙋♂️ 我:不能只凭“新版”两个字决定。要先确认两份规则分别适用于哪些订单或购买日期;如果缺少决定适用版本的信息,就说明还不能给出确定结论,需要补问用户,而不是让模型自己猜。
🧑💻 面试官:那你怎么证明改完以后,系统不是碰巧把这一道题答对了?
这道题的关键不是“检索结果里有没有正确文档”,而是适用的证据有没有真正进入回答,并且每个结论能不能被证据支持。
面试速答(60 秒版)
RAG 检索到正确文档,只能说明检索结果里出现过它,不能保证大模型拿到了完整的证据,更不能保证它按照证据答对。
我会先拿一条答错的请求,对照检索结果、最终送进模型的上下文和模型输出。如果正确条款在组装上下文时被截掉了,或者只留下标题、没留下限制条件,就先修这一段;如果新旧两版规则同时出现,还要确认哪一版适用于当前用户。
如果完整、适用的条款已经交给模型,就检查回答有没有漏掉前提、例外和否定词。引用了文档也不代表结论正确,得看引用的那句话是不是真的支持答案。证据不够或者版本无法判断时,系统应该说清楚缺什么信息,必要时向用户补问。
最后拿一批包含例外条件、版本冲突和无答案问题的用例做回归。既看证据有没有进入模型输入,也看最终结论是否正确、是否真的有材料支持,而不是只看检索命中率。
知识点详解:文档找对了,答案可能错在哪一步?
先把“搜到了”拆成三个不同的结果
还是用刚才的售后知识库举例。我们先假设,这台设备适用的新版规则明确写着:保修期内的非人为故障可以免费维修,但进水故障不在免费维修范围。旧版规则对进水故障另有规定。两份规则都是这篇文章为了讲解而设定的例子,并不对应真实品牌的售后政策。
一次 RAG 回答里,至少要分清下面三件事:
- 检索结果里有什么。 检索服务可能返回了新版条款,但也同时返回了旧版规则和一些只提到“保修期”的片段。
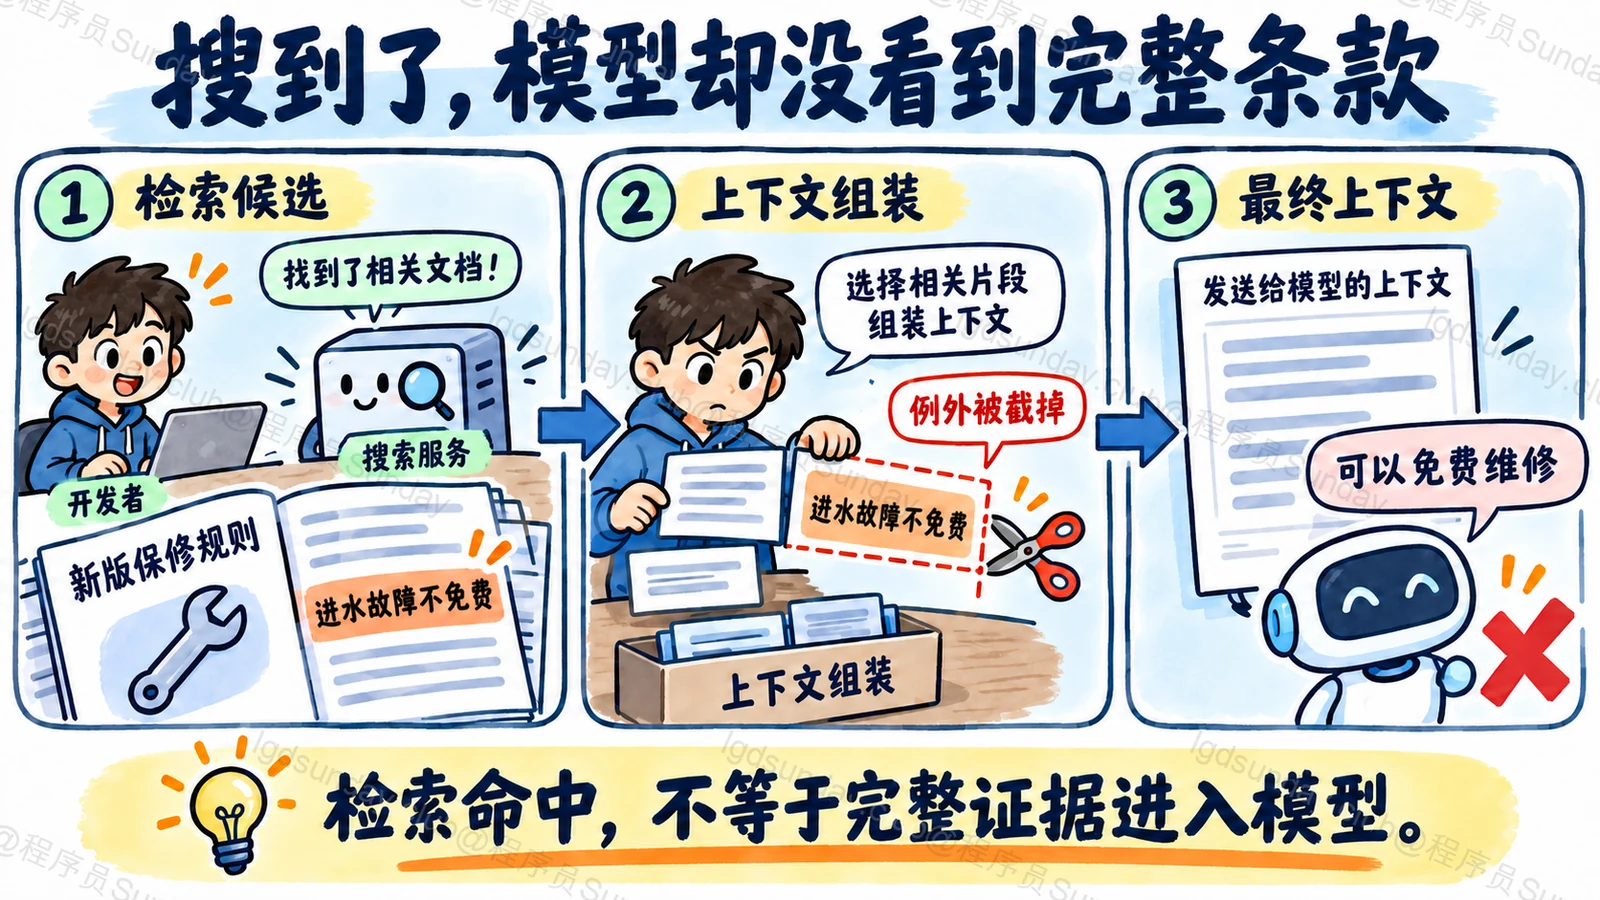
- 最终交给模型的是什么。 应用可能做去重、排序、截断或长度控制。新版条款出现在检索结果中,不代表“进水除外”这几个字仍在最终输入里。
- 模型最后说了什么。 即使条款完整保留,模型仍可能抓住“保修期内免费维修”,忽略后面的排除条件。
所以,排查时不要只截一张向量库的召回截图。要把同一次请求的用户问题、候选片段 ID、片段原文与版本、最终上下文、模型回答和引用位置放到一起。先确认错误发生在证据交接,还是发生在证据使用。这一步能决定你究竟该改上下文组装,还是该改回答约束和校验。
正确文档不等于“足以回答”的证据
假设最终输入只有一句“保修期内可以免费维修”,却没有紧跟着的“进水故障除外”。模型给出错误答案,问题主要在证据不完整。此时再把提示词写得严厉,也没法让模型凭空恢复被截掉的条款。
再换一种情况:新旧两版规则都完整地进入了上下文。系统还需要知道规则的生效时间、适用产品以及用户购买或签约时适用哪一版。**文档越新,不等于对每个用户都必然适用。**如果这些条件没有被记录或用户没提供,模型就不该默默挑一份看起来更合理的材料。更稳妥的回答是说明两版规则存在差异,并询问能决定适用范围的信息。
这也是为什么上下文不能只拼一堆正文。对有版本差异的资料,至少要保留能做判断的标题、版本或生效信息、来源标识,以及决定结论的完整句子。当然,这些字段也必须来自可信的文档管理流程,不能让模型根据一段没有出处的文字自己猜“这应该是最新版”。
引用了正确文档,结论仍然可能是错的
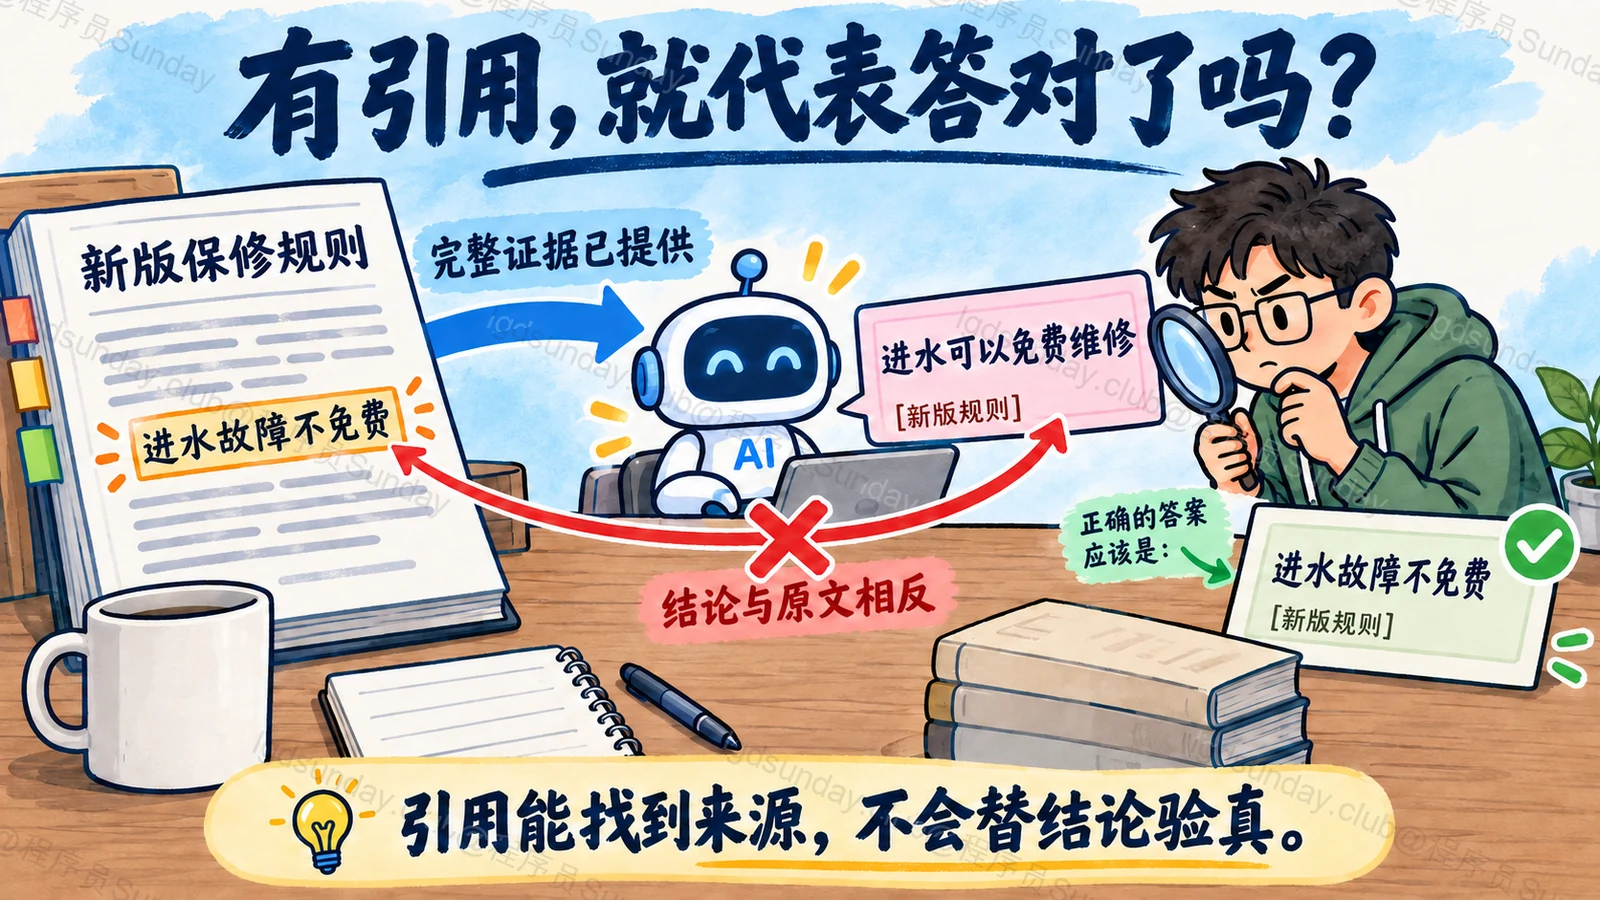
如果新版条款完整地出现在模型输入中,回答却说“进水可以免费维修”,就不能再把故障归咎于“没搜到”。现在要查的是:模型有没有照着证据回答。
可以把答案拆成具体判断来核对。比如“设备在保修期内”是一项条件,“进水故障可以免费维修”是另一项结论。引用了新版规则,不代表第二项结论就被新版规则支持。引用是让人找到来源的线索,不是自动验真的证明。
应用可以在生成要求里明确:只根据给出的条款回答;涉及例外、期限和适用范围时把条件说完整;材料不够时不要补猜;遇到冲突先指出冲突。还可以在输出后检查关键结论是否能对应到具体证据。只是,提示词和自动检查都不能保证每次正确,尤其是金额、权益这类会影响用户决定的场景,仍需要把高风险错误纳入人工复核或业务规则校验。
改完以后,别只拿“这一题答对了”验收
可以准备一小批有标准答案和依据片段的测试题:普通保修问题、带“进水除外”的问题、新旧规则冲突的问题,以及现有资料根本无法回答的问题。每次改动以后,在相同测试集上回放,并分别检查:
- 需要的条款是否进入了最终上下文,而不只是出现在检索候选里。
- 回答的关键结论是否得到所引条款支持,有没有遗漏例外条件。
- 当证据不足或适用版本无法判断时,系统有没有停止猜测并说明原因。
检索命中、回答是否忠于材料、最终结论是否正确,是不同的检查项。一个系统可以“搜得准”,却“答得错”;也可能引用看起来齐全,但引用的原文根本支持不了它的结论。把这些结果分开记录,才能知道修改真正修好了哪一段。
面试官继续追问
正确条款在检索前五条里,最终上下文却没有,先改 top_k 吗?
先别改。检索已经把它找到了,应该先看最终上下文是怎么拼出来的:是不是去重时误删、排序后被截断,或者保留了标题却没保留关键例外。把检索候选和最终输入按片段 ID 对齐,再修对应的组装规则。
如果只是盲目增大 top_k,模型会收到更多材料,但那句关键条款仍可能在后续截断中丢失;额外的旧版内容还可能增加判断难度。
答案引用了正确文档,为什么还要检查引用?
因为引用的是“哪份文档”,和文档中的“哪句话支持哪个结论”,不是一回事。最好能把关键结论定位到具体条款。像“进水可免费维修”这样的说法,如果它引用的恰好是“进水不在免费维修范围”,这个引用反而暴露了错误。
检查引用时也要防止模型自己编一个来源编号。展示给用户的引用,应当能回连到本次实际提供的片段,而不是只在回答里长得像引用。
新旧两版规则都在,必须永远优先用最新版吗?
不一定。要看业务规则怎么定义适用范围。可能按购买日期、合同签署日期或产品型号来确定。先用这些可信字段筛选适用资料;如果仍有冲突,就把冲突说明白,或者让用户补充缺失信息。
“最新版”只是一个版本事实,不是所有具体问题的最终判定规则。
面试速记卡
- 检索命中:正确文档出现在候选里,不等于完整条款进入模型输入。
- 证据完整:回答需要前提、例外和适用版本,不能只拿到一句相似的话。
- 引用校验:看具体结论是否被所引条款支持,不把引用标记当成正确证明。
- 证据不足:版本无法判断或材料没有答案时,说明缺口并补问,不让模型猜。
- 验证修复:分别检查最终上下文、证据忠实度和答案正确性。
