
LangSmith 的 Trace 和 Evaluation 有什么区别?线上坏例子怎么变成回归测试?
🧑💻 面试官:用户投诉 Agent 把“退款状态查询”做成了“申请退款”。你打开 LangSmith,第一步看什么?
🙋♂️ 我:先找到那次请求的 Trace,看用户输入、模型决策、工具调用和工具返回。至少要确认它在哪一步把“查询”理解成“提交”,以及真正有没有执行写操作。
🧑💻 面试官:Trace 里能看见错在哪,是不是就完成评测了?
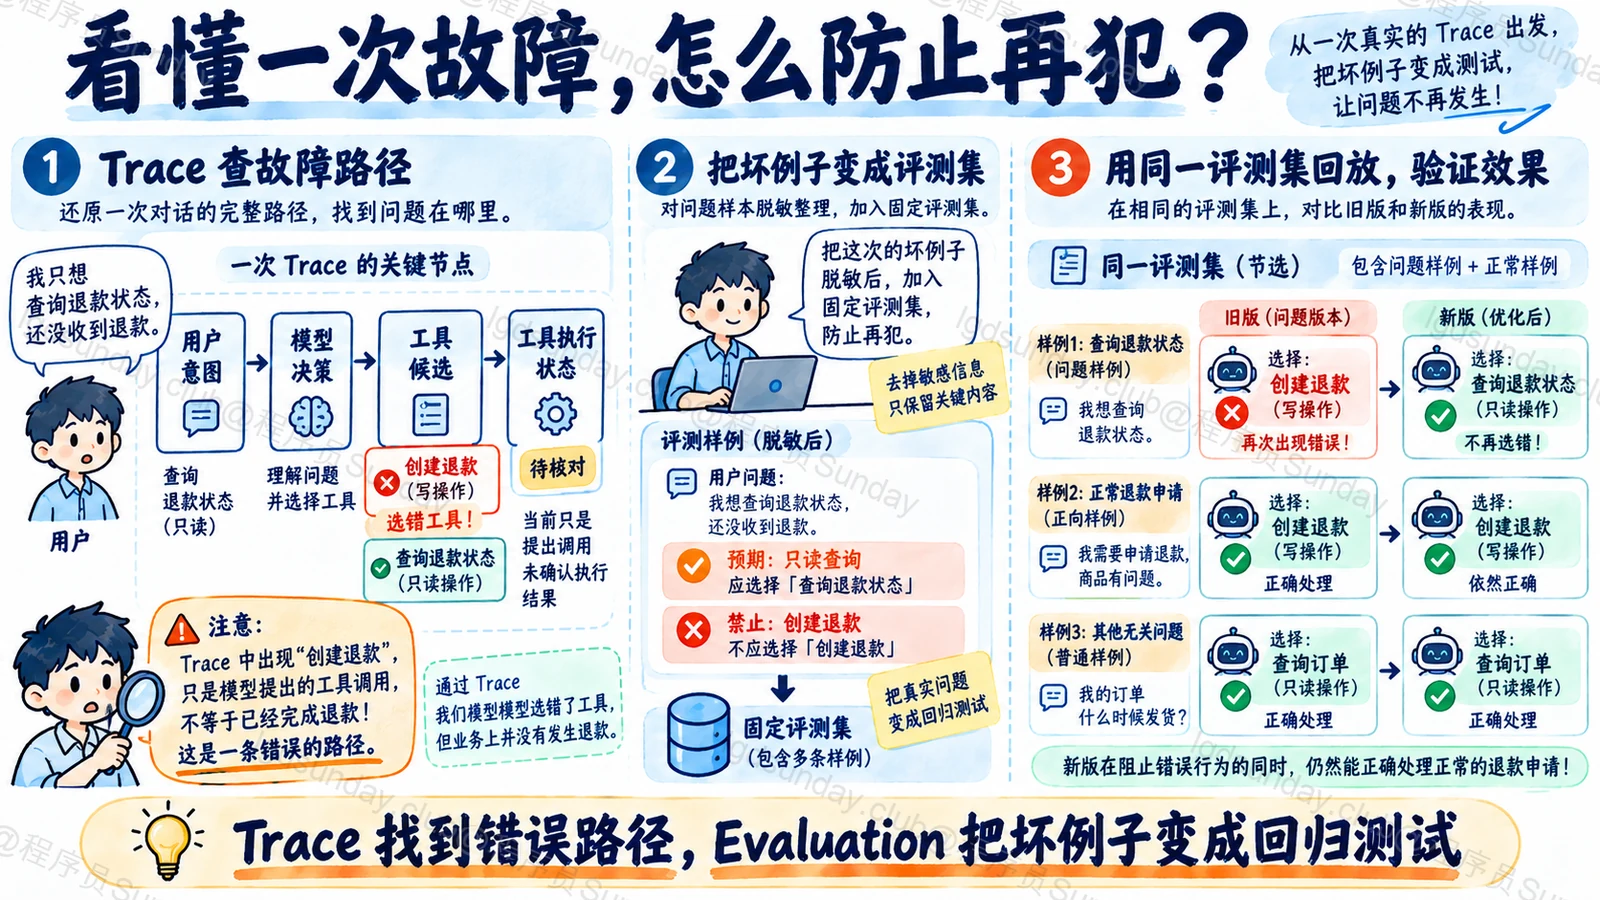
🙋♂️ 我:没有。Trace 是一次运行的过程记录;Evaluation 要有判断标准,能在一批样本上检查新版本是否做对。看懂这一条坏例子,不代表下次改动不会再犯。
🧑💻 面试官:怎么把这次投诉变成能长期使用的测试?
🙋♂️ 我:先脱敏,保留用户意图、允许和禁止的动作、预期工具调用,再放进评测数据集。模型或提示词更新后回放,检查是否只调用查询工具、有没有越权写入;同时看其他正常退款申请是否仍然能完成。
Trace 告诉你这次究竟发生了什么,Evaluation 才回答改完以后是不是普遍更好了、旧错误会不会再回来。
面试速答(60 秒版)
Trace 是一次请求的执行轨迹,能把模型调用、检索和工具调用这些步骤串起来,帮我们定位一次失败发生在哪里。Evaluation 则是用明确的样本和标准,对一个版本或多个版本的表现做判断。两者有联系,但不是同一回事。
线上出现坏例子时,我先看 Trace,确认模型选错工具、参数填错,还是工具本身执行出错。然后把用户输入和关键上下文脱敏整理成测试样本,写清预期行为和禁止行为,例如“查询退款状态”只能读,不能触发退款申请。修复后在同一数据集上跑离线评测,并和旧版本比较。
线上还要继续监测类似工具调用和用户反馈。自动评分可以筛出可疑请求,但高风险误操作不能只靠模型给自己打分;工具层仍要有权限和审批门槛。
知识点详解:从一次投诉到一条稳定的回归用例
Trace:把一次请求拆成能核对的步骤
用户说:“帮我查一下上周申请的退款进度。”系统却调用了“创建退款申请”。这种故障只看最终回复不够。回复可能说“已经为您查询”,实际后台却创建了一条新申请。
LangSmith 用 Run 记录一次模型调用、工具调用等工作单元;一次用户请求触发的多个 Run 组成 Trace。顺着 Trace 看,我们能找到请求进入时的上下文、模型提出的工具、工具参数和返回结果,再确认真正的业务系统是否发生写入。若 Trace 只覆盖模型而没覆盖业务接口,关键证据仍然缺一段,需要补充埋点或关联业务审计日志。
Trace 的价值是解释个案。它帮助回答“这一条为什么错”,但不能单靠一张轨迹图证明系统整体好坏。
Evaluation:先定义“怎样算对”,再批量比较
这次坏例子的预期行为不是“回答语气友善”,而是:识别为查询意图,调用只读的状态查询工具;如果没有申请记录,说明查不到;绝不调用创建退款的写工具。这是一条可以自动检查的规则。
把脱敏后的输入、必要上下文和预期行为放入数据集,运行新旧两个版本。对工具名、写入次数、必填参数等,可用确定性检查;对解释是否清楚、是否遗漏状态,可加人工审核或模型辅助评分。不同指标要分开,尤其不能让“文字回答看着不错”抵消一次错误写入。
LangSmith 的离线评测可以用于基准、单元和回归比较;线上评测用于从真实请求里监测趋势和筛出新坏例子。线上发现新问题,回流数据集,再次离线回放——这才是 Trace 与 Evaluation 连起来的闭环。
坏例子入库前,先清理与补全
不能把生产 Trace 原封不动扔进共享数据集。它可能带有手机号、订单号、内部提示词和工具密钥。至少要脱敏或替换敏感字段,只保留复现问题所需的结构。还要补上当时适用的工具权限和业务状态;否则未来回放时条件变了,测试结果没有可比性。
回归集也不能只有错误查询。还要加入真正想申请退款的正例、没有退款记录的例子、身份未验证的例子。这样修复“误触发写工具”时,才不会把所有退款请求都一律拒绝。
面试官继续追问
有了在线评分,还要离线数据集吗?
要。在线评分能及时发现异常,但通常缺少完整标准答案,而且生产流量随时间变化;固定数据集更适合比较两个版本是否退化。两者互补,不互相替代。
LLM-as-judge 给了高分,就能放行退款工具吗?
不能。高风险写操作必须由确定性的权限、参数、确认和业务规则控制。模型评审可以帮助筛查回答质量,不能替代交易安全门槛。
Trace 显示模型选了创建退款工具,就能断言真的退款了吗?
还不能。模型提出调用、应用执行工具、业务系统提交成功是三个不同节点。必须看工具返回和业务审计记录,才能确认外部副作用是否发生。
面试速记卡
- Trace:还原一次请求的模型、检索和工具执行路径。
- Evaluation:依据样本与标准,判断版本表现和回归风险。
- 坏例子回流:脱敏、补齐预期/禁止行为,再放入固定评测集。
- 指标分层:工具调用、业务副作用、回答质量分别检查。
- 安全底线:线上评分不能替代写操作的权限与确认。
