
🧑💻 面试官:SFT、RLHF 和 DPO,分别在教模型什么?
🙋♂️ 我:SFT 用正确答案训练,RLHF 和 DPO 用人的偏好改善回答。
🧑💻 面试官:既然都有人标注,为什么不能把偏好数据直接当 SFT 数据?
🙋♂️ 我:示范答案告诉模型怎么答,偏好数据还告诉它两种回答哪个更好。
🧑💻 面试官:那 DPO 是不是先训练奖励模型,再让模型拿高分?这几种方法必须按顺序全部做一遍吗?
先问「训练信号是什么」,再问「模型怎样根据它更新」。有人参与标注,不代表训练方法就相同。
面试速答(60 秒版)
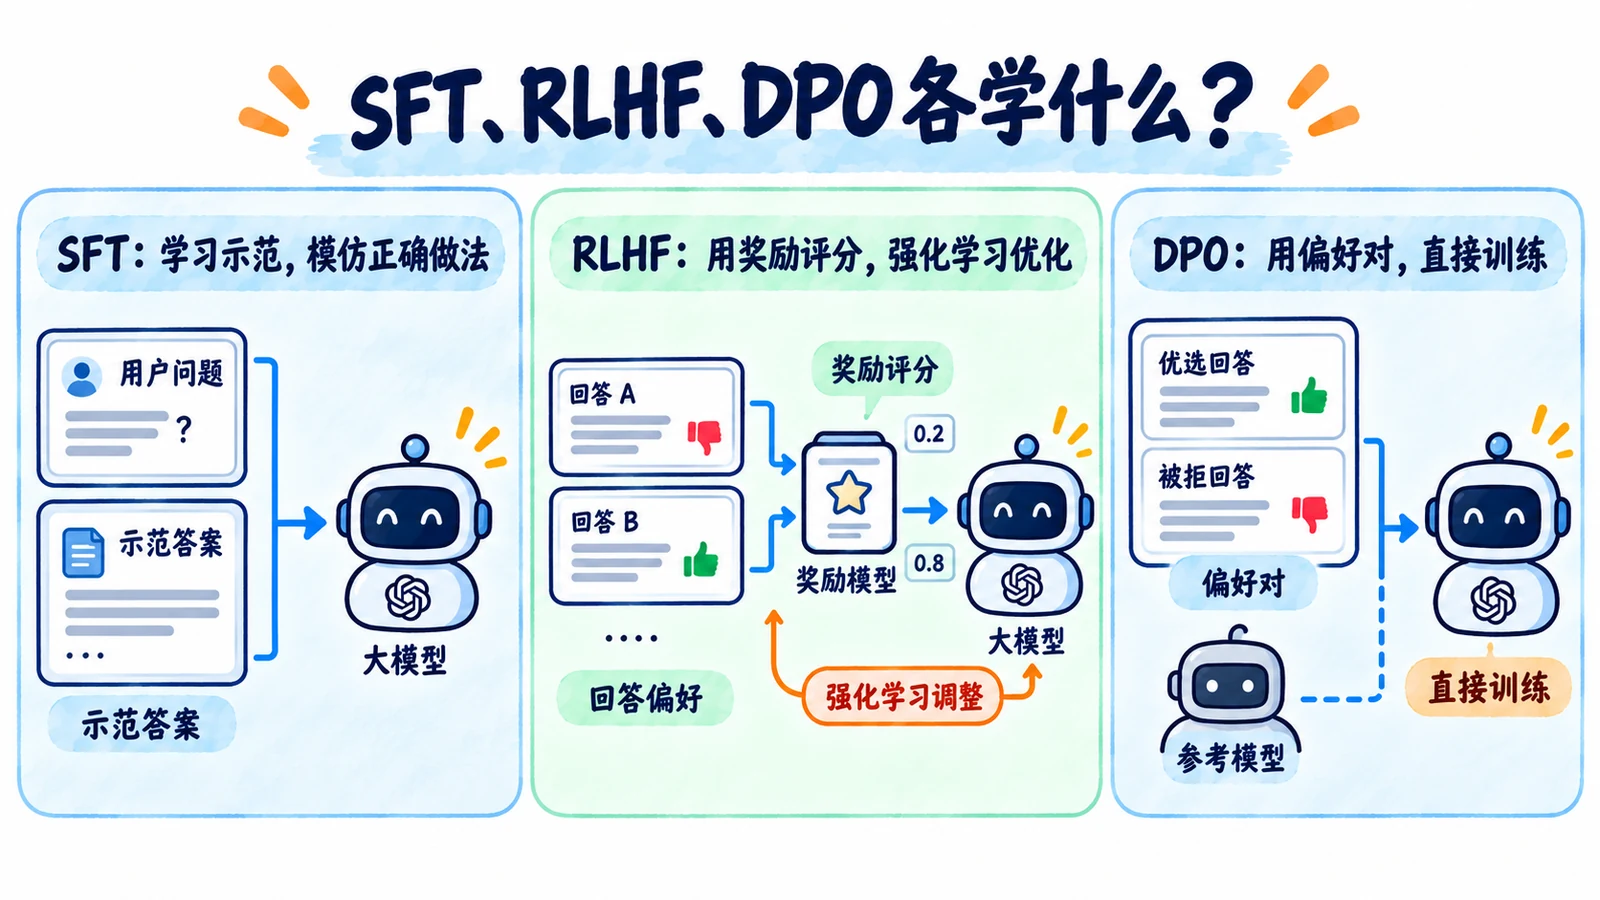
SFT 是监督微调,使用“问题和示范答案”训练模型,让它学习怎样按要求回答。
RLHF 是利用人类反馈进行强化学习的一类方法。经典做法先收集多个回答的偏好排序,训练奖励模型,再让语言模型根据奖励调整回答,并限制它不要偏离参考模型太远。
DPO 也可以使用“更喜欢的回答、不喜欢的回答”这种数据,但它直接用偏好目标训练语言模型,不需要先单独训练一个奖励模型,再进行在线强化学习采样。
因此,三者的区别不能只看有没有人工标注,要看数据给了什么信号、优化过程怎样进行。它们也不是必须依次执行的三个阶段。后训练采用什么组合,要根据任务、数据和评测结果决定。
知识点详解:示范答案和偏好,为什么不是一回事?
预训练之后,为什么还要训练?
预训练主要让模型从大量文本中学习语言、知识和模式。但会接着写文字,不等于能稳定理解用户要求,也不等于回答符合某个产品的需要。
假设咱们希望客服模型解释退款政策。用户问“我能退款吗”,模型需要按条件回答;条件缺失时补问,不能编造订单信息。
后训练可以用更有针对性的数据调整这些行为,也可能改善知识或任务能力。不能把它理解成只给模型加一层礼貌话术。
SFT:给它看一份应该怎样回答的示范
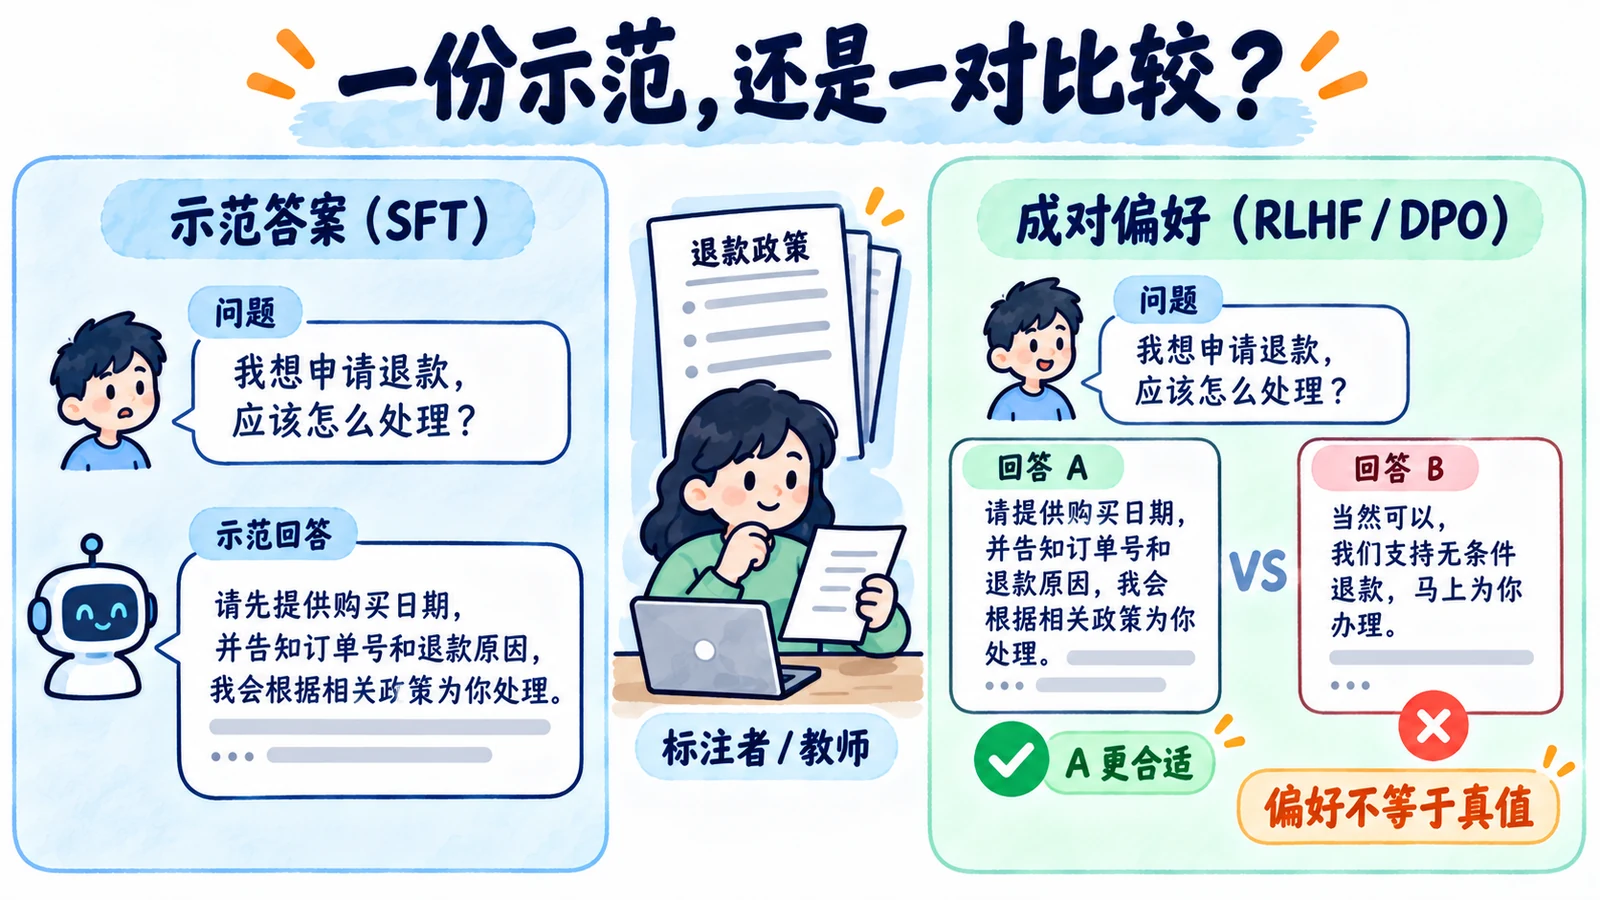
一条 SFT 样本可以包含用户问题、相关条件,以及人工或经过核验的示范回答。
训练时,模型学习在这些输入下生成示范答案。它预测的后续内容与样本答案不一致,就根据损失更新参数。
例如,样本中的用户没有提供购买日期,示范答案先询问日期。模型见过足够多这样的例子,才更有机会学会在信息不足时补问。
但如果数据里的示范都在猜日期,训练也会把这个错误教进去。SFT 学习的是数据提供的模式,不会自动判断示范是不是可靠。
经典 RLHF:先学会评分,再调整回答
同一个退款问题,模型可能生成两个回答。A 把条件解释清楚,B 直接说“都可以退款”。标注者判断 A 更合适,就形成了一条偏好数据。
经典 RLHF 用这些比较训练奖励模型,让它学会给回答评分。之后,语言模型生成回答,得到奖励,再通过强化学习方法更新。InstructGPT 使用了示范微调、偏好比较和强化学习这样的训练路线。InstructGPT 论文介绍了这一方法。
为什么还要限制与参考模型的差异?因为模型可能找到评分规则的漏洞。例如,为了获得高分写得更长、更肯定,却没有变得更真实。限制偏移能帮助控制变化,但不能替代对真实任务的检查。
这里介绍的是经典路线。RLHF 是一类方法,不等于只允许使用某一个算法。
DPO:直接用一对回答调整模型
DPO 不再把“训练奖励模型”和“用奖励做在线强化学习”拆成两个独立步骤。
它利用输入、优选回答和被拒回答,通过一个偏好目标更新语言模型。可以直观理解为:相对于参考模型,提高优选回答相对被拒回答的倾向。不过,这不是简单地只把优选回答拿来做一次 SFT;损失会同时涉及两边的相对关系。
DPO 原始论文给出了具体目标和推导。本文不展开公式,先把训练信号与训练流程的区别讲清楚。
如果两份回答只有一个语气更热情,但事实都错,偏好训练也不一定纠正事实。偏好标注需要说明判断标准,例如准确、遵守条件、不过度承诺,而不是只选更顺耳的一段话。
面试官继续追问
DPO 一定比 RLHF 效果更好吗?
不能这样说。DPO 简化了训练流程,但效果仍受偏好数据、参考模型、任务分布和超参数影响。
如果训练数据只覆盖简单问题,遇到复杂业务条件仍可能失败。应该在相同基础模型和评测集上比较,而不是用不同模型的最终成绩证明某个算法天然更强。
有了偏好数据,还需要 SFT 吗?
不一定每条路线都必须新增一个 SFT 阶段,但基础模型是否已经具备指令响应能力会影响训练选择。
连退款问题都理解不好时,仅凭少量回答偏好,未必能补齐所有任务能力。可以先建立可靠的示范数据,再判断是否需要进一步优化偏好。
怎么发现模型只是更会讨好用户?
把“用户希望听到什么”和“正确答案是什么”分开评测。
例如,用户坚持认为任何课程都能退,正确行为仍是解释条件。还要检查拒答是否过度、事实是否有依据,以及没训练过的任务有没有退步。平均偏好分提高,不能掩盖越权承诺和编造事实。
面试速记卡
- SFT:从问题与示范答案中学习任务回答。
- 经典 RLHF:偏好比较训练奖励模型,再用奖励调整语言模型。
- DPO:直接使用成对偏好目标,不必单独训练奖励模型。
- 组合关系:不是必须顺序执行的固定三步。
- 质量边界:训练信号可能有偏差,偏好高不等于事实正确。
