
🧑💻 面试官:Kafka 消费到文档解析消息后,把它交给后台线程处理,什么时候提交 Offset?
🙋♂️ 我:等后台任务处理成功,再提交。
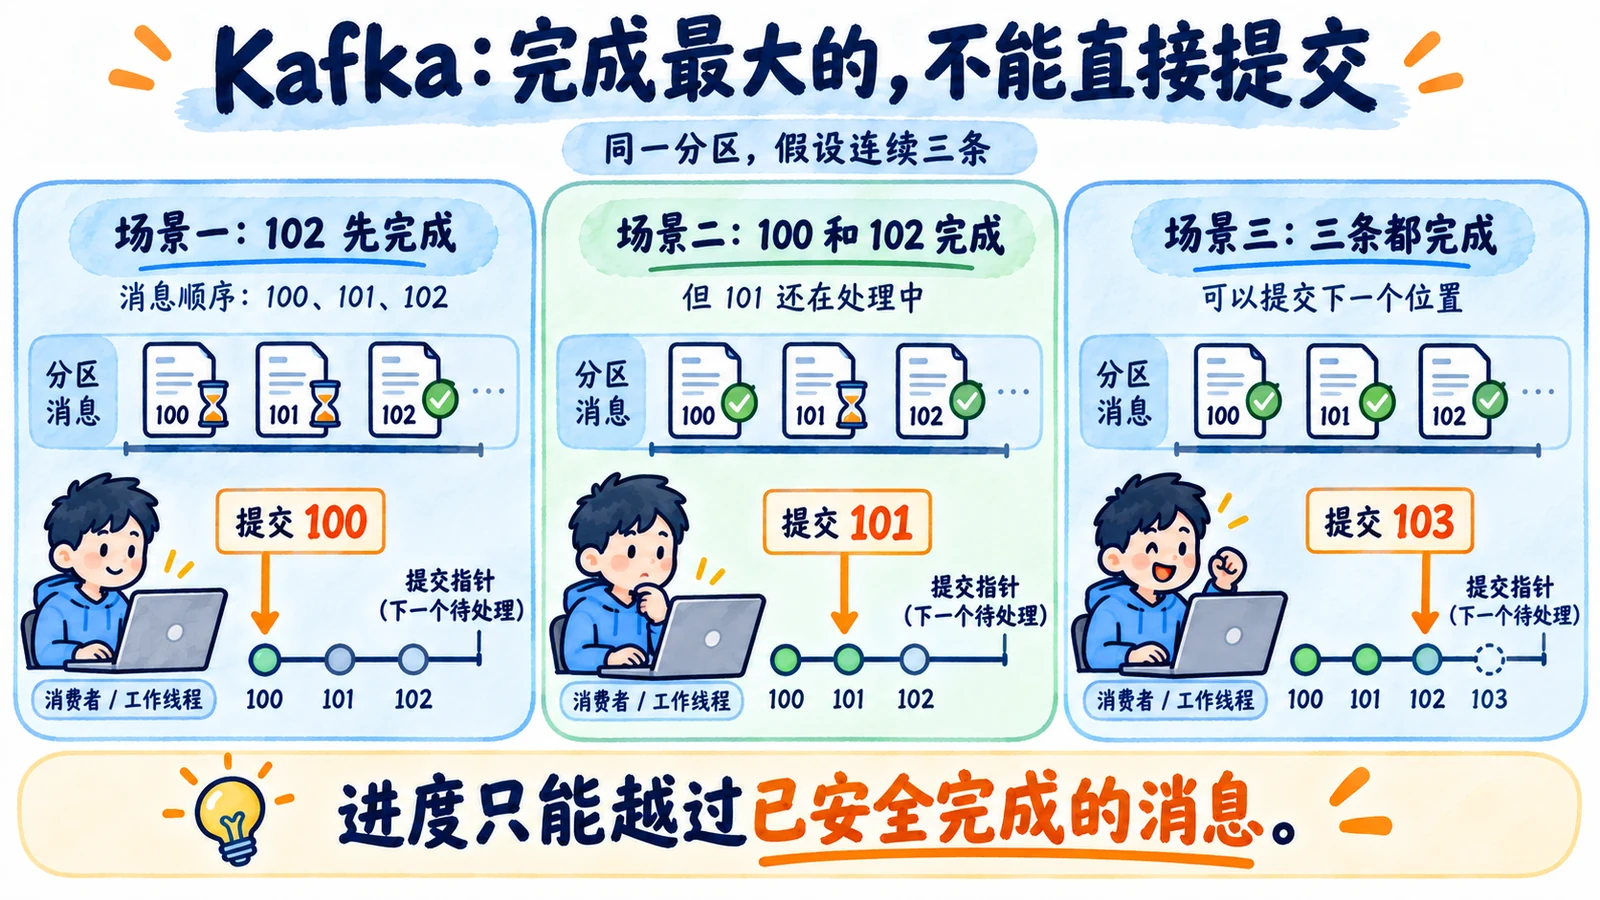
🧑💻 面试官:同一个分区收到 100、101、102 三条消息,102 最先处理完,可以先提交 103 吗?
🙋♂️ 我:不行,100 和 101 还没有完成,重启后可能跳过它们。
🧑💻 面试官:那完成状态怎样记录?如果处理过程中分区被分配给另一个消费者,旧线程回来以后还能继续提交吗?
这道题的关键是:「不能越过没完成的消息」。Kafka 记录的是分区恢复读取的位置,不是后台任务中最大的完成编号。
面试速答(60 秒版)
Kafka 消息交给后台异步处理以后,提交位置应该对应已经安全完成的处理进度,不能在任务刚放进内存队列时,就认为消息已经处理成功。
同一个分区内,多个任务可能乱序完成。因此,需要记录每条消息的处理状态,只推进前面没有未完成消息的进度,并提交下一条需要处理的 Offset。
例如,100、101、102 中只有 102 完成时,不能提交 103。否则消费者重启后,会从 103 开始,100 和 101 就可能被跳过。
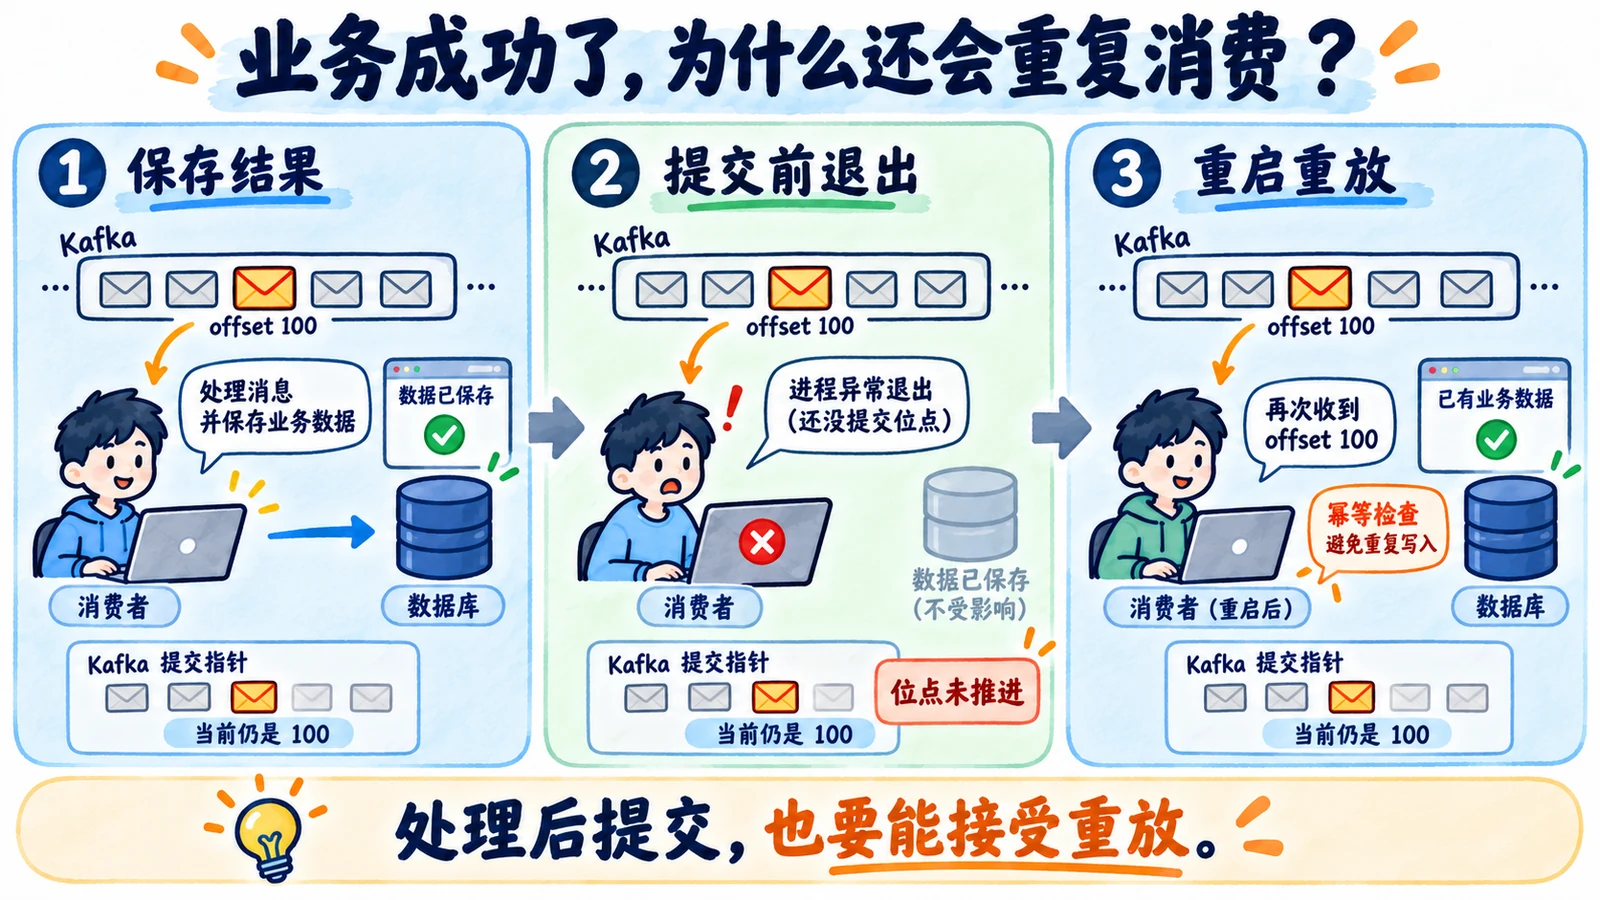
同时,要关闭不符合这套完成规则的自动提交,并处理分区重新分配。业务成功后、位点提交前,仍然可能发生故障并导致重复消费,因此还需要幂等处理。手动提交并不自动保证外部数据库恰好写入一次。
知识点详解:后台任务完成以后,位点怎样往前走?
拉到了消息,不代表业务已经完成
假设咱们用 Kafka 接收文档解析任务。消费者拉到消息后,把文件交给后台工作线程,解析完成以后,再把结果保存到数据库。
这里有几个不同时间点:消息被拉取、任务进入内存队列、解析结束、结果成功保存。
如果在进入内存队列时提交位点,随后进程崩溃,队列里的任务可能丢失。但是消费者重启后,会按照已提交位置继续读取,不一定再拿到这些消息。
因此,本题把“安全完成”定义为:需要的处理结果已经成功持久化。不能把工作线程接受了任务,当成这个条件已经满足。
如果项目采用另一种设计,例如先把任务可靠地写入独立任务系统,允许完成持久化交接后提交,也需要明确后续由谁保证任务恢复。那是另一种完成边界,不是把内存入队说成可靠交接。
Offset 记录的,是下次从哪里开始
Kafka 中,Offset 属于一个分区。两个分区都出现 100,不表示它们是同一条消息。
消费者当前已经拉到哪儿,和成功提交的恢复位置,也不是同一个状态。KafkaConsumer 文档区分了消费位置与提交位置。
假设从 100 开始处理,并且 100、101、102 是这个例子中连续收到的三条消息。全部完成以后,应该提交 103,意思是下次从后面的位置继续,而不是提交“最后完成的 102”。
那么,乱序完成时怎么判断?
| 后台完成情况 | 可以提交的位置 | 原因 |
|---|---|---|
| 只有 102 完成 | 100,不前进 | 100 仍未完成 |
| 100、102 完成 | 101 | 下一个未完成的是 101 |
| 100、101、102 完成 | 103 | 前面这批已经全部完成 |
这就是按顺序推进完成进度。不能拿所有成功任务里最大的 Offset,再加一提交。
生产中的 Offset 不保证每个整数都对应一条应用可见消息。因此,实际跟踪的是该分区实际交付的消息顺序和完成状态,不是死等一个从来没有收到过的整数编号。
消费循环和后台处理,怎样配合?
消费者负责拉取消息和维护分区进度,工作线程负责处理任务。后台完成以后,把结果状态交回进度管理者,再由它计算可以提交的位置。
具体实现要遵循客户端的并发约束。例如,官方 Java KafkaConsumer 并不是线程安全的,不能随意让每个工作线程直接操作同一个消费者。TypeScript 或 Python 项目也要检查实际客户端的调用规则,不能机械照搬另一种语言的 API。
如果后台处理很慢,还需要限制在处理任务数量。必要时暂停对应分区的继续拉取,但仍按客户端要求维持消费循环,处理成员活性和重新分配事件。
只把 max.poll.interval 调得很大,不会自动解决位点和任务完成状态不一致。这个配置影响消费者活性判断,而不是替后台任务证明成功。
不同分区的进度应该分别计算。分区 A 的 100 卡住,不需要让分区 B 已经完成的进度一起停住;同一分区的进度,则不能越过未完成消息。
提交成功,也不代表外部操作恰好发生一次
假设后台已经把解析结果写进数据库,正准备提交位点,进程突然退出。
重启以后,这条消息可能再次出现。如果应用又插入一次结果,就可能产生重复数据。
所以,“处理完成后再提交”主要避免提前提交导致跳过工作,但仍然需要处理重复消费。可以根据事件标识或消息的主题、分区、Offset,建立合适的去重规则,并让去重记录和业务写入满足所需的原子性。
再看分区重新分配。旧消费者可能失去分区,但它的后台任务还没结束。此时需要停止派发新任务,在允许的时间内处理进行中的工作,并区分当前分配与旧分配的完成结果。
失去分区以后,不能让旧线程继续凭原来的身份提交位点。Rebalance 回调文档区分了分区撤销和已经丢失的情况,处理策略也要与客户端机制配合。
不过,仅仅忽略旧线程的提交,还不能撤销它已经写入的数据库内容。因此,业务写入仍然需要幂等,必要时检查执行版本或所有权,防止旧工作进程影响新任务。
面试官继续追问
一条消息一直失败,后面的成功结果怎么办?
可以保留后面已经持久化的结果,但不能让提交位置跨过失败消息。
失败消息要按业务规则重试、转人工,或者可靠地记录到异常处理系统。只有这种处理本身满足约定的完成条件,才能继续推进。不能简单跳过,然后声称没有丢消息。
commitAsync 就是异步处理业务吗?
不是。它主要是让提交位点的调用以异步方式返回,和后台解析文件是两件事。
不管提交 API 是否异步,传入的位置都要根据真正完成的进度计算。把提交方式换成同步,也不会自动等待你的工作线程完成。
每条消息都提交一次,是不是最安全?
频繁提交可以缩小部分故障后的重复处理范围,但会增加提交开销,也不消除业务写入与位点之间的故障窗口。
可以按一定数量或时间提交安全进度,并接受相应的重放范围。前提是位点计算正确,业务能够处理重复,而不是只追求提交次数最多。
面试速记卡
- 完成边界:内存入队不等于业务成功,要明确可靠完成或交接条件。
- 提交含义:提交下一条需要处理的位置,不是最后完成的编号。
- 乱序完成:按分区推进安全进度,不能越过未完成消息。
- 消费活性:后台处理慢时控制积压,仍按客户端要求维持消费循环。
- 故障重放:业务成功、位点未提交,仍可能重复消费。
- 分区变更:旧任务完成不能越权提交,业务写入还要幂等或校验版本。
