
🧑💻 面试官:Agent 执行到一半,服务重启了,怎么办?
🙋♂️ 我:把任务状态持久化,重启后读取 Checkpoint,继续执行。
🧑💻 面试官:它刚创建完一个工单,还没保存工具结果就退出了。恢复后再调用一次,会不会创建两张?
🙋♂️ 我:需要判断外部操作是否已经成功,不能只根据本地状态重试。
🧑💻 面试官:那两个新实例同时发现这个任务未完成,谁来继续?之前只是暂时卡住的旧实例又恢复了呢?
恢复任务,要同时解决三件事:知道做到了哪里、知道外部动作是否发生,以及确保当前只有被允许的执行者继续推进。
面试速答(60 秒版)
Agent 故障恢复不能只保存聊天记录。需要持久化任务标识、运行状态、已完成步骤、待处理动作和必要的结果引用,重启后才知道从哪里接着做。
恢复时,执行器先取得任务的执行权,再读取最后保存的状态。已确认完成的步骤可以复用结果;尚未执行的步骤继续执行;对于结果不确定的外部操作,先用稳定的业务操作编号查询或通过幂等接口重试,不能直接当成失败。
同时,还要防止两个实例重复接管,并阻止失去执行权的旧实例继续提交结果。
框架的 Checkpoint 可以帮助恢复流程,但不会自动让下游业务只执行一次。最终需要把状态保存、任务调度和业务幂等配合起来,再通过不同故障位置的测试验证。
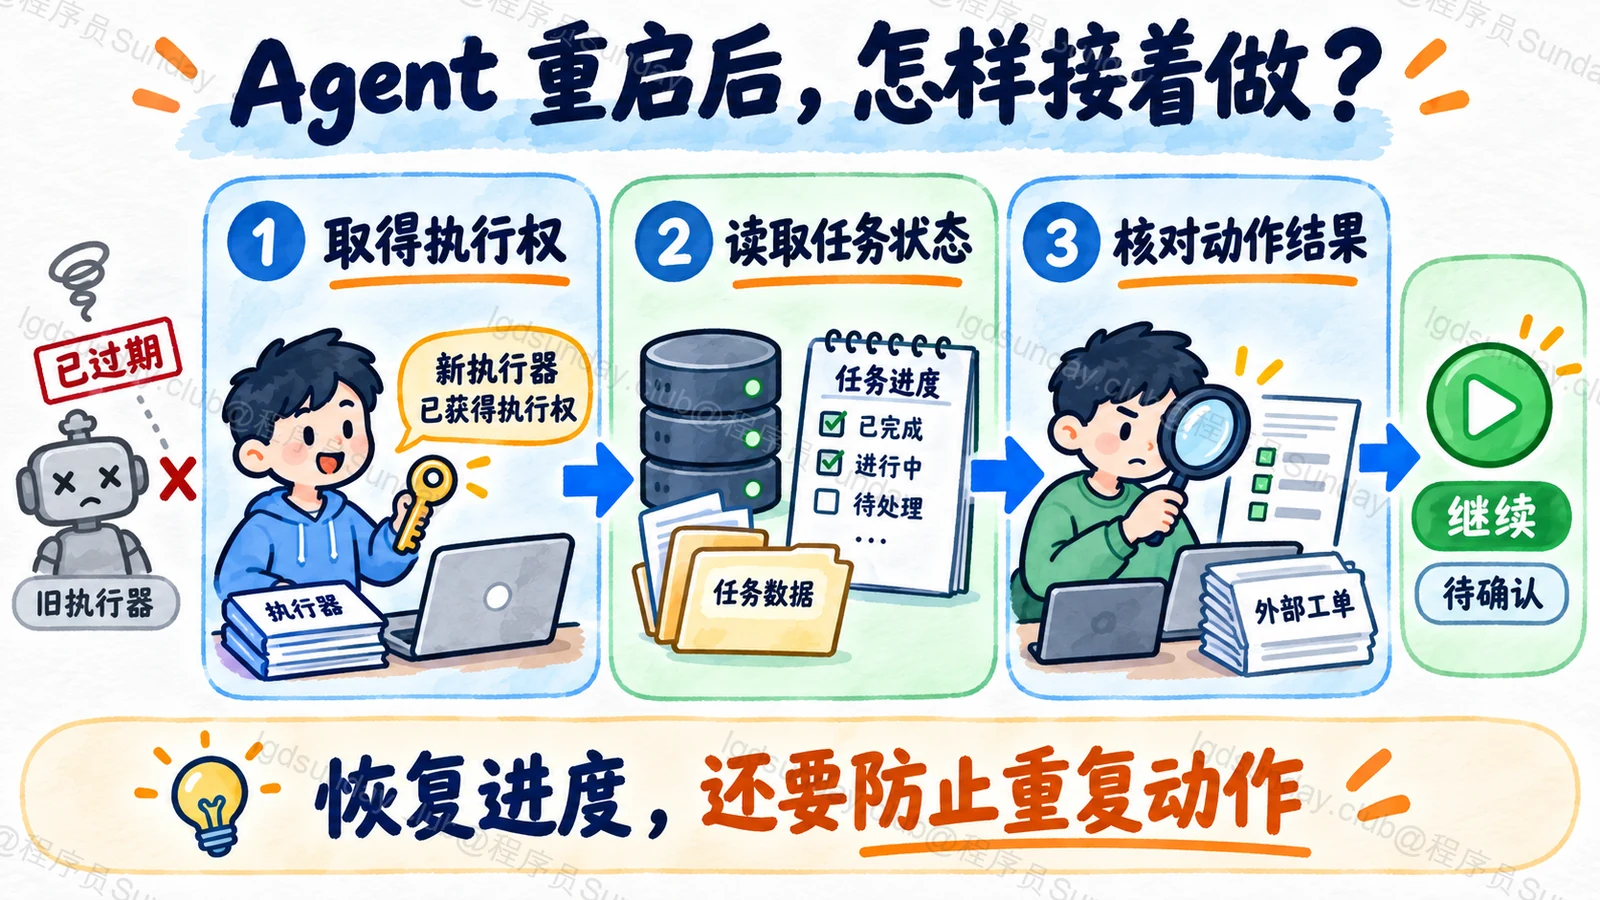
知识点详解:一次重启会丢掉哪些东西?
先把“任务”与“正在执行它的进程”分开
假设一个运维 Agent 正在处理告警:读取监控、分析原因、创建工单,再把工单地址返回给用户。
如果任务只存在于服务进程的变量里,进程退出,当前进度、工具结果和待办事项都会消失。恢复后即使还能查到用户最初那句话,也不知道工单有没有创建过。
因此,任务要有独立于进程的记录,例如固定的任务编号、当前状态、已完成步骤和产物位置。执行器只是领取这项任务的工作进程,不是任务本身。
Checkpoint 可以保存恢复所需的运行状态,但必须使用真正可持久保存的后端。LangGraph 的持久化说明明确区分了状态持久化能力与内存实现;内存保存不会因为叫 Checkpointer,就在进程重启后仍然存在。
最麻烦的故障,发生在两边状态不一致时
创建工单可能经历这样的顺序:
- 本地记录准备创建工单,并保存稳定的操作编号。
- 向工单系统发送创建请求。
- 工单系统创建成功。
- 本地收到结果,保存工单编号和新的任务状态。
如果进程在第 1 步之后退出,可以检查是否确实尚未发送,再决定继续。如果已经发送,或者在第 3 步之后退出,本地只知道“准备创建”,却无法仅靠这条记录判断外部是否成功。
所以,本地没有成功记录,不等于外部没有执行成功。 这时把整个节点从头跑一遍,可能得到第二张工单。
在请求发出之前保存稳定的业务操作编号,就是为了后面能够识别“还是同一次创建”。重试使用同一个编号,而不是每次启动进程都生成一个新的编号。
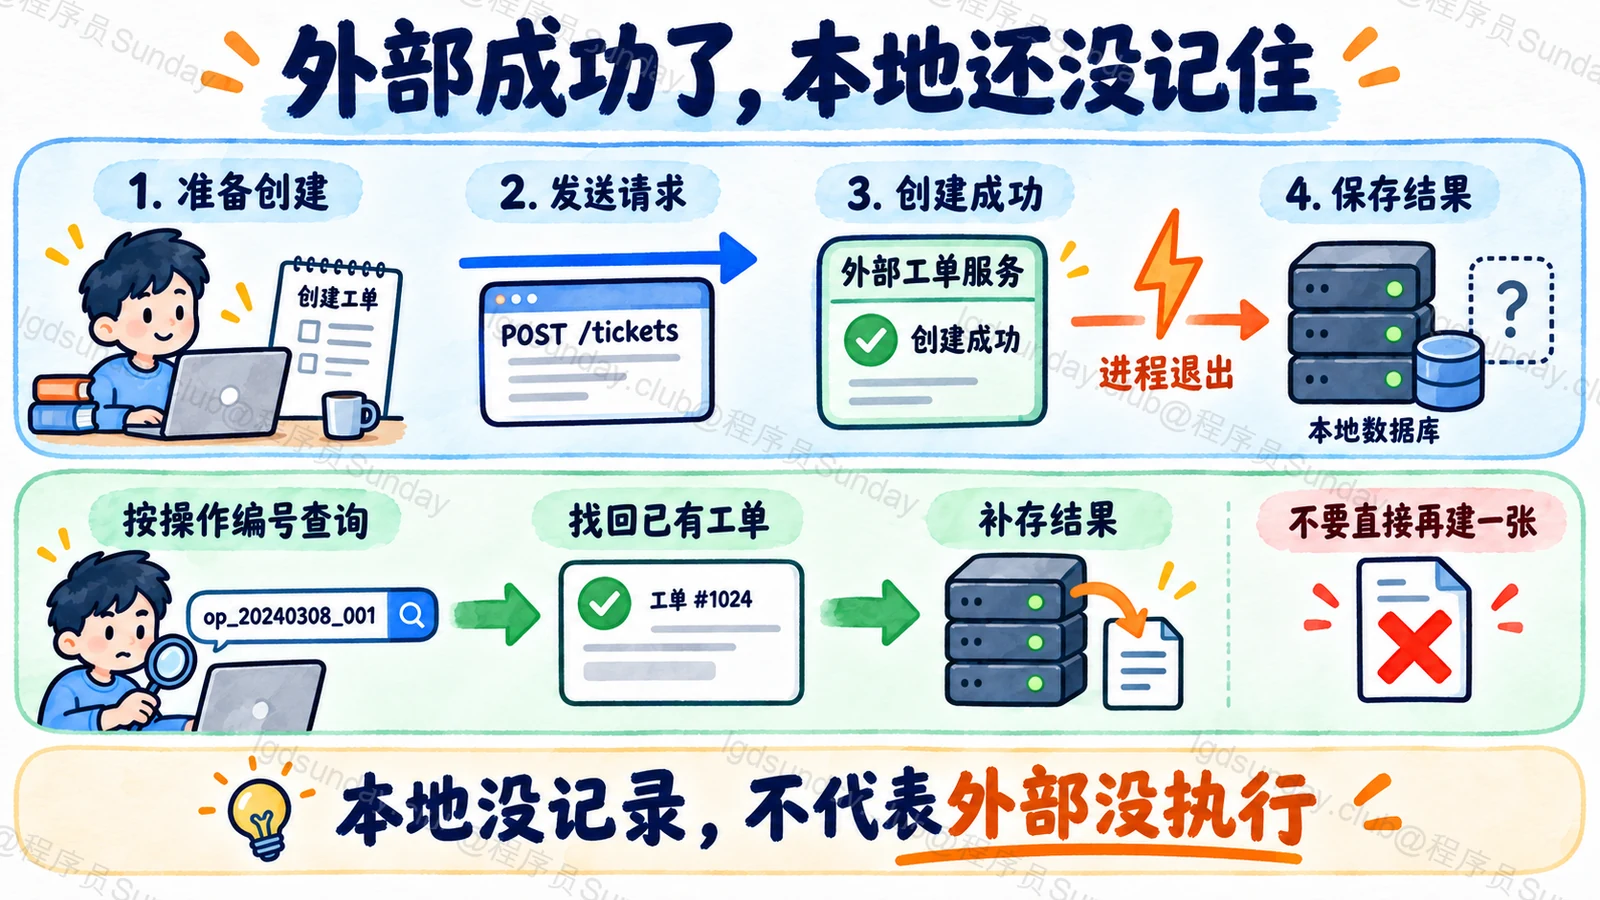
先查清楚,再决定从哪里继续
如果工单系统支持按操作编号查询,就先查询。已经成功时,补回工单编号并继续后续步骤;明确没有执行时,再发起创建。
如果支持幂等创建,也可以按它的协议使用同一编号重试,由下游返回同一操作的结果。要注意幂等键的保存期限和参数一致性要求:同一个编号不能随意换成另一份工单内容。
如果下游既不能查询,也不保证幂等,自动恢复就存在能力边界。可以把任务标记为“结果待确认”,交给人工核对或专门的对账过程,而不是为了让流程继续就盲目重发。
| 恢复时看到的状态 | 合理处理 |
|---|---|
| 完成结果已经可靠保存 | 复用结果,继续后续工作 |
| 确认没有执行过 | 重新安排执行 |
| 请求可能已发出,结果未知 | 查询、幂等重试或人工确认 |
| 正在等待用户审批 | 保持等待,不能自行批准 |
这是业务恢复策略,不是任何框架的通用自动保证。Temporal 的执行说明也说明了工作进程退出、超时和重试之间的关系;能够重试,与外部动作不会重复,不能画等号。
多个执行器抢到同一任务,怎么办?
服务重启后,可能同时有两个实例扫描到这项未完成任务。仅仅判断“状态是不是运行中”不够,因为它们可能在同一时刻读到旧值。
一种设计是通过数据库条件更新或任务系统的原子领取机制,取得带有效期的执行权。执行器定期续期;超过约定时间后,其他实例才可以接管。
但有效期到了,不代表旧进程已经停止。它可能只是网络中断,稍后又继续运行。因此还需要给执行权带版本:接管后版本递增,旧执行器提交进度时,存储层拒绝过期版本。
这通常称为 fencing,也就是用版本把旧执行者隔开。它只有在相关写入方实际检查版本时才有效;仅在内存里保存一个版本号,挡不住旧进程向外部服务发请求。
因此,外部动作仍需幂等、受控的执行入口,或者下游支持的版本检查来配合。任务锁解决谁负责推进,业务操作协议解决重复副作用,两者职责不同。
怎样验证不是“理论上能恢复”?
针对工单案例,主动在几个位置终止执行:发请求之前、外部成功之后、本地保存之后,再启动新的执行器。检查最终是否只有一张工单,返回给用户的编号是否正确,任务是否能到达合理的终态。
再模拟两个执行器同时接管、旧实例恢复运行,以及下游长期不可用。预期不一定都是“自动成功”,也可能是保留清楚的待确认状态。关键是不能悄悄重复动作,更不能把未知结果报告为已完成。
具体上线前,还要在实际使用的队列、存储和下游系统中做这些检查。演示环境能恢复,不代表换一套基础设施之后,原来的假设仍然成立。
面试官继续追问
从 Checkpoint 恢复,会从崩溃的那一行代码继续吗?
通常不能这样理解。恢复边界取决于框架的节点、任务和结果持久化方式,部分代码可能重新执行。设计时要查清自己的框架保存到什么粒度,把有副作用的动作单独管理,不能把普通进程内调用栈当成持久状态。
恢复后模型生成了另一份工单内容,怎么办?
已经准备提交的操作,应保存被确认的参数和稳定标识。恢复时先处理这次操作的结果,不能让模型重新生成不同参数,却继续沿用原来的幂等键。如果业务确实需要修改,应该作为新的明确操作处理。
重启时程序也升级了,旧状态还能用吗?
要检查状态结构、流程版本和工具参数是否兼容。可以让旧任务继续使用对应版本,或者执行经过验证的状态迁移。不能默认新代码一定能理解旧 Checkpoint,恢复测试也应该包含升级场景。
面试速记卡
- 任务持久化:保存进度、参数和结果,不只保存聊天文字。
- 未知结果:没有本地成功记录,不等于外部没有成功。
- 稳定操作编号:跨重试识别同一次业务动作。
- 执行权控制:原子接管,拒绝过期执行者提交,并配合外部幂等。
- 恢复验收:在关键故障位置测试,允许明确待确认,不允许假成功。
