
🧑💻 面试官:Agent 调“创建工单”工具,五秒后超时。模型说再试一次,你会让它调用吗?
🙋♂️ 我:不能直接照做。超时只表示应用没收到确定结果,工单可能已经创建成功。再调一次可能产生两张工单。
🧑💻 面试官:那监控查询超时,你也不重试?
🙋♂️ 我:查询一般没有写入副作用,可以在限定次数和时间预算里退避重试。创建工单属于写操作,要先用操作 ID 查状态,或者带同一个幂等键再请求。
🧑💻 面试官:查状态也失败了呢?
🙋♂️ 我:就保持“结果未知”,告诉 Agent 不要自行重复写入。可以进入人工核对或稍后对账,而不是让模型猜它失败了。
超时后最该分清的,不是“要不要重试”,而是这次操作有没有可能已经产生副作用。
面试速答(60 秒版)
Agent 调工具超时,先把它看成结果未知,而不是操作失败。查询类工具通常可以设置超时、有限次数的退避重试;创建、支付、发信这类写操作不能让模型直接再调一次,因为第一次可能已经成功。
对写操作,我会在应用层给这次业务动作一个稳定的操作 ID 或幂等键。重试时继续使用同一个键,或者先查操作状态,确认没有执行再处理。如果下游不支持幂等,也查不到结果,就停在待核对状态,必要时人工介入。
同时把“调用超时”“确认失败”“确认成功”三种状态明确反馈给 Agent,并限制总轮次、重试次数和时间预算。模型负责选择下一步,不能代替系统判断某个副作用有没有发生。
知识点详解:为什么超时不是一次普通的失败
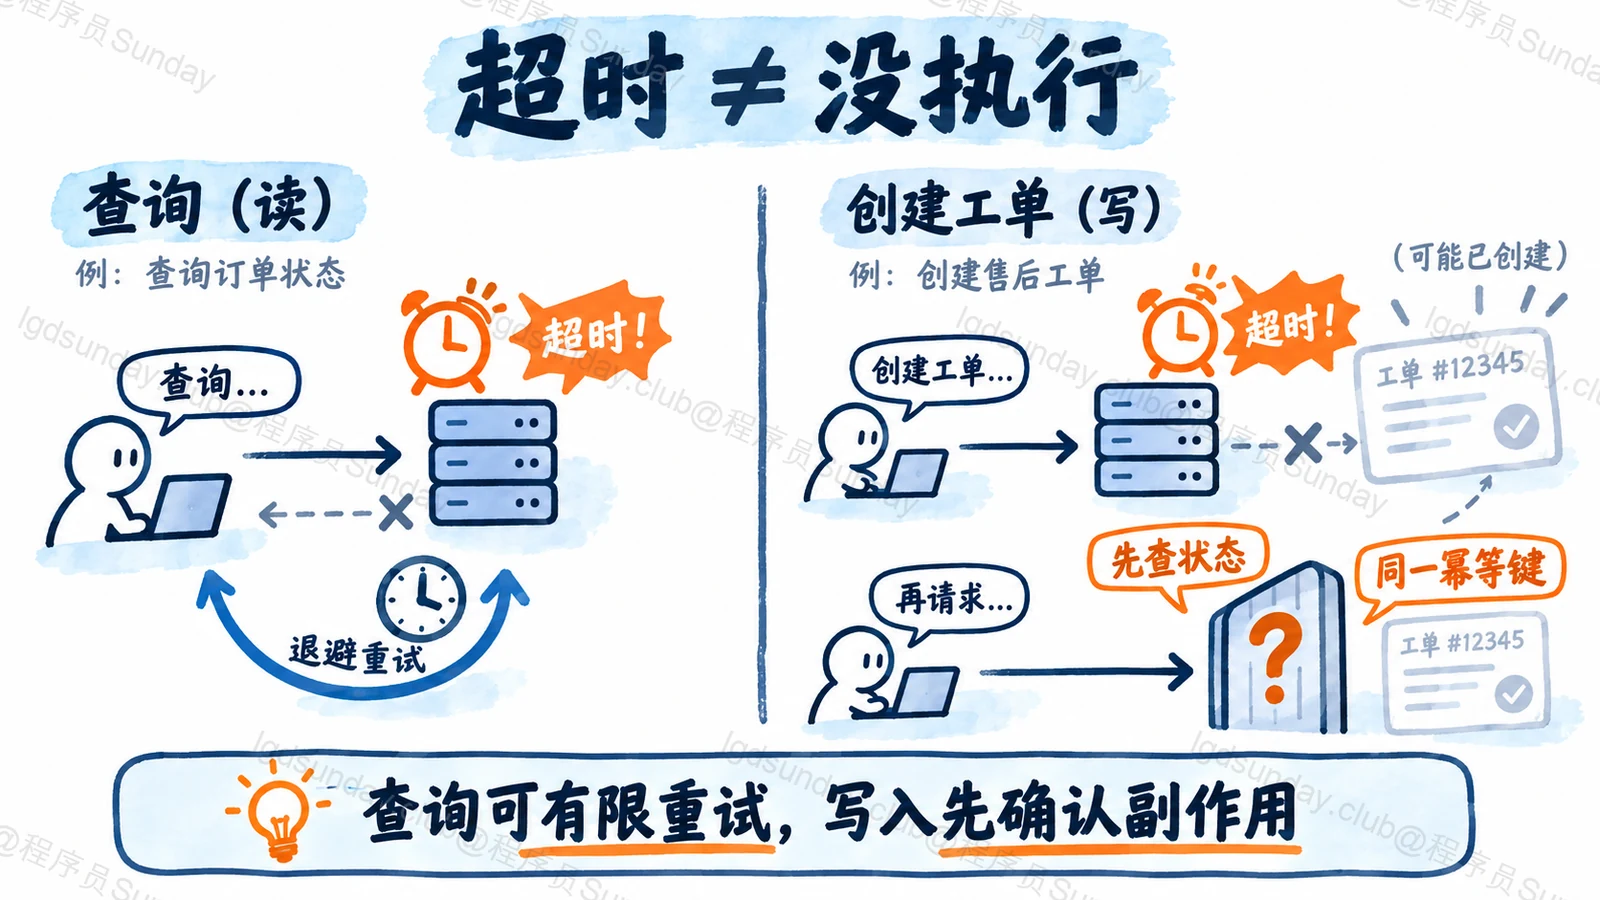
请求可能已经走到下游
假设用户要求创建一张故障工单。Agent 调用工具,后端把请求发给工单系统。工单系统已经创建成功,但回包途中网络断了。调用方看到的是超时,真实世界里却已经有工单。
如果运行器把这次工具结果写成“失败”,模型可能立即再次创建。于是用户只提了一次需求,系统却建出两张单。工具链路中的“没收到成功响应”和“没有执行成功”,必须是两个概念。
读、写工具要采用不同策略
查询指标、读取工单状态这类读操作,通常可在总体预算内重试,但也要加退避和抖动,避免服务故障时所有 Agent 一起反复请求。重试次数不能无限,否则一个步骤就吃光任务预算。
写操作则先设计幂等:例如每次“为事件 X 创建工单”生成固定操作 ID,下游重复收到同一 ID 时返回同一结果,而不是再创建一张。若下游没有幂等支持,就要查询是否已有对应工单;查询也不可靠时,保留未知状态并转人工或对账。
这里的幂等不是给每次重试生成一个新 ID。新 ID 只会让下游把它们当成不同操作。ID 要绑定同一个业务意图,并在重试间保持不变。
Agent 看到的工具结果要说清状态
给模型返回一句“工具失败,请重试”,很容易诱导它再次写入。更好的结果是结构化说明:本次操作 ID、当前状态为“已确认成功/已确认失败/结果未知”、允许的下一步,以及是否需要人工确认。
运行器还要守住最大轮次、总超时和工具调用预算。否则 Agent 会在“超时—重试—再超时”里打转,既增加费用,也可能放大下游故障。
面试官继续追问
设置重试三次,是不是就能解决稳定性?
不能。要先确认操作是否可安全重试,再定次数和退避。重复写入的风险不会因为次数少而消失。
模型提出“我先查一下是否成功”,这样就足够了吗?
思路对,但状态查询也要有可靠的关联 ID 和权限校验。查不到不等于没执行,尤其在下游存在延迟时。
幂等键应该绑定哪一层?
绑定用户的同一个业务动作,而非单次 HTTP 请求。这样应用重放、Agent 重试或网络重发都能归到同一次意图。
面试速记卡
- 超时:结果未知,不等于执行失败。
- 查询:预算内退避重试,并限制次数。
- 写入:先查状态或复用同一业务幂等键。
- 不确定:保留待核对,不让模型猜测后重复写入。
- 运行器:控制总轮次、时间与副作用。
