
🧑💻 面试官:我们给运维 Agent 接了监控、日志、发布记录等几十个工具,能力应该更强了吧?
🙋♂️ 我:能做的事更多了,但任务效果还要测试。工具用途接近、说明不清楚时,模型可能选错。
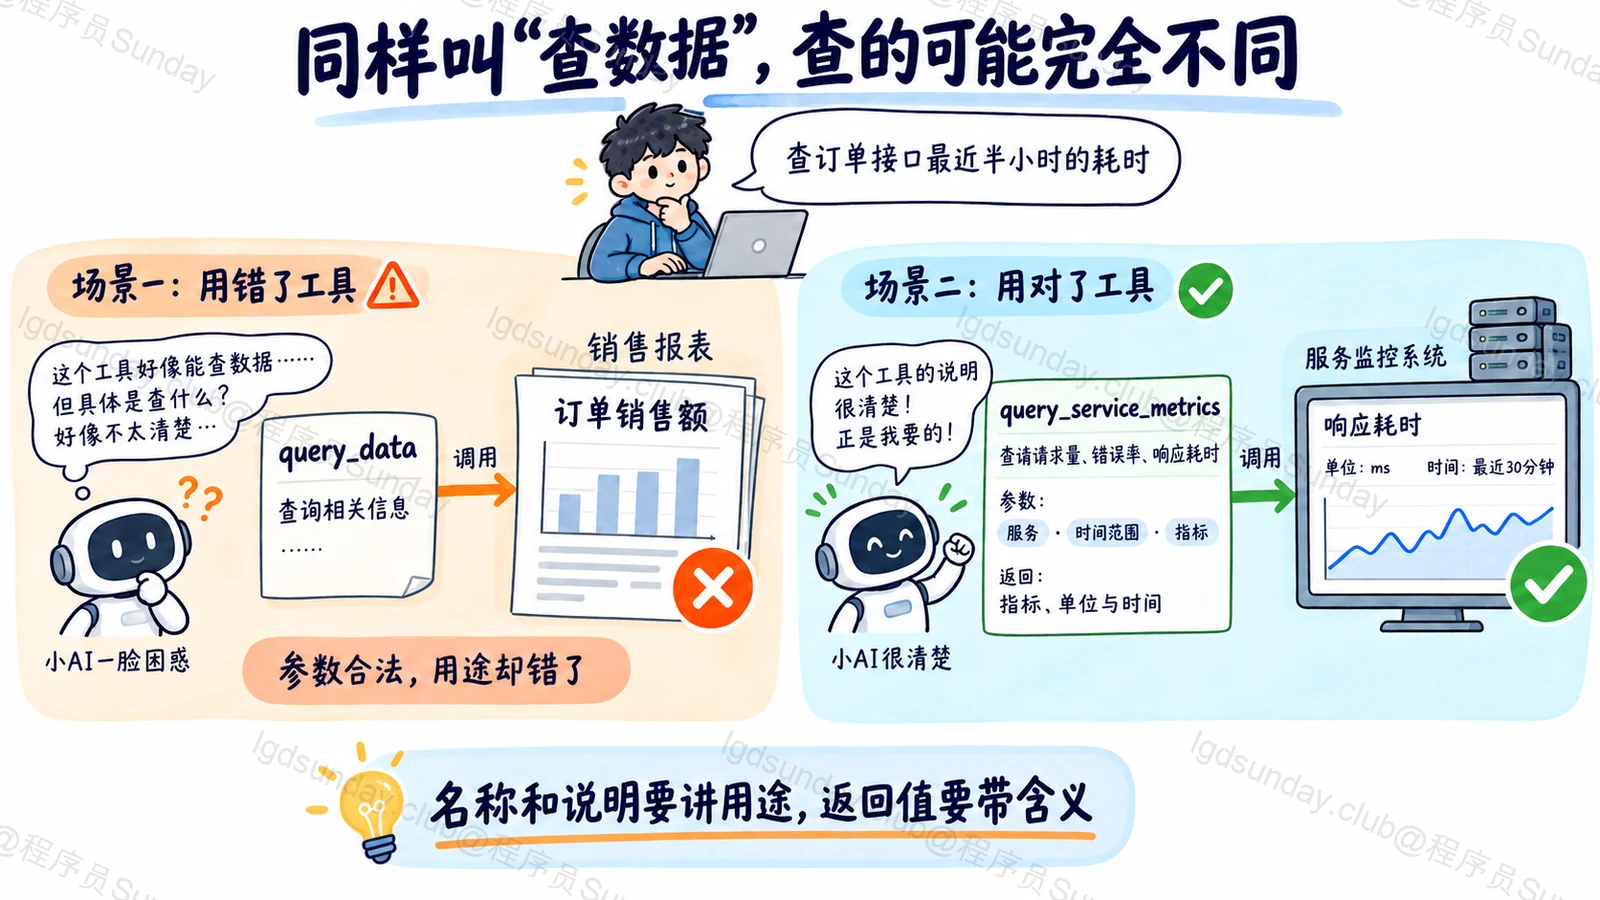
🧑💻 面试官:用户让它查订单接口最近半小时为什么变慢,它调用了 query_data,拿回来一张订单销售表。参数都合法,为什么还会错?
🙋♂️ 我:参数合法只说明调用符合格式。这个工具查的是业务数据,不是接口性能,选择工具这一步就错了。
🧑💻 面试官:那把名字改清楚就够了吗?如果有几百个工具,每次都给模型看?只给几个,又怕它缺少需要的能力。
工具接上以后,还要让模型知道什么时候该用它,并确保这轮能找到真正需要的工具。
面试速答(60 秒版)
Agent 的工具不是越多越好。工具多了,模型可以处理更多类型的任务,但如果把大量相似的工具定义一次性放进去,也会增加输入长度,让选择变得更容易混淆。
我会先检查每个工具有没有讲清用途:什么时候用、需要哪些参数、会返回什么,以及它不能做什么。例如“查询接口耗时”和“查询订单销售数据”,就不应该都叫查询数据。
工具确实很多时,可以先按任务提供相关的一组,或者让模型按需搜索工具,再加载完整定义。不过,筛选错了也会让 Agent 缺少能力,所以不能只看工具数量减少了多少。
最后要用真实类型的任务检查:需要的工具有没有被提供,模型有没有选对,参数是否正确,结果是否足够继续处理。至于权限,无论工具有没有展示给模型,都必须在真正执行时由服务端检查。
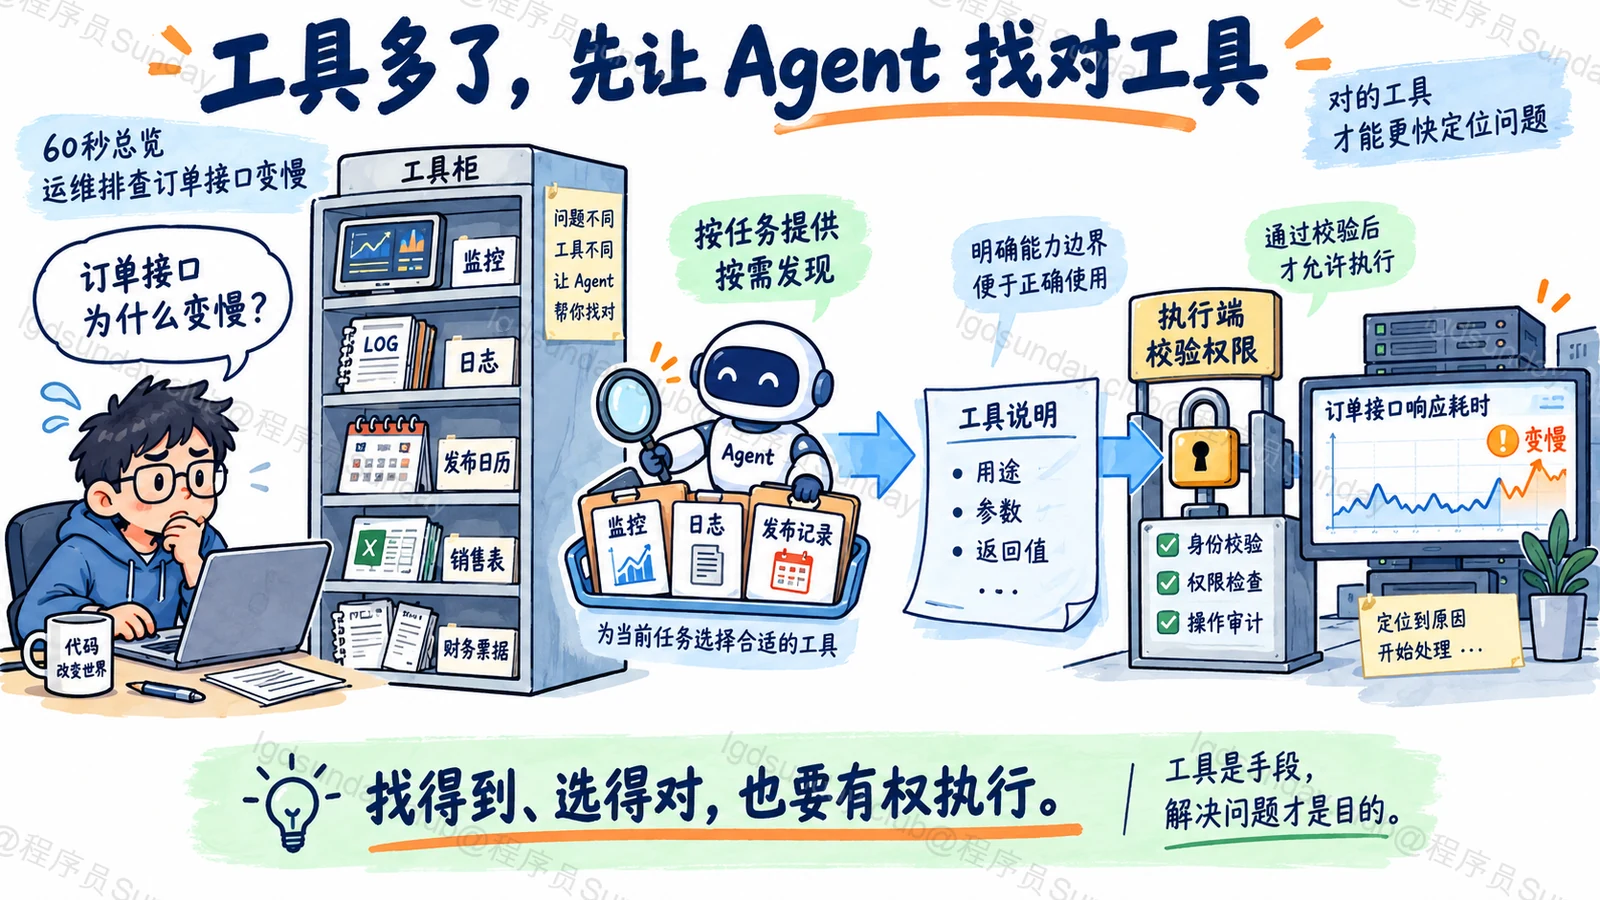
知识点详解:模型拿到的不是后台接口列表
接口能调用,不代表模型知道该什么时候调用
假设咱们在做一个运维助手,用户交给它一个任务:“排查订单接口最近半小时突然变慢的原因。”
人接到任务,会先想有没有性能指标,再看慢查询日志或最近的发布。但模型不知道咱们公司哪个系统存着什么数据。它通常先看到应用提供的工具名称、说明和参数定义,再决定请求调用哪个。
如果列表里有 query_data、get_info、search_records,说明都只写“查询相关信息”,那模型很难判断哪个能查接口耗时。
因此,工具定义不是把后端方法名抄过来就完成了。它还需要把开发者知道、模型却不知道的使用条件写出来。Anthropic 的工具设计文章特别强调了这种信息差:不能依赖调用者默认理解内部术语和输入含义。
先写清工具的用途,再检查参数和返回结果
咱们把查询指标的工具整理一下:
| 工具定义中的内容 | 这个例子里应该说明什么 |
|---|---|
| 名称 | query_service_metrics,查询服务性能指标 |
| 适用情况 | 查看某个服务的请求量、错误率和响应耗时 |
| 不负责的事 | 不查询订单销售额,不返回逐条请求日志 |
| 输入 | 服务标识、起止时间、指标;说明时区和支持的指标值 |
| 输出 | 指标名称、单位、时间范围、采样间隔与对应数值 |
这样,模型不仅更容易选中它,也更容易把参数填对。
例如,“最近半小时”需要转成起止时间。服务标识究竟是 order-api 还是系统内部的数字 ID,也应该讲清楚,必要时提供查询标识的办法。不能要求模型凭空知道后台编码。
返回结果同样重要。只给一个 320,它怎么知道是 320 毫秒、320 次请求,还是某个错误码?结果里带上指标、单位和时间,后续才有办法判断是不是异常。
如果这次没有查到数据,也要和“错误率为零”区分开。否则工具已经执行成功,模型却因为误读结果,得出了“服务完全正常”的结论。
这些信息不一定都要写成长篇描述。参数类型、必填项、枚举值可以由 Schema 表达;什么时候用、哪些情况不适用,则需要用简洁的文字说清楚。
几百个工具,为什么不一次性全部放进去?
少量工具、定义也不长时,全量提供很直接,没有必要先搭一套搜索系统。
可如果监控、销售、财务、权限管理各有一大批工具,用户明明只想查接口变慢,输入里却带着很多不相关定义。这既占上下文,也让模型多出许多没必要考虑的选项。功能和名字越接近,越需要小心混淆。
这时有两种常见处理方式。任务范围明确,就由应用先提供相关工具组;任务可能跨系统,就保留一个发现工具的入口,让模型按需求搜索,再加载匹配工具的完整定义。按需发现和加载就是 Anthropic 工具搜索方案采用的思路之一。
还是订单接口这个任务。开始可以提供服务指标、日志和发布查询。假如后面发现需要查看数据库索引,而当前没有这个工具,Agent 应该能继续发现对应能力,或者明确报告缺少权限或工具,而不是拿一个用途不对的接口凑合。
所以,筛选不是把工具删得越少越好。必须检查任务真正需要的工具有没有进入候选范围。工具选择前的筛选本身,也可能犯错。
工具“看不见”和工具“不能执行”,是两件事
假设这轮只给模型展示了查询工具,没有展示重启服务的工具。能不能因此认定它绝对不会请求重启?
不能。模型输出的工具名仍然是不可信输入。应用要检查这个名字是不是当前允许调用的工具,执行器还要检查用户是否有权操作目标服务,以及动作是否需要审批。不能收到一个字符串,就动态找到同名后台函数执行。
只读查询与修改操作也应有清楚的边界。一个叫“检查服务”的工具,如果顺手重启了服务,会让模型和用户都难以预料后果。高风险动作要明确命名、说明影响,并在执行端落实限制。
这和提示词写得多认真无关。提示词可以帮助模型选对,权限检查负责阻止不允许执行的调用,两者都需要。
面试官继续追问
合成一个万能工具,只留一个入口,是不是更简单?
工具数量少了,但选择困难可能只是被挪进了参数。如果一个入口接收任意操作名和任意命令,模型仍然要理解所有用法,权限也更难限制。可以封装固定、常用的组合查询;但不应为了减少数量,把所有操作塞进一个没有清楚边界的入口。
怎么证明是工具定义改好了,而不是模型这次碰巧选对?
保留同一批任务,覆盖正常查询、相似工具、缺少工具和无权操作等情况,在相同模型配置下比较改动前后。分别记录候选工具、实际调用、参数和任务结果。若业务允许多条正确路径,就检查是否满足任务要求,不强行规定只能用某一个工具。
工具名字不同,但实际做的是同一件事,要都保留吗?
先弄清差异。如果只是历史系统留下的别名,可以在应用层收敛成一个清楚的入口。如果查询范围、时效或权限不同,就保留差异并明确说明,不能为了“简洁”把重要条件藏起来。
面试速记卡
- 工具数量:能力覆盖更多,不代表选择一定更准确。
- 工具定义:写清适用情况、输入含义、返回内容与限制。
- 大工具库:按任务提供或按需发现,同时检查有没有漏掉所需能力。
- 调用正确性:工具选对、参数合法、业务执行正确要分别验证。
- 权限边界:模型看到什么不等于有权做什么,执行端必须检查。
