
🧑💻 面试官:你们做了一个内部政策问答,评测集里有一百个问题,答对了八十个。能上线吗?
🙋♂️ 我:还不能只看这个总数。要先知道另外二十个是没检索到证据,还是检索到了却被模型误读;还要单独看权限、过期政策这类高风险题。
🧑💻 面试官:如果模型最后答对了,检索过程有问题还重要吗?
🙋♂️ 我:重要。它可能凭预训练知识猜对了,或者引用了错误版本。下次问题稍微变一下就可能答错,用户还以为这句话有知识库依据。
🧑💻 面试官:那你会怎样组织评测?
🙋♂️ 我:每题保留期望答案和必须命中的证据,分别查候选召回、最终提供给模型的上下文,以及回答是否得到证据支持。最后再看业务答案是否正确,把错误归到具体环节。
“答错”只是结果;评测要指出错误发生在找证据、用证据,还是形成最终答案。
面试速答(60 秒版)
我会把 RAG 的评测分成三层。第一层看检索:标准证据有没有进入候选和最终上下文;第二层看证据使用:模型说出的关键结论能不能从提供的材料里找到依据;第三层看业务答案:它是否回答了问题,条件、数值和结论是否正确。
评测集不能只有问题与“对错”标签。每道题还要记录标准证据、文档版本、用户权限,以及无法回答时应不应拒答。这样遇到错题,才能知道是解析切片漏了、召回排序排错了,还是生成阶段把例外条件读反了。
自动指标可以帮忙筛查,但高风险题要人工复核。上线前还要按问题类型看表现,不能用总体平均值掩盖“退款金额总答错”这样的集中问题。
知识点详解:从问题到答案,逐层给失败定位
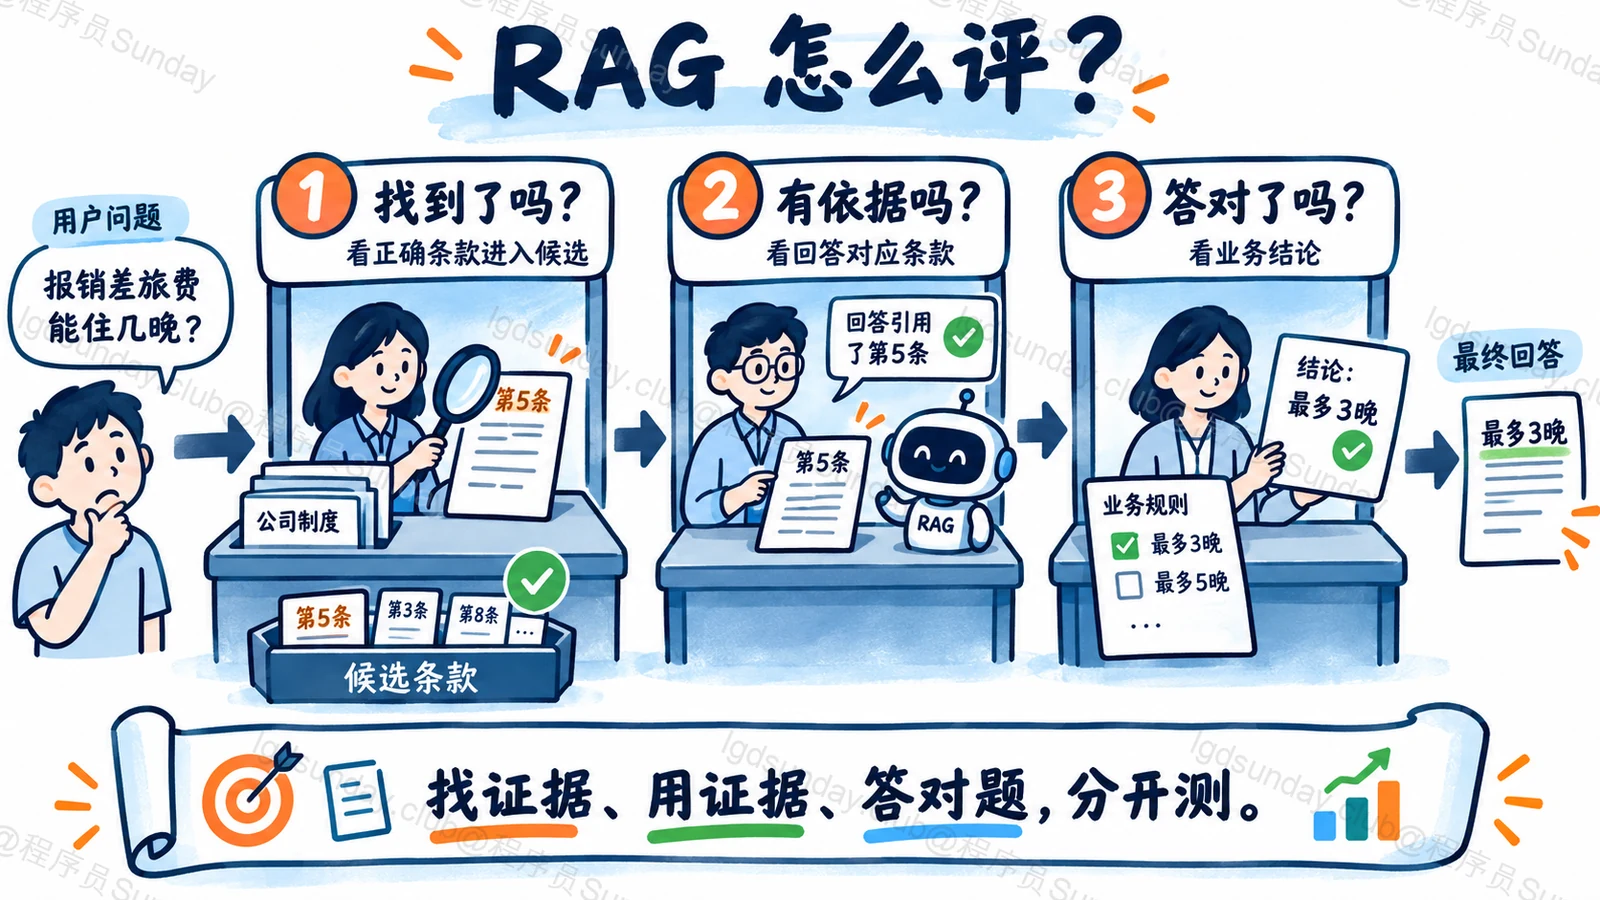
第一层:该找到的证据找到了吗
例如题目问“试用期内退款的例外条件”,标准证据是政策 V3 的第六条。检索 Top 20 没有它,说明问题发生在解析、切片、索引或召回;即使最终回答碰巧正确,也不能算检索链路合格。
如果 Top 20 有它,但最终只把前 5 条给模型,而它排在第 12 条,说明候选召回没漏,最终上下文选择出了问题。两种问题的修法不同,所以要分别记录“进入候选”和“进入模型上下文”。
第二层:回答有没有受到证据约束
目标条款已经送到模型,模型却说“所有试用期订单都可以退款”,漏掉条款里的限制。这是证据使用问题。可以检查提示词、上下文截断、冲突文档和生成模型能力;不是继续把召回 K 值调大。
“有引用”也不代表忠实。需要检查回答里的每个关键主张能否被引用片段支持,特别是数字、时间、例外和否定条件。自动忠实度评分可用于批量发现可疑回答,但复杂政策仍需人审。
第三层:对用户来说真的答对了吗
一个回答可能完全忠实于检索材料,却引用了过期版本,业务结论仍然错。也可能证据正确、表述却避开了用户的实际问题。因此还要拿标准答案和业务规则核对最终结论。
评测集最好覆盖正常问法、同义改写、多条证据组合、无答案问题、权限差异和版本切换。每次改切片、重排或提示词,就用同一批题跑回归,看改善发生在哪里,也看是否把原本正确的题弄坏了。
面试官继续追问
RAGAS 这类自动指标能代替人工评测吗?
不能。它们适合规模化筛查和版本对比,但评分本身也会受参考答案、评判模型和题目类型影响。权限泄露、金额错误等必须单独设门槛并人工抽查。
没有标准证据,能不能先评?
可以先做回答可读性、引用格式等弱评测,但无法可靠判断“检索有没有找对”。应逐步为关键问题标出必要证据,至少建立小而精的金标准集。
总体正确率提高了,为什么还不一定能上线?
可能高频题提升了,少量高风险题却退步。要按业务风险分组,看拒答、权限和版本问题;这些不能被平均数冲淡。
面试速记卡
- 检索层:标准证据进没进候选和最终上下文。
- 忠实层:关键主张是否有上下文依据。
- 答案层:业务结论、条件与版本是否正确。
- 评测集:问题、标准答案、必要证据和权限条件一起标。
- 上线判断:看分组风险,不只看平均分。
