
🧑💻 面试官:Agent 查了几十轮日志,上下文快满了,你怎么办?
🙋♂️ 我:可以保留最近几轮,把前面的内容总结一下,让任务继续执行。
🧑💻 面试官:用户最开始说“只查原因,不要修改数据”,总结时漏掉了呢?
🙋♂️ 我:这种限制需要单独保存,不能只依赖聊天摘要。
🧑💻 面试官:那一条已经排除的原因、一次还没拿到结果的工具调用,又该不该保留?
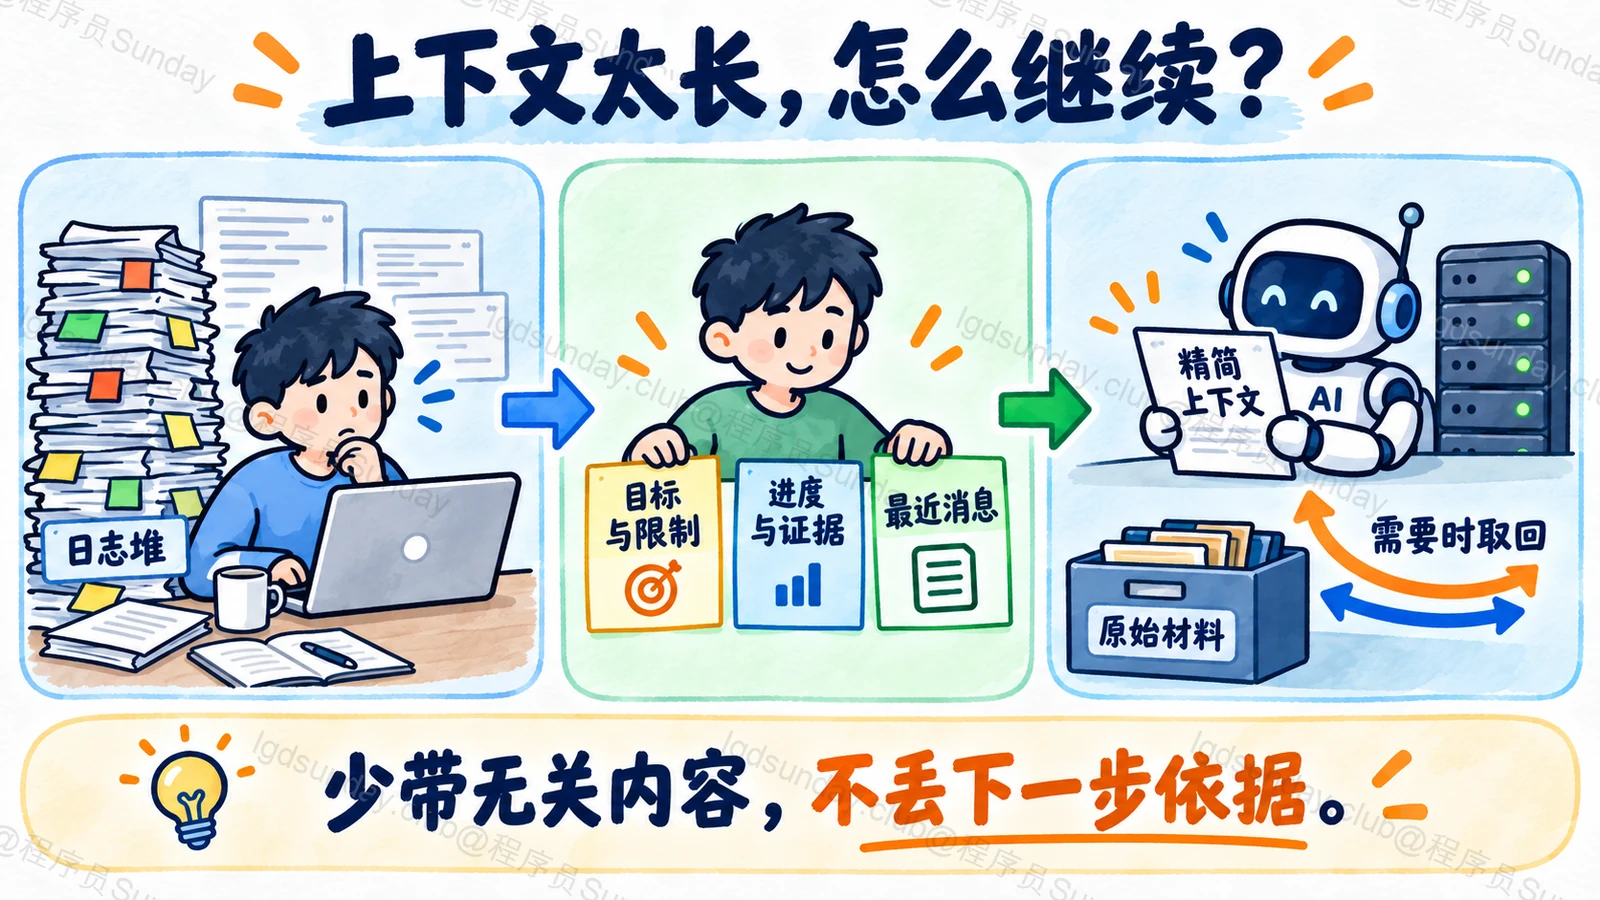
这道题要抓住的不是“怎么把文字变短”,而是:压缩之后,Agent 还有没有足够的信息,继续做对下一步。
面试速答(60 秒版)
Agent 的上下文压缩,不能只是把聊天记录缩写一遍。因为后面的执行依赖前面留下的目标、限制、证据和进度,漏掉其中一项,任务就可能走偏。
因此,我会先把这些内容分开处理:当前目标和操作限制单独保留;已经完成的过程整理成摘要;最近还在使用的信息,以及尚未结束的工具调用,继续保留完整关系。很长的日志可以存到外部,只把结论和查询位置带进下一轮。
同时,压缩要给下一轮工具结果和模型输出留出空间,不能等到窗口完全装满才处理。
最后还要用任务回放检查:压缩后有没有忘记限制、重复做过的事,或者把猜测当成结论。节省了多少 Token 只是收益,任务能不能接着做对,才是判断依据。
知识点详解:上下文压缩到底应该保留什么?
先弄清楚,下一轮为什么还需要前面的内容
假设咱们让 Agent 排查一个问题:昨天开始,销售报表生成得特别慢。只允许查询,不允许改配置。
Agent 已经查过接口耗时、数据库日志和发布记录。此时,完整对话里可能有几万字,但下一轮真正需要的东西并没有那么多。
它需要知道:用户要查什么,目前查到了哪里,还有哪些原因没有排除,以及接下来哪些动作不能做。
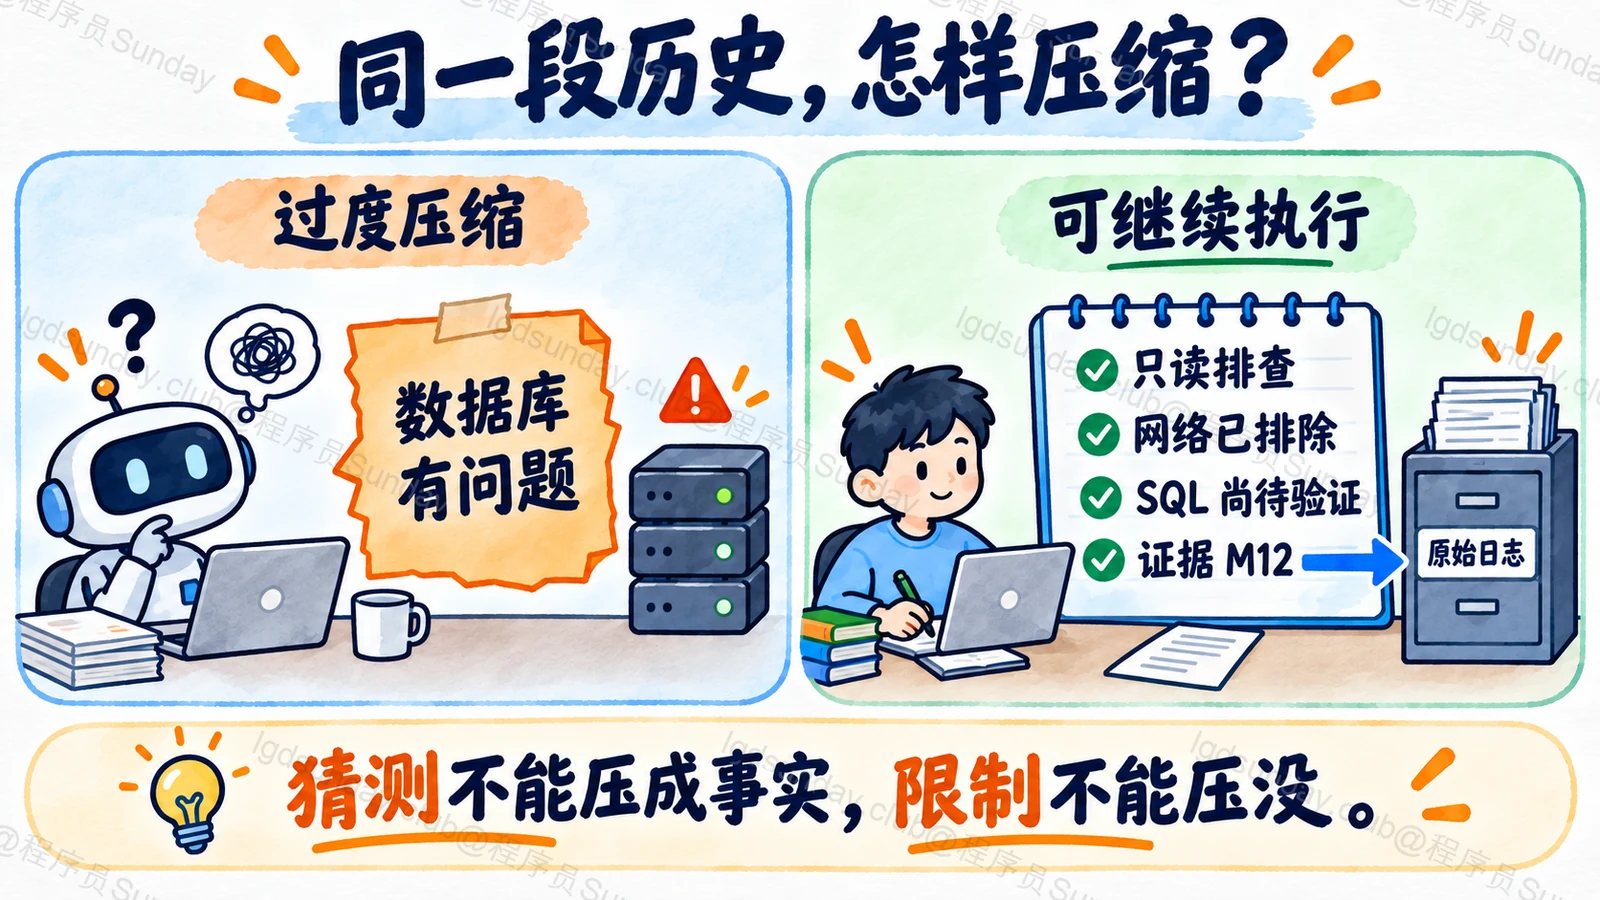
如果摘要只留下“已经查看监控,怀疑数据库有问题”,看起来很简洁,但关键区别全没了:是已经确认数据库慢,还是正在怀疑?哪次查询提供了证据?有没有排除网络问题?
这些信息会直接影响下一步。压缩不是写一篇好看的工作总结,而是在为后面的执行准备输入。
不同信息,要用不同的保存方式
在这个例子中,可以按下面的方式整理。这里是一个应用层设计示例,不是某个框架要求的固定格式。
| 信息 | 压缩后怎样处理 | 为什么 |
|---|---|---|
| 排查报表变慢,只允许查询 | 从任务状态中保留明确字段 | 不能依赖摘要模型碰巧记住限制 |
| 已排除网络延迟 | 保留结论和证据位置 | 防止下一轮从头再查 |
| 某条 SQL 可能相关,尚未验证 | 保留“待验证”状态 | 不能在压缩中变成确定原因 |
| 几千行原始日志 | 外部保存,留下查询编号和关键片段 | 需要时能回到原文 |
| 正在等待结果的调用 | 保留调用与结果的对应关系 | 避免下一轮误判执行状态 |
这里尤其要注意:原始材料从上下文移出,不代表可以从系统里直接删掉。
后面如果发现两段日志相互矛盾,Agent 应该能用查询编号重新读取。否则,摘要一旦写错,就没有办法核对了。外部材料还需要有相应的保存期限和访问权限,不能只留一个很快失效的地址。
对“只允许查询”这样的限制,模型输入中要保留,工具执行前也要由后端再检查。上下文压缩做得再好,都不能替代权限控制。
一次压缩,可以怎样完成?
运行器准备下一轮输入时,先估算已经占用的空间,再为模型输出、工具说明和可能返回的新材料预留预算。
超过应用设定的预算后,可以先处理最容易缩小的部分:重复出现的日志、已经读过多次的文件、很久以前的完整工具输出。工具接口本身也可以支持分页和结果截断,不必等超长内容进入上下文之后再补救。
如果仍然放不下,再把已经结束的工作阶段整理成结构化摘要。例如:
- 当前目标:找到报表变慢的原因,只读排查。
- 已确认:接口主要耗时发生在数据库查询。
- 已排除:网络耗时没有明显变化,证据为监控查询 M12。
- 待验证:发布 R8 修改过一条相关 SQL,但还没证明它就是原因。
- 下一步:查看这条 SQL 的执行计划。
然后,把这份摘要、当前任务状态和最近仍然相关的消息组合起来,继续调用模型。这里的“下一步”只是待执行计划,不应被记成已经完成。
如果采用的模型 API 要求工具请求与返回成对出现,裁剪时也必须遵守这个消息格式,不能只删其中一半。实际规则要按所用 API 核对,不能用普通字符串截断代替消息处理。
Anthropic 的上下文工程文章讨论了压缩、外部笔记和按需取回材料。实际采用哪种组合,还需要看任务会持续多久,以及后面是否需要重新核对原始证据。
怎么知道它压得好不好?
可以从固定任务中选取几个执行到一半的状态,分别用完整历史和压缩后的输入继续运行,比较后续行为。
在报表案例里,要特意检查:它有没有再次排查已经排除的网络问题,有没有忘记只读限制,有没有直接把 R8 发布认定为根因,以及能不能找回 M12 的原始证据。
同时记录输入长度、延迟和压缩本身的调用成本。若摘要省下来的成本,还不够覆盖频繁生成摘要的成本,这个策略就需要调整。阈值也应该根据任务和工具结果大小来定,不存在一个适合所有 Agent 的固定百分比。
面试官继续追问
最近几轮保留完整,旧消息全部删除,可以吗?
短任务可以尝试,但不能把“消息旧”直接当成“不重要”。最早的用户限制可能一直有效。可以使用滑动窗口保留近期消息,同时从任务状态补入仍然有效的目标、约束和未完成事项,再通过回放验证是否足够。
连续总结很多次,会不会越总结越失真?
会有这个风险。因此重要事实最好有独立字段和原始来源,不要只维护一段不断被改写的摘要。更新时区分“新证据”“推测变化”和“用户修改要求”;需要核实的地方回读原文,不能仅凭上一次摘要继续推导。
换成长上下文模型,是不是就不用做这些了?
容量压力可能减轻,但无关材料、旧结论和当前要求冲突的问题仍然存在。而且长输入会影响成本和延迟,具体程度取决于模型与缓存机制。是否换模型,要和当前任务的成功率一起比较,不能只看窗口大小。
面试速记卡
- 压缩目标:让 Agent 带着必要信息继续执行,不只是减少字数。
- 必须保留:当前目标、有效限制、关键证据、未完成事项。
- 长材料:可以移出上下文,但要能按来源重新取回。
- 处理时机:为下一轮输出和工具结果预留空间。
- 验证方式:检查压缩后的行为有没有遗忘、重复或误判。
