
🧑💻 面试官:用户问“星河报表的标准版支持导出 PDF 吗”,知识库回答正常。接着问“企业版呢”,它却开始介绍企业版的成员管理。你会查哪里?
🙋♂️ 我:先看第二次实际用了什么内容去检索。如果只拿“企业版呢”去搜,导出 PDF 这个条件就丢了。
🧑💻 面试官:聊天记录已经保存了,回答模型也能看到,还不够吗?
🙋♂️ 我:要看检索这一步有没有用到记录。只在生成答案时补历史,前面搜错的资料不会自己变正确。
🧑💻 面试官:那把全部聊天记录一起向量化呢?如果用户突然说“换成 CSV”,你还会沿用 PDF 吗?
多轮检索先解决一个问题:这一轮到底在问什么。历史负责补全省略的信息,当前问题负责更新已经改变的条件。
面试速答(60 秒版)
多轮 RAG 不能只拿用户最后一句话去检索,因为“企业版呢”“这个怎么开通”这样的追问,单独看并不完整。
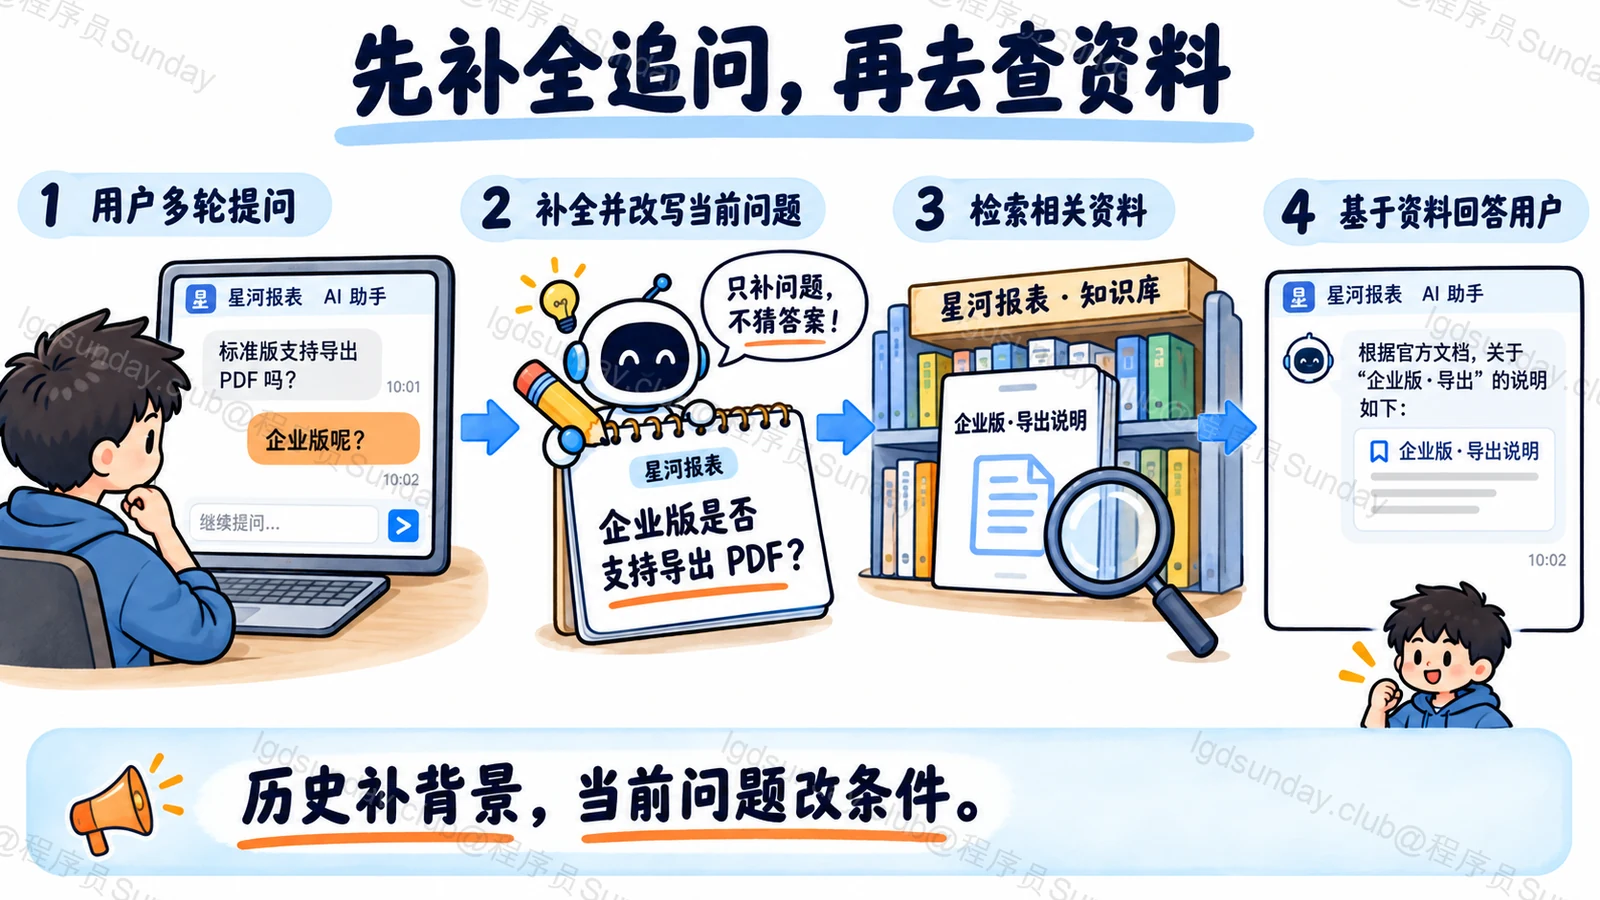
一种常见做法是,先结合相关聊天记录,把当前问题补成能够独立理解的检索问题。例如,把“企业版呢”补成“星河报表企业版是否支持导出 PDF”,再去知识库查资料。
这里要注意,补全问题不是提前回答问题,也不能把用户刚改掉的条件又带回来。用户说“换成 CSV”,这一轮就应该查 CSV;如果历史里有多个对象,“这个”到底指谁不清楚,就先确认。
查到资料之后,再把原始问题、必要历史和本轮资料交给模型回答。排查错误时,我会分别检查补全后的问题和检索结果,判断到底是理解错了追问,还是问题理解对了、资料没找到。
知识点详解:让检索器知道“企业版呢”在问什么
保存了聊天记录,为什么还是接不上话?
假设咱们在做一款虚构产品“星河报表”的文档助手。它有标准版和企业版,用户正在了解报表导出功能。
第一问很完整:“星河报表的标准版支持导出 PDF 吗?”产品、版本、功能、文件格式都在里面。检索器据此查找,很容易把范围缩到相关文档。
第二问只有四个字:“企业版呢?”
人能理解,是因为还记得刚才在聊什么。检索器能不能理解,则要看应用实际传给它的内容。如果它只收到这四个字,就不知道用户想了解企业版的导出、权限还是价格。
这里经常出现一个不太显眼的问题:聊天历史确实存进数据库了,也确实在最后发给回答模型了,但检索函数仍然只接收最新消息。于是,模型拿着完整对话和一堆不相关资料,努力回答一个前面已经搜偏的问题。
所以,先打开本次请求记录,看检索输入。不要只检查页面有没有显示历史聊天。
在搜索之前,先把省略的信息补完整
咱们可以在检索前加一步:结合相关历史,生成这一轮要搜索的问题,也就是常说的查询改写。
这一步只负责整理用户想问什么,不负责推断产品是否支持。
| 对话里已经明确的内容 | 当前追问 | 本轮检索问题 |
|---|---|---|
| 星河报表、标准版、导出 PDF | 企业版呢? | 星河报表企业版是否支持导出 PDF? |
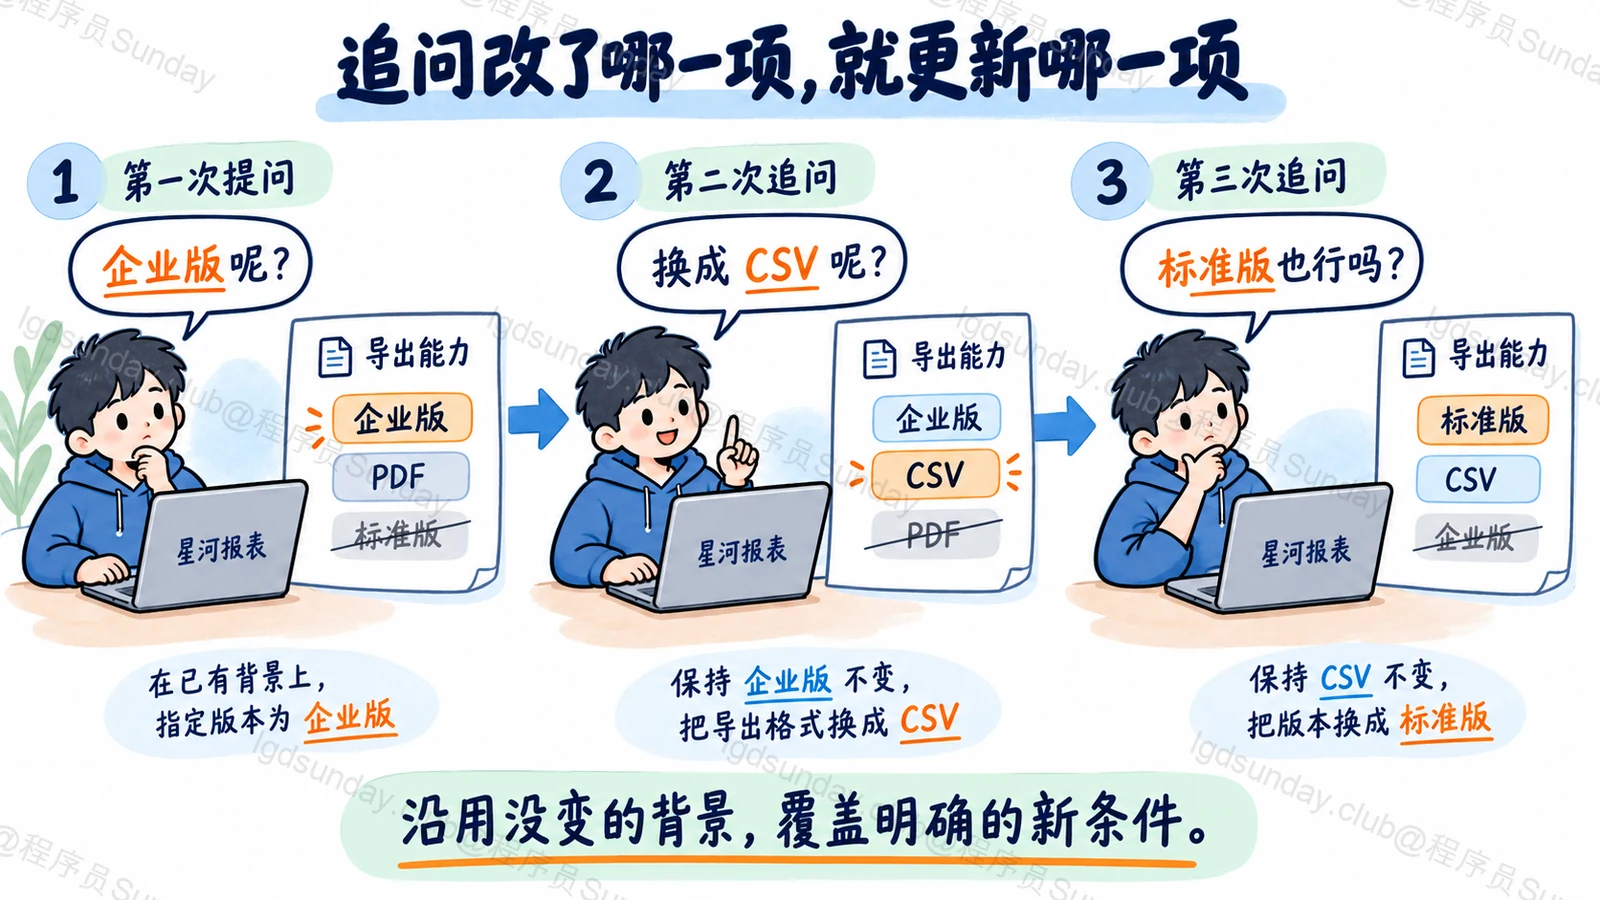
| 星河报表、企业版、导出 PDF | 换成 CSV 呢? | 星河报表企业版是否支持导出 CSV? |
| 星河报表、企业版、导出 CSV | 标准版也行吗? | 星河报表标准版是否支持导出 CSV? |
注意看,历史里的条件不是全部照搬。第二行改变了格式,第三行改变了版本;新的说法要覆盖对应的旧条件,没有改变的部分才继续保留。
LangChain 的历史感知检索实现就展示了一种这样的分工:有历史时先生成搜索查询,再交给检索器;没有历史时可以直接检索。Azure AI Search 的查询规划也可以利用会话历史补充上下文。不过,多轮检索并不要求一定使用某个框架,也不要求每次都改写。
如果用户已经把问题说完整,直接搜索往往就够了。
为什么不直接把所有历史拼起来搜?
假设这段对话前面还聊过账号开通、成员邀请、报表收费。把它们和“企业版呢”一起转成一个向量,检索器接收到的就不再是一个清楚的问题,而是几个话题混在一起。
全文放得越多,也不代表当前重点越清楚。我们真正需要保留的是这轮问题省略掉的那些条件。
简单场景里,可以从最近相关的几轮对话补全。如果用户明确说“回到前面那个导出问题”,再找到对应的话题。产品和版本长期固定时,也可以保存这些已确认的条件,但用户一旦改口,就要同步更新。
还有一种情况不能硬补。假设用户刚比较了“星河报表”和另一款产品,然后问“它支持导出吗”,上下文又无法确定“它”指谁。此时直接追问一句“你指的是哪款产品”,比猜一个名字再查资料更合适。
改写的目标是把原意说完整,不是替用户做选择。
历史能帮助理解问题,但不能代替本轮依据
查询补全以后,后端按当前用户权限去检索,再把原始追问、必要的对话背景和新找到的资料交给回答模型。保留原始问法,是为了让回答仍然接得上用户的话,而不是突然回复一篇独立产品介绍。
那上一轮助手说过的话,能不能直接当事实用?
可以用它识别对话里提到了什么,却不能因为是自己说过的,就当成已经核对过的产品能力。假如第一轮误答“标准版可以导出 PDF”,第二轮又据此介绍导出步骤,错误就会一轮轮延续。
因此,在这个产品文档场景里,功能是否存在、入口在哪里,应以本轮查到的有效资料为准。用户说“我用的是企业版”,可以帮助确定检索范围;他说“我是管理员”,也不能替代后端实际的身份和权限检查。
排查时,把原始追问、用于补全的历史、补全结果、检索文档和最终答案放到同一条记录里看。补全成了 PDF,用户实际问 CSV,就先改查询处理;补全正确但搜不到 CSV 文档,再查索引与检索;资料找对了还答错,才继续检查生成环节。
面试官继续追问
每次都用大模型改写,会不会太慢?
会增加一次调用,所以不必无条件执行。问题已经完整时可以直接检索;固定界面中已明确的产品和版本,也能由应用直接补充。对省略、指代和话题切换比较复杂的情况,再使用模型,并比较准确率与延迟。
历史被压缩成摘要以后,还能用吗?
可以,但要检查摘要有没有保留当前对象和用户最后一次修改的条件。摘要如果还写着 PDF,后面就可能一直搜错。重要条件可以单独保存,含义不确定时回看原消息,不把摘要当成不可修改的事实。
怎么测试多轮效果,单轮问答集不够吗?
不够。测试输入本身就要包含连续对话,覆盖省略、改口、换话题、回到旧话题,以及指代不清。除了最终回答,还检查每轮检索问题有没有保留正确条件。只把这些问题改写成完整句再测试,会把真正的难点提前消掉。
面试速记卡
- 常见原因:历史留在聊天层,检索仍然只看最后一句。
- 查询改写:补全这一轮的问题,不提前编出答案。
- 条件处理:沿用没变的背景,覆盖用户明确改掉的条件。
- 歧义处理:指代不清就确认,不替用户猜对象。
- 排查顺序:先看补全的问题,再看检索资料,最后看回答。
