
LangGraph 的 State、Node、Edge 各负责什么?并行节点同时更新状态怎么办?
🧑💻 面试官:你说用 LangGraph 做一个报表助手。State、Node、Edge 分别是什么?
🙋♂️ 我:State 保存当前任务需要共享的数据;Node 读取状态、执行一步工作并返回更新;Edge 规定或判断下一步去哪个节点。它们分别回答“现在有什么”“这一站做什么”“接下来去哪”。
🧑💻 面试官:两个节点并行查销售和退款数据,都想把结果写进 results,会怎样?
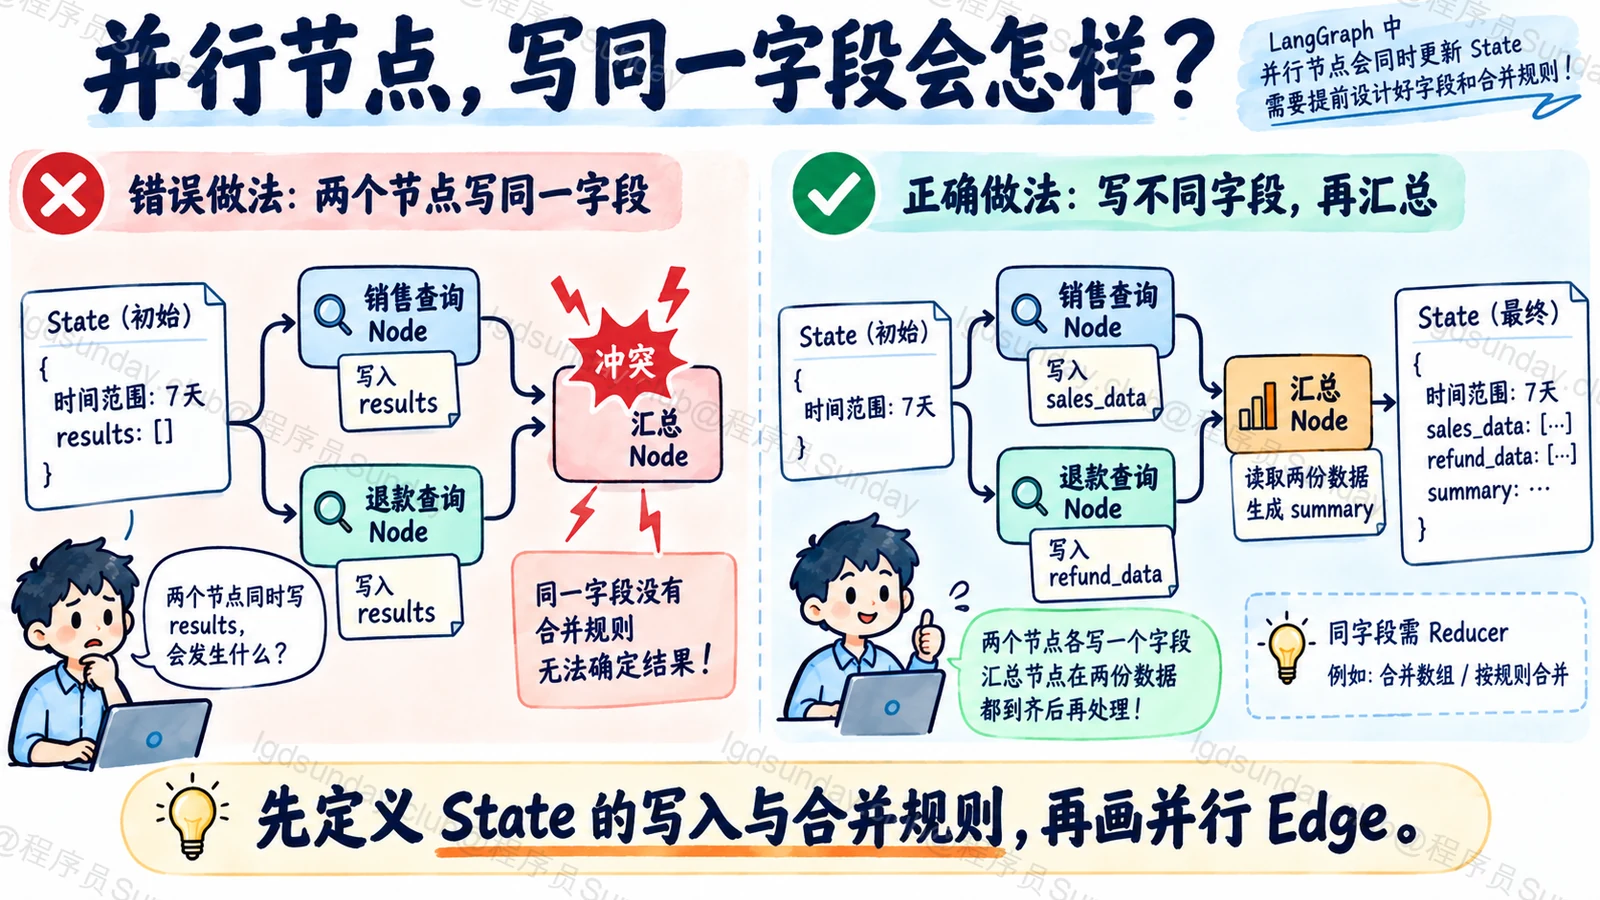
🙋♂️ 我:不能默认以为它会把两个结果自动拼好。要先定义 results 的更新规则,例如按来源分别存字段,或者给这个字段配置合并用的 Reducer。否则并行写同一个没有合并规则的字段,可能产生冲突。
🧑💻 面试官:那节点直接改传进来的 State 对象,可以吗?
🙋♂️ 我:面试里我会按框架推荐的心智模型来设计:节点返回它负责的部分更新,由图运行时按状态规则应用。这样更容易看清谁写了什么,也方便并行和排错。
这道题不是背三个英文名词,而是看你能否说清:数据怎么流动、节点怎么分工、并行结果按什么规则合并。
面试速答(60 秒版)
在 LangGraph 里,State 是任务当前的共享快照,Node 是处理一项工作的函数,Edge 决定下一步执行哪个节点。比如报表助手可以先有“用户要看哪段时间”的状态,随后两个节点分别查销售与退款,最后由汇总节点生成结论。
节点不需要每次返回整份 State,只返回自己产生的更新。这里最容易出错的是并行写入:如果两个节点都更新同一个字段,不能想当然地指望框架知道该覆盖、追加还是合并。默认更新通常是覆盖;同一执行步的冲突写入需要明确的 Reducer,或者让两个节点写不同字段,再由汇总节点读取。
所以我设计图时,会先画出任务需要哪些状态字段、每个字段由谁写、是覆盖还是累积,再连节点和边。图能跑通只说明流程接起来了;还要测试并行更新、分支选择以及失败后的状态是否符合预期。
知识点详解:从一个报表任务看懂图的三个部件
State:记录当前任务真正需要的数据
假设用户问:“对比本周销售额和退款额,告诉我净收入为什么下降。”这只是教学例子。我们可以把状态想成一张任务纸,记录查询时间范围、销售结果、退款结果、异常说明和最终答复。
State 不是把所有东西塞进一个巨大聊天记录。哪些数据会被后续节点用到,就给它明确的位置。比如 sales_data 由销售查询节点写,refund_data 由退款查询节点写,summary 由汇总节点写。这样我们看到一次错误汇总时,能追问是哪个字段缺了,而不是从几百条消息里猜。
状态字段还需要更新规则。默认情况下,一个节点返回该字段的新值,会替换旧值;若希望把多次结果累积成列表,就需要定义合并方式。这个合并方式在 LangGraph 里叫 Reducer。它决定“旧值 + 本次更新”最终变成什么,不是一个可有可无的装饰。
Node:完成一步工作,只返回这一步的变化
销售查询节点接收当前状态,从中拿时间范围去查销售系统,再返回 sales_data。退款查询节点做同样的事,但返回 refund_data。汇总节点读取两份结果,计算和解释净收入变化。
节点可以调用大模型,也可以只是普通代码。比如金额相减不需要让模型“思考”,直接由确定性代码计算更清楚;解释异常原因时,若需要读复杂说明,再让模型参与。节点出错也要有清楚的处理方式,不能把半成品结果当成成功更新。
LangGraph 的写法强调节点返回部分状态更新,不要求它把整张任务纸重新抄一遍。这使每个节点负责的字段更明确,也减少不相关字段被意外覆盖。
Edge:决定节点之间怎么走
固定的边可以表示“收到问题后先解析时间范围”。条件边则看当前状态做选择:资料齐全就去汇总,缺少时间范围就先向用户补问。边负责去哪里,节点负责在当前位置做什么。
如果销售和退款查询互不依赖,可以让它们并行执行,再汇总。此时图里有两个并行节点,但它们并不是两个“Agent”就天然更智能;只是两个可以同时完成的工作步骤。
并行写同一字段,先决定合并语义
假设两个节点都返回 results。销售节点写入“销售 80 万”,退款节点写入“退款 20 万”。如果 results 是一个默认覆盖字段,系统没有理由知道你想保留两个、保留最后一个,还是按来源去重。LangGraph 对同一执行步里无法合并的并行写入会报冲突;不要把“最后写的赢”当成可靠设计。
有两个更清楚的办法。其一,让它们写 sales_data 和 refund_data 两个字段,汇总节点再组合;其二,确实需要一份结果列表时,为该字段声明合并 Reducer,并考虑重复执行会不会重复追加。前一种往往更适合这道报表题,因为来源和职责天然不同。
测试也应覆盖两条分支同时返回、某条查询失败、重试后再次更新。否则图画得漂亮,最终 State 里却可能少一份数据或重复一份数据。
面试官继续追问
Reducer 就是把两个数组直接相加吗?
不一定。它是字段的合并规则。简单列表可以追加,但消息记录可能还需要按 ID 更新;金额数据可能应该按来源覆盖,不能重复累加。Reducer 要与业务语义相符。
Edge 是不是只能写死下一步?
不是。固定边适合确定顺序,条件边可以根据当前状态决定下一站。只是路由规则仍要清楚:哪些条件进入哪个分支、哪些情况结束或补问。
并行节点各写一个字段,就完全没有风险了吗?
写入冲突少了,但仍要检查汇总节点是否在两份结果都准备好后执行、单个查询失败时如何处理,以及重试是否会对外部系统造成重复副作用。
面试速记卡
- State:任务当前的共享数据,以及各字段如何更新。
- Node:读取状态,完成一步工作,返回部分更新。
- Edge:规定或判断下一个节点,负责流程走向。
- 并行写入:同字段必须明确合并语义;不同来源可拆字段再汇总。
- 设计顺序:先定字段和写入者,再画节点与边,最后测冲突和失败。
