
🧑💻 面试官:知识库已经有向量检索了,为什么还要加关键词检索?
🙋♂️ 我:向量检索擅长找换了说法但意思相近的内容。不过用户问的是错误码、合同编号或产品型号时,字面上的精确命中也很重要。
🧑💻 面试官:那只用关键词不就好了?
🙋♂️ 我:也会漏。文档写“连接被重置”,用户问“接口突然断开”,如果没有共同关键词,纯字面检索可能找不到;向量检索有机会补上。
🧑💻 面试官:两路都返回了结果,你直接把分数相加排序?
🙋♂️ 我:不能默认相加。BM25 和向量相似度的分数尺度不同。先统一文档 ID、去重,再采用经过验证的融合方法,例如按名次的 RRF,最后检查权限、版本和真正的答案质量。
混合检索不是“两个搜索框叠加”,而是让精确字面信号和语义信号各自补漏,再把候选变成一份可比较的结果。
面试速答(60 秒版)
RAG 用混合检索,主要是因为关键词和向量检索擅长的题不一样。像 E_CONN_RESET 这样的错误码、订单号或条款编号,关键词匹配通常更直接;用户把原文换一种说法来问时,向量检索又更容易找到语义相近的片段。
实现时,我会让两路检索在同一份可授权的文档范围内分别找候选,用稳定的文档或片段 ID 去重,然后融合排序。不能直接把 BM25 分数和向量分数当同一种量相加;可以先试 RRF 这类按名次融合的方法,再根据任务集调整。
是否值得上线,要按问题类型验证。准备编号精确题、同义改写题和普通问答题,比较目标证据的召回、最终回答质量、延迟和成本。如果只是把噪声候选变多,没有改善答案,就不能因为“混合”听起来完整而保留它。
知识点详解:两路召回为什么互相补位
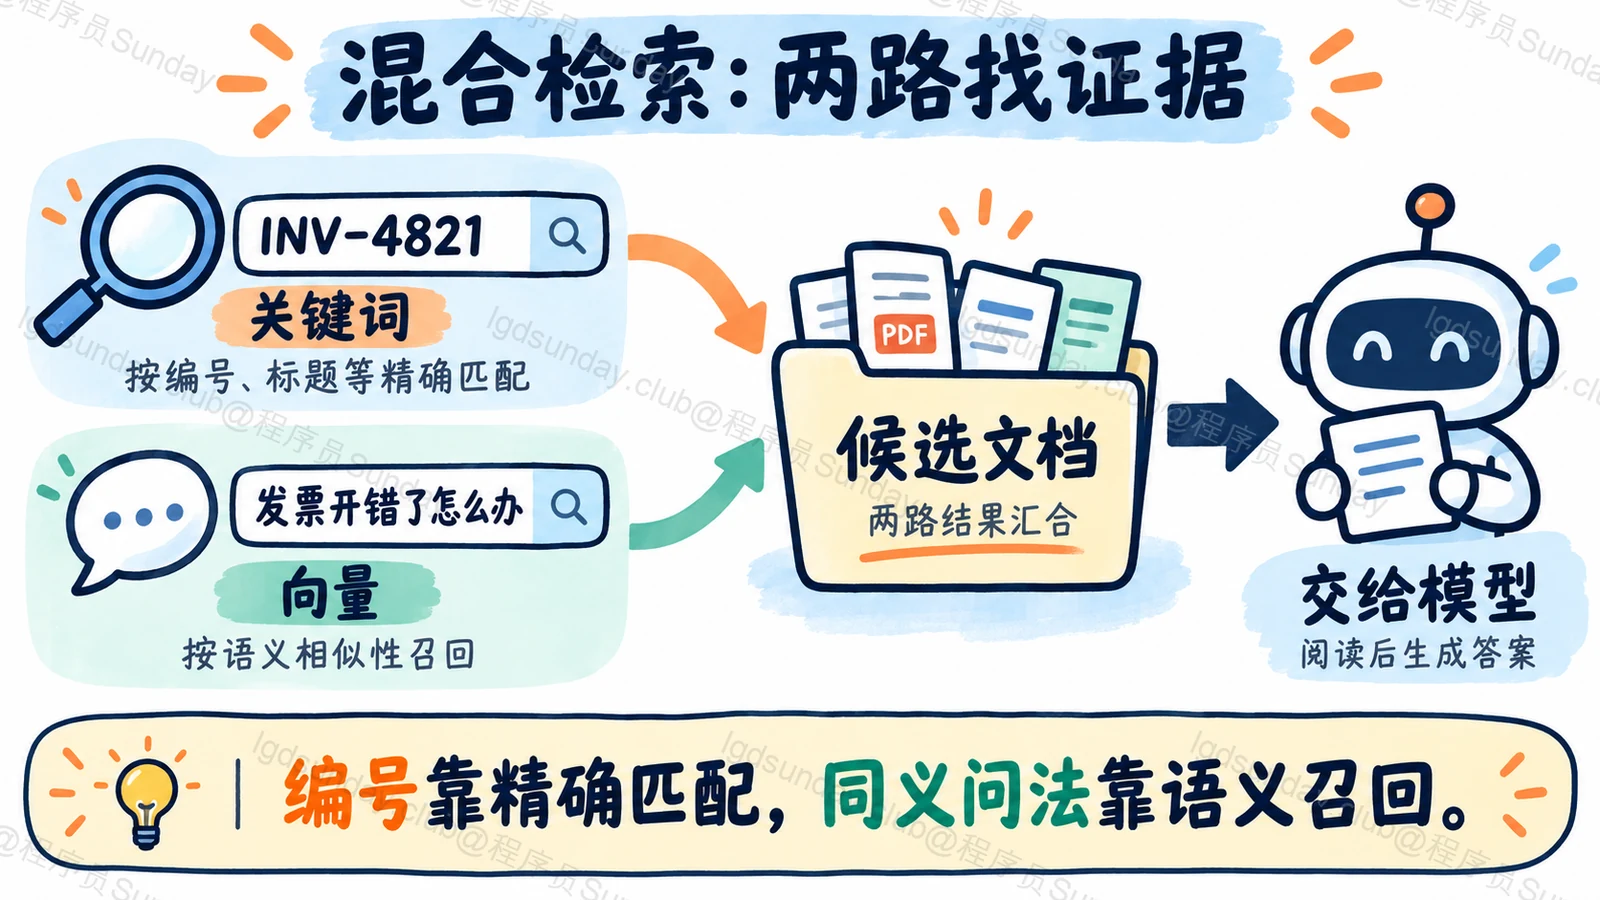
编号和错误码,语义相近反而不够
假设用户拿着日志问:“E_CONN_RESET 怎么处理?”文档里有这个错误码的专门条目。此时精确的字面匹配非常有价值,因为另一个名字类似的错误码可能对应完全不同的处理办法。向量模型会考虑整体语义,却未必把每个字符差异都当成业务关键。
反过来,用户说“接口一会儿就断开”,文档标题写“服务端主动重置连接”。如果分词、同义词和查询改写没有覆盖,关键词检索可能很吃力。向量检索给系统增加了语义改写后的召回机会。
融合的是候选,不是两种分数的简单加法
两路检索各自返回片段 ID、原始分数、来源、版本等信息。先按同一个片段 ID 去重,避免同一条材料重复占据上下文。再决定融合算法:可以按名次合并,也可以在校准分数后加权;不同引擎还有自己的融合实现。
一个实用起点是 RRF:不直接比较两种分数大小,而看每个片段在各路结果中的名次。这样避开“BM25 得 12 分、向量得 0.82,谁更大”这类无意义比较。它也不是万能公式:候选深度、权重和最终保留数量,仍要用数据验证。
权限和版本不能被“融合”冲掉
假设关键词通路找到了旧版内部文档,向量通路找到新版公开文档。融合排序可能把旧文档放在前面,却不能让它因此变成可用证据。检索范围和返回前的权限校验、版本约束必须保留;对敏感内容,最终进入模型上下文前还应按当前授权再核对。
验证时把问题分组,分别看目标片段的召回率、误召回旧版或越权片段的情况、生成答案是否正确,以及多一路检索带来的延迟。只有这些指标一起成立,混合检索才算解决了问题。
面试官继续追问
关键词和向量都没找到,Rerank 能补回来吗?
不能。重排只能在已有候选里调整顺序。目标片段没进入候选池,要回到解析、索引或召回策略排查。
两路结果都包含同一片段,为什么还要去重?
否则它可能重复挤占有限上下文,让其他必要证据进不来。保留其两路命中信息即可,不必把正文重复放两遍。
混合检索上线后延迟上升,你先优化什么?
看两路耗时、候选深度和融合位置,确认收益是否主要来自某一类问题。能按查询类型选择通路时,不必每个请求都走完整双路。
面试速记卡
- 关键词:抓错误码、编号和必须精确命中的词。
- 向量:补同义改写和语义相近的表达。
- 融合:统一 ID 去重,分数不宜直接相加。
- 门禁:权限与版本不能被高相似度覆盖。
- 证据:按题型比较召回、答案、延迟和成本。
