
🧑💻 面试官:知识库为什么要把文档转成 Embedding?
🙋♂️ 我:因为 Embedding 会把文本表示成向量。我们可以把用户问题也变成向量,通过距离找语义上比较接近的文档,不必只依赖关键词完全一致。
🧑💻 面试官:系统找到一条相似度最高的退款政策,是不是就可以直接回答?
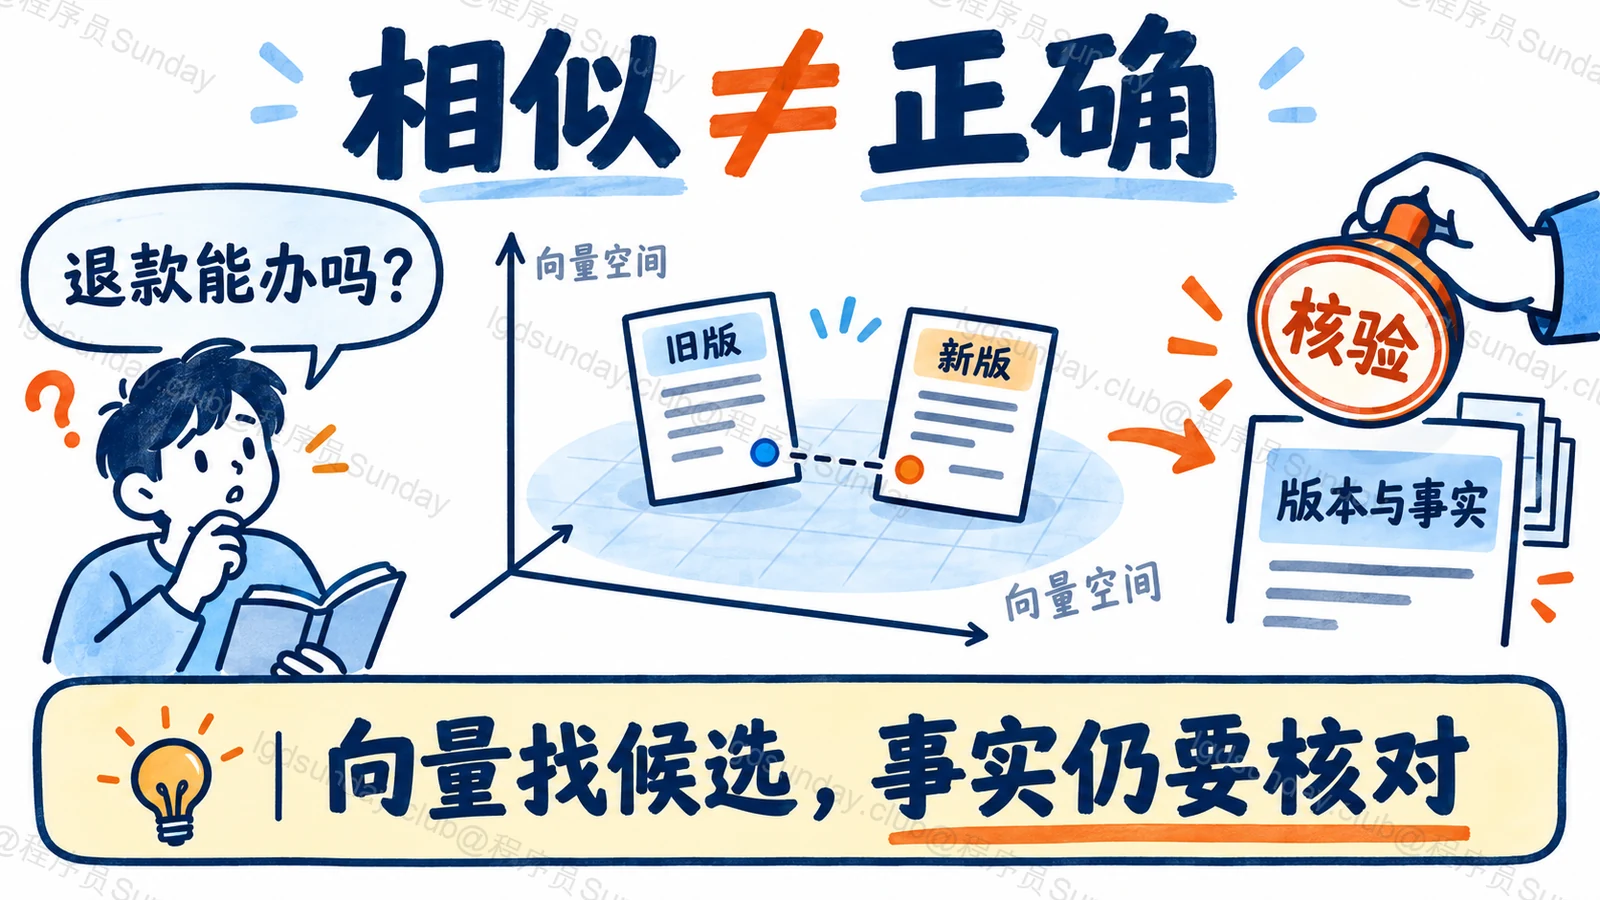
🙋♂️ 我:还不行。它可能是去年的版本,也可能属于另一个产品线。向量距离说明“值得看”,不说明“当前有效”。
🧑💻 面试官:那相似度分数 0.9,是不是能理解为有 90% 的概率正确?
🙋♂️ 我:不能。分数取决于模型和距离计算方式,它不是校准过的事实概率。要不要使用这条资料,还要看来源、版本、权限和问题里的关键条件。
Embedding 解决的是把相关候选找出来,不是替业务系统判断这条候选是否真实、最新、可见、足以支持答案。
面试速答(60 秒版)
Embedding 是把文本等内容表示成一组数字,也就是向量。两段内容在某个向量空间里距离近,通常表示它们在这个模型看来有一定相关性,因此适合拿来做语义检索。
但我不会把相似度分数直接当成“答案正确率”。假设新旧两版退款政策都在讲同一件事,它们可能非常相似,真正该用哪一版却取决于生效时间和业务规则。再比如一个片段语义相关,却属于别的租户,系统也不能把它交给模型。
所以向量检索只负责提供候选。应用还要核对文档版本、来源和权限;最后用有标注的问题集,看目标证据有没有被找出来,以及错误版本是否被挡住。换 Embedding 模型时,也要重新验证索引,不能认为旧分数阈值天然适用。
知识点详解:相似度到底回答了什么
向量让“换一种问法”也有机会命中
关键词检索很擅长匹配明确的术语或编号,但用户未必会照着文档原话提问。假设文档写“续费前七天可以取消自动扣款”,用户问“我不想下个月继续被扣费怎么办”,语义检索有机会把它们拉近。
这就是 Embedding 的价值:用同一套表示方式把查询和文档放入可比较的向量空间,再按距离找候选。距离近并不保证两个句子同义,更不保证文档可以回答用户的全部条件。它只给了系统一个排序信号。
为什么旧政策可能排在最前面
假设知识库里有两份“退款政策”,一份去年生效,一份今年生效,正文只有少量数字变化。两份在语义上都贴近用户问题。若索引没有版本元数据,或者检索后没有做有效期过滤,旧版排在前面并不奇怪。
因此,索引里的每个片段至少要能追溯原文、文档 ID、版本和适用范围。像订单号、法规条款号这样的精确条件,还可能需要关键词检索或结构化过滤配合。向量召回和这些约束并不冲突,它们在解决不同问题。
分数不是可跨系统使用的百分比
相似度分数受 Embedding 模型、向量归一化、距离函数、语料分布和问题类型影响。某个数据集上“高于某分数就可用”的经验,换模型、换语料后未必成立。尤其不能把 0.9 读成“有 90% 概率为真”。
更稳妥的做法是准备真实查询与人工标注的相关片段,分别检查召回、错误版本、误入其他租户等结果。如果更换 Embedding 模型,文档向量与查询向量应保持在匹配的表示体系里,重新建索引并对比评测结果,而不是混用新查询向量和旧文档向量。
面试官继续追问
Embedding 模型越大,RAG 一定越准吗?
不一定。模型能力只是一个环节;切片、元数据、权限、检索策略和最终生成都可能造成错误。要在同一批问题上比较召回质量与成本。
相似度很低时能直接回答“知识库没有”吗?
不能只靠一个通用阈值。先确认阈值在当前任务集上是否校准过,还要检查关键词检索和过滤条件是否漏掉了准确文档。
两条文档都相似,却互相矛盾怎么办?
先按版本、生效时间和权威来源处理冲突。无法确定时不要让模型凭相似分数投票,应该显式提示待核对。
面试速记卡
- Embedding:把内容表示为向量,用于寻找相关候选。
- 距离近:表示相关信号较强,不代表事实正确。
- 使用前:核对来源、版本、适用范围与权限。
- 分数:不是跨模型通用的正确率百分比。
- 换模型:重建或迁移向量索引,并用同一问题集重测。
