
🧑💻 面试官:公司要做一个内部知识助手,RAG 和微调,你会怎么选?
🙋♂️ 我:先考虑 RAG。员工提问以后,系统找到相关文档,再让大模型根据文档回答。
🧑💻 面试官:文档我们都有,为什么不直接拿去微调,让模型记住?以后提问就不用每次查了。
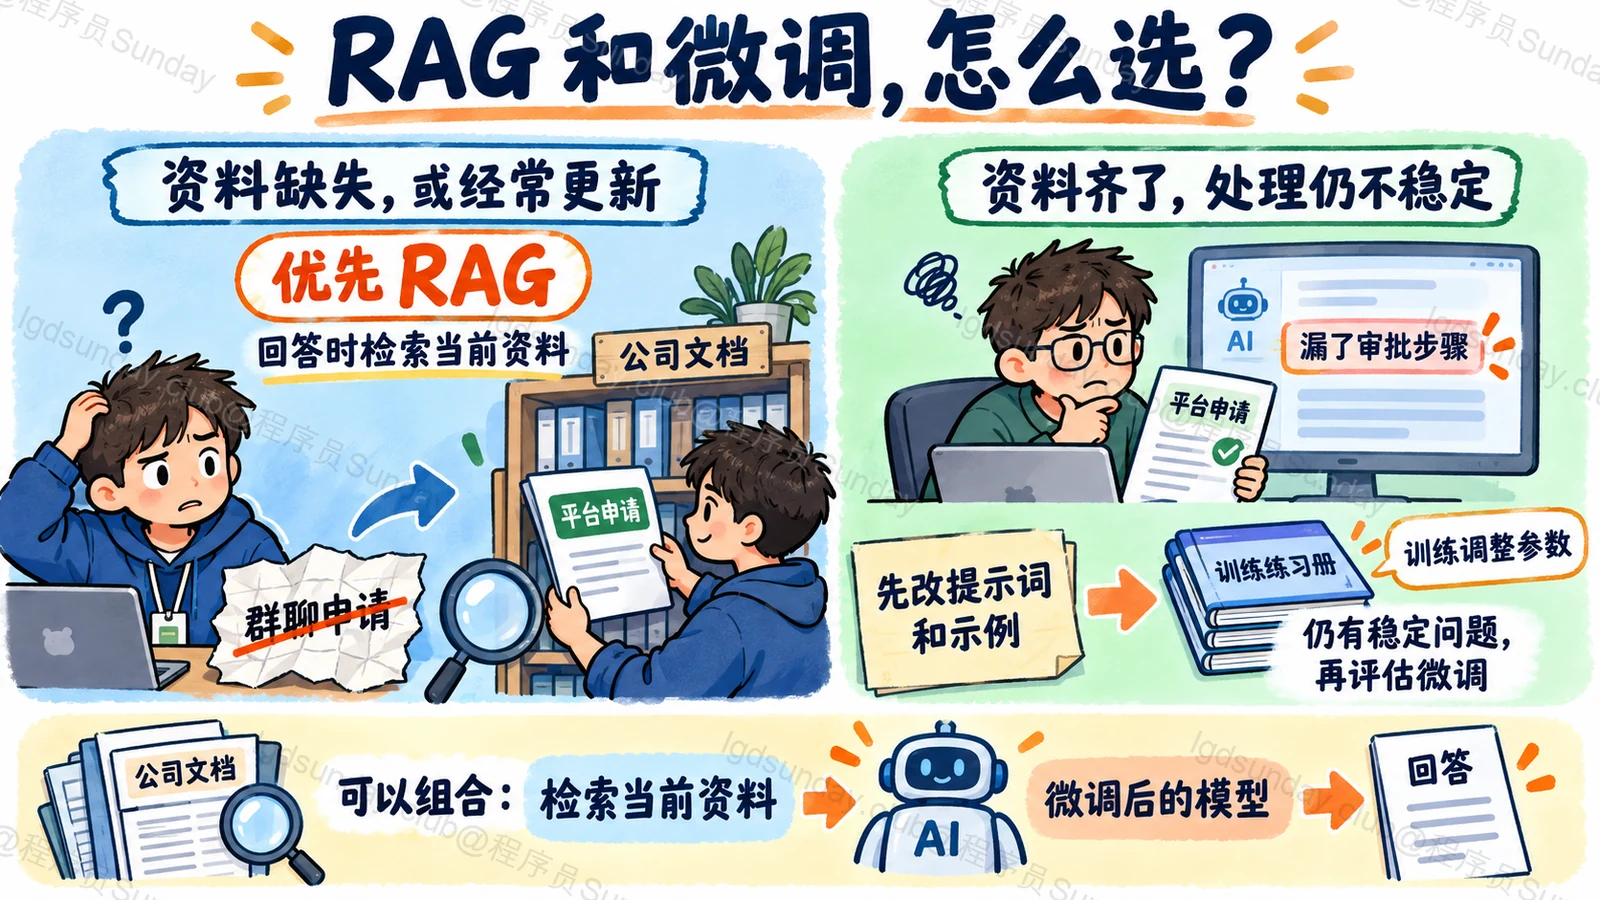
🙋♂️ 我:公司流程会变。比如以前申请测试环境要在群里找运维,现在改成平台申请了,模型可能还在回答旧办法。
🧑💻 面试官:那用了 RAG,找到的也是最新文档,可它还是漏掉办理步骤呢?
🙋♂️ 我:如果需要的内容已经给全,就得检查模型有没有理解和遵守回答要求。可以调整提示词、补示例,必要时再考虑微调。
🧑💻 面试官:所以 RAG 负责知识,微调只负责语气和格式?微调之后,还要不要保留 RAG?
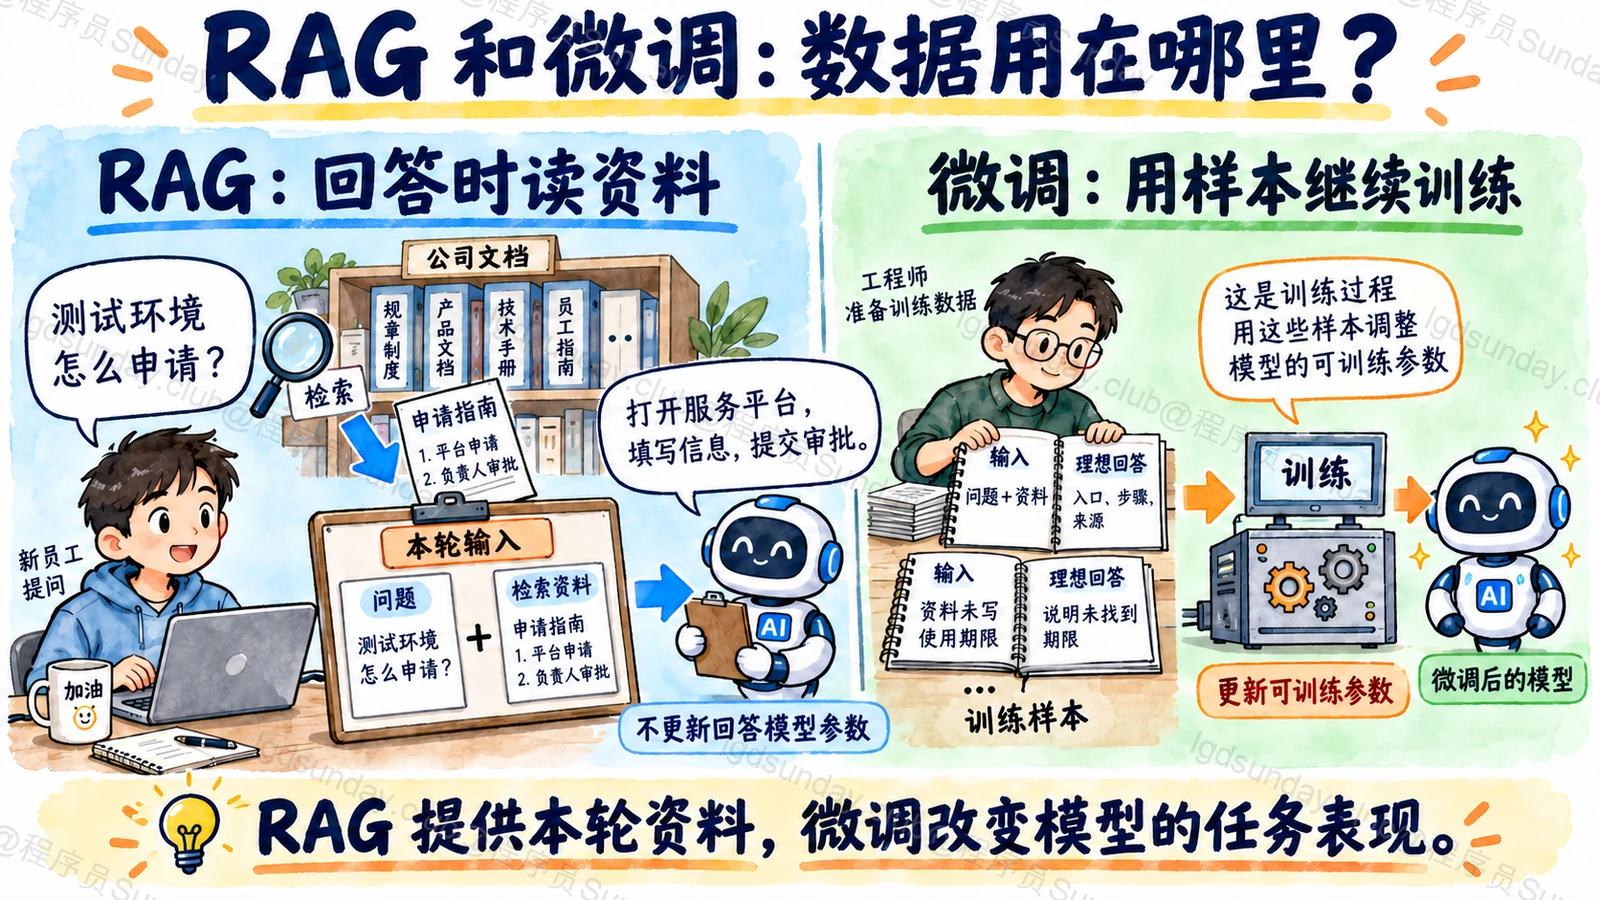
答好这道题,先看数据用在了哪里:RAG 把资料交给模型当场阅读,微调让模型通过训练学会怎样处理任务。
面试速答(60 秒版)
RAG 会在用户提问以后,先检索相关资料,再把资料和问题一起交给大模型。这种做法适合公司制度、产品文档这些需要经常更新、回答时还要说明出处的内容。
微调 则是在已有模型上继续训练,调整可训练的参数,改善特定任务上的表现。例如,按照公司的标准给工单分类,或者根据材料整理出完整的办理步骤。
因此,做企业知识库时,可以先用 RAG 把需要的资料提供给模型。如果资料已经找对,模型却总是不能按要求处理,那么先调整提示词和示例;仍然有反复出现的问题,再结合训练数据和评测结果考虑微调。
两者也可以一起用:RAG 负责查找当前有效的资料,微调后的模型继续读取这些资料并回答。微调可以学到知识,但不能把它当成一套随时能够更新、删除和查出处的文档库。
知识点详解:同样是给模型数据,给法不一样
RAG:这次回答之前,先把资料找出来
假设咱们正在做前面那个内部知识助手。一个新同事问:“测试环境怎么申请?”
模型可能知道一般公司的申请流程,但它不知道咱们公司究竟用哪个平台、需要谁审批。让它直接回答,很容易得到一段听着合理、实际办不成事的建议。
使用 RAG 时,后端会先在知识库里搜索,找到当前有效的《测试环境申请指南》,取出相关段落,然后和用户的问题一起发给模型。模型这次看到的内容,大概就是:
问题:测试环境怎么申请?
参考资料:打开内部服务平台,选择“测试环境”,填写项目和使用期限,提交负责人审批。
回答要求:根据资料说明办理步骤,并附上来源。
这就是 RAG,也就是“检索增强生成”的基本过程:先找到资料,再让模型带着资料回答。微软的 RAG 文档把它拆成检索、补充输入和生成三个环节。
这里容易误解的一点是:把文档存进知识库,并不等于回答模型已经学会了这份文档。
模型是在这次输入里读到它的。这次阅读不会因此更新模型参数;下次有人问,系统仍然要把需要的资料带进来。把文档转成向量、建立索引,是为了方便查找,也不能当成对回答模型做了微调。
微调:拿做对的例子,继续训练模型
微调会用数据继续训练已有模型,调整其中可训练的参数。这里先用常见的监督微调,也就是 SFT 来解释。
还是这个知识助手。咱们希望它回答办理类问题时,先告诉用户去哪里办,再列出具体步骤。如果资料里缺少某项条件,就明确说没找到,别自己补。
训练时,可以准备一批经过核对的例子。每个例子里有用户的问题、提供给模型的资料,以及我们希望它给出的回答。模型通过这些样本,学习这种任务应该怎样处理。这是监督微调使用输入与期望输出样本的方式。
因此,微调能改善的不只是说话语气。分类是否符合业务标准、能不能从材料里提取需要的内容、是否按要求完成任务,都可以成为训练目标。至于效果有没有变好,还得用没参与训练的问题来测。
为什么不把全部文档微调进去,以后省得查?
这个想法很自然。资料反正都有,模型学会以后直接答,看上去还能少一次检索。
麻烦出在“资料变了”这件事上。
假设旧流程是去群里找运维,新流程改成去平台申请。文档很好改,把旧入口撤掉,补上新的就行。可模型里没有一个叫“测试环境申请方式”的字段,让我们打开以后把旧值换成新值。
微调确实可能让模型学到旧流程,却不能保证只把某条旧知识干净地换掉,更不能因为删了训练文件,就当它已经忘记。重新准备数据、训练和验证,也都有维护成本。
RAG 在这类问题上更好维护:更新文档及对应索引,处理掉失效版本,下一次检索就可以使用新资料。模型本身不必因为申请入口换了而重新训练。这也是 AWS 建议自有文档问答优先从 RAG 开始的原因之一。
不过,RAG 也不会自动替我们维护文档。源文件改了,索引没同步,助手照样可能把新人送去那个已经不用的群。回答里有出处,也还要检查它引用的是不是当前版本。
资料找对了,回答还是不好,再看需不需要微调
先别因为模型漏了一次步骤,就开始准备训练。
把实际发给模型的内容拿出来看看:审批要求是不是在另一段里,根本没被检索到?提示词是不是只让它“简要回答”,却又希望它把每一步都讲全?这些问题,改检索和提示词通常更直接。
如果正确资料已经完整提供,要求也讲清了,换一批问题仍然反复出现同类错误,而且手里有足够好的训练样本,这时候再评估微调就更有依据。
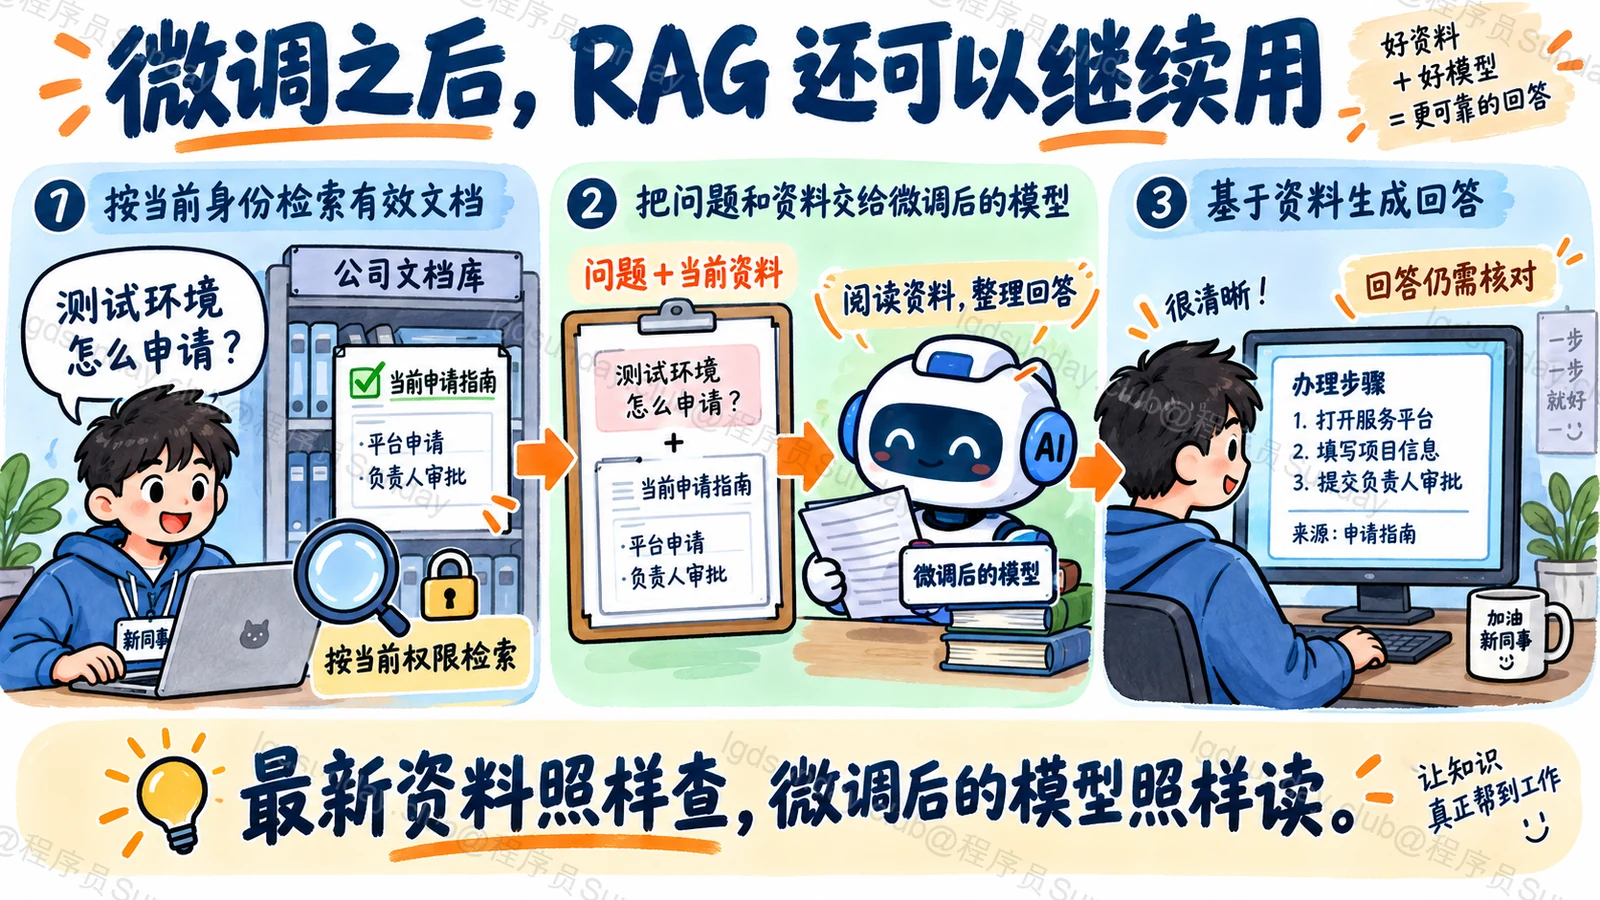
用了微调以后,检索流程完全可以保留。员工提问,后端找出他有权查看的最新指南,再交给微调后的模型整理回答。RAG 与微调可以这样组合:一边持续提供当前资料,一边改善模型处理这类资料的表现。
最后拿同一批新问题比较改动前后的结果。答案说得更顺了,却仍然把平台申请写成群聊申请,这次改动就没有解决知识库真正的问题。要一起看步骤有没有漏、内容是否符合当前文档、没写的地方有没有乱猜。
面试官继续追问
公司资料只有几页,也要搭向量数据库吗?
不一定。资料少、长度可控时,可以先把相关全文放进上下文。等文档多到不适合每次全部发送,再引入检索。即使用 RAG,也可以做关键词搜索,不必一开始就上向量库。
检索总是拿错文档,微调有帮助吗?
先排查检索。回答模型拿不到正确依据,靠微调让它猜中,问题仍然在那里。检索使用的 Embedding 模型也可以专门训练,但那是优化检索环节,需要另外的数据和评测,不能和微调回答模型混为一谈。
能不能让微调后的模型记住每个人能看哪些资料?
不适合。人员、部门和权限会变,而且权限需要每次请求都准确执行。应由服务端按当前身份筛选资料,再把允许查看的内容交给模型。不要先把无权查看的文档塞进去,再指望它记得不说。
面试速记卡
- RAG:回答时检索资料,把相关内容放进模型输入。
- 微调:用训练数据调整可训练参数,改善特定任务上的表现。
- 企业知识库:经常更新、需要来源的内容,通常先考虑 RAG。
- 微调时机:正确资料和清晰要求已经给出,模型仍有稳定的任务问题。
- 组合方式:检索最新资料,再由微调后的模型阅读并回答。
