
🧑💻 面试官:做 RAG,你会选哪一个向量数据库?
🙋♂️ 我:Milvus 比较适合向量检索,数据少的时候也可以用 FAISS 或 pgvector。
🧑💻 面试官:FAISS 是数据库吗?谁负责保存文档、处理用户权限?
🙋♂️ 我:FAISS 主要是检索库,这些能力还需要应用自己处理。
🧑💻 面试官:数据不多,但每天都要修改,还要按部门权限过滤。你仍然只按条数来选吗?
选型先看「检索之外还要管什么」:搜索速度很重要,但数据更新、过滤、备份和运维同样决定系统能不能用。
面试速答(60 秒版)
Milvus、FAISS 和 pgvector 都可以用于向量检索,但它们不是同一种产品形态。
FAISS 是相似度搜索库,适合嵌入程序做实验或构建检索能力。文档存储、并发服务、权限和更新管理,通常需要开发者另外安排。
pgvector 是 PostgreSQL 的扩展,向量可以和业务字段放在同一个数据库里。项目本来就在用 PostgreSQL,又需要过滤、关联查询和事务时,它值得优先验证。
Milvus 是面向向量数据的数据库系统,提供集合、检索、过滤和相应的数据管理能力;是否采用它,要考虑检索规模、吞吐需求和团队的运维能力。
因此,不能只按“多少万条”作选择。更合适的做法是用自己的数据、权限条件和更新负载,比较召回、延迟与维护成本。
知识点详解:选的是搜索算法,还是完整的数据服务?
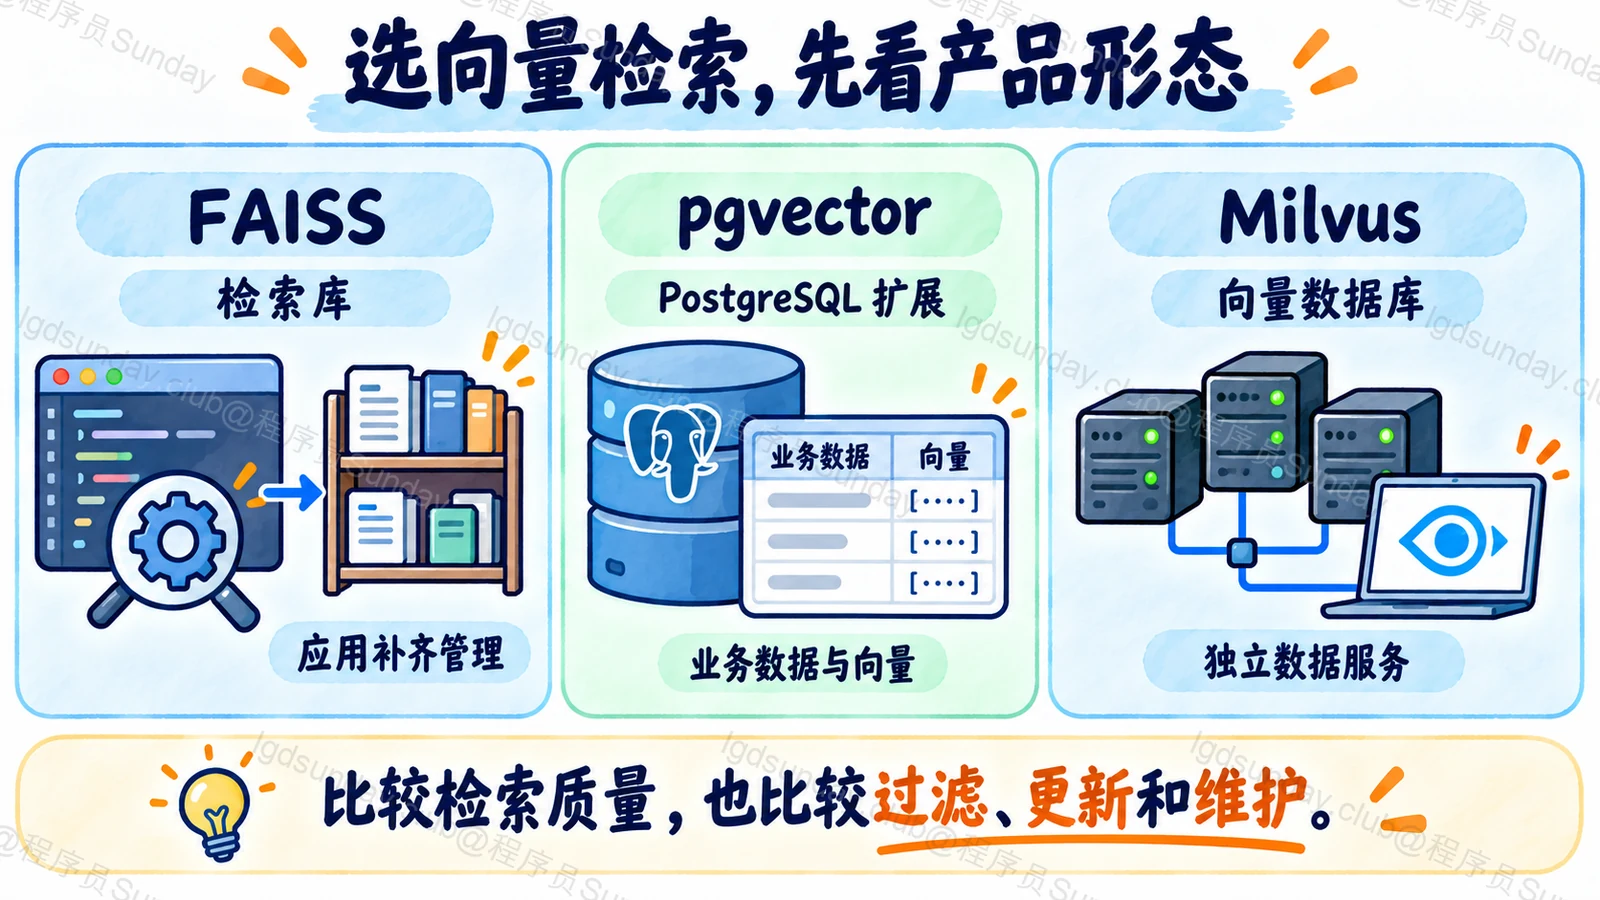
先把这三种形态分清楚
假设咱们要给公司内部文档做检索。除了向量,系统还要保存文档 ID、部门、版本和是否删除。
如果使用 FAISS,它主要负责把向量组织成索引,并返回相近向量的标识。原文在哪里,谁能访问,哪个版本有效,都需要其他代码和存储来配合。FAISS 官方项目把自己定义为相似度搜索与聚类库,而不是完整数据库。
这不是缺点,而是分工不同。离线实验、只读索引或自建检索服务,可以从库开始;但不能把“调用搜索函数成功”当成数据服务已经具备生产能力。
pgvector 则在 PostgreSQL 里增加向量类型与搜索能力。向量和业务元数据可以一起查询,备份、事务等工作也沿用 PostgreSQL 的体系。官方项目同时支持精确搜索和近似索引,不是只能在小数据里线性扫描。
Milvus 提供的是专门的向量数据服务。应用通过客户端连接它,管理集合与数据,再发起搜索。它减少了自建部分能力的工作,但也增加了一个需要维护的系统。
过滤条件会改变你看到的性能
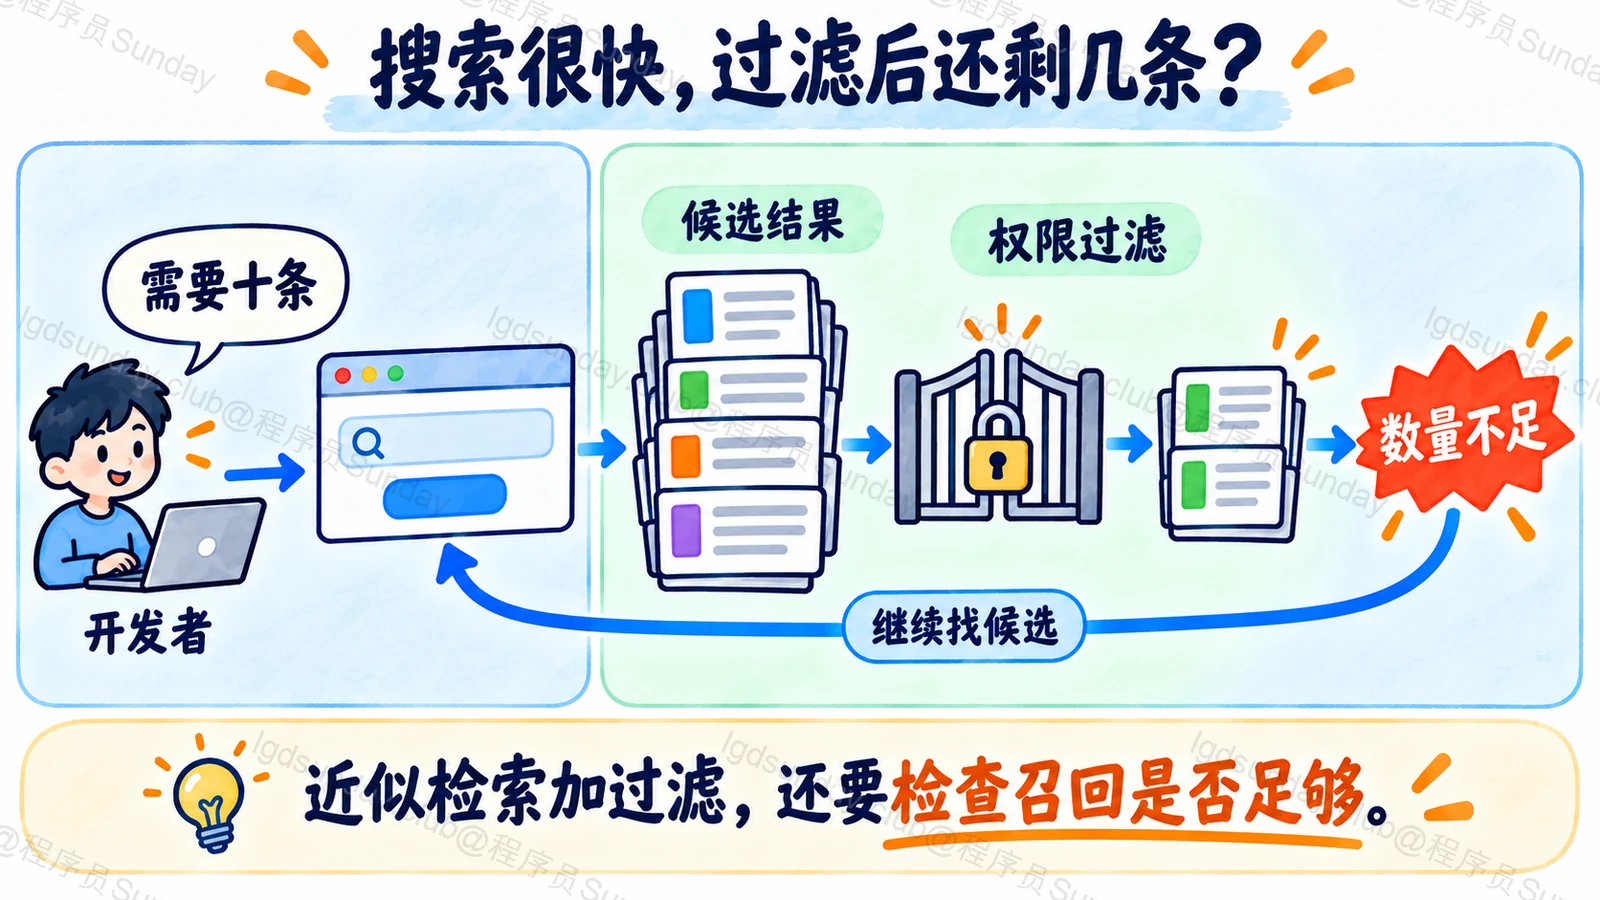
现在增加一个条件:财务部门只能检索自己有权访问的文档。
不带过滤的 Top 10 搜索很快,并不能说明带权限条件的请求也一样快、一样完整。特别是近似检索,候选经过过滤之后,可能只剩两条,甚至一条都没有。
pgvector 文档明确说明了近似索引与过滤组合时的情况,并提供迭代扫描等做法;Milvus 的过滤说明也区分了不同过滤路径。
因此,压测不能只用“全部文档里找十条”。还要加入真实部门分布、有效版本条件,以及只匹配少量记录的情况。检索结果最终展示之前,应用仍然要校验当前访问权限。
数据更新和删除,比静态 Demo 更能区分方案
假设一份报销规定今天改了。系统不能只把新向量插进去,却继续把旧片段当作当前规定。
这时需要维护文档版本、片段标识和有效状态,并确认索引更新之后何时对查询可见。删除也要覆盖原文、索引、元数据和可能存在的缓存。
FAISS 的不同索引类型,在更新、删除和持久化上的能力不一样,需要具体检查。数据库产品也有自己的读写和一致性选项,不能把“是数据库”理解成所有操作都自动同步完成。
选型时,可以安排一组持续更新任务:一边查询,一边发布新版本、删除旧片段,再检查旧内容多久不再出现。这比只导入一次数据更接近实际使用。
怎样做一次不容易误导自己的对照?
使用相同的向量模型、维度、距离定义和查询集。先用精确搜索建立参考结果,再比较各方案在相同召回要求下的延迟和资源消耗。
| 要检查的内容 | 不能只看什么 |
|---|---|
| 搜索质量 | 不能只看一次返回了几个结果 |
| 过滤后的延迟与召回 | 不能只用没有权限条件的请求 |
| 更新与删除的可见性 | 不能只测静态数据 |
| 并发和故障恢复 | 不能只测本机单请求 |
| 维护成本 | 不能只比较软件是否免费 |
已有 PostgreSQL、业务数据与向量关联紧密时,可以先试 pgvector;需要独立、较大规模的向量服务时,再验证 Milvus;只是建立只读实验或愿意自建服务层时,FAISS 也很合适。
这些是起点,不是“超过某个条数必须迁移”的硬规则。
面试官继续追问
用了相同的 HNSW,性能是不是就一样?
不是。参数、过滤方式、存储结构、并发调度和硬件都会影响结果。相同算法名称,只说明采用了类似思路,不能代替真实负载下的比较。
所有数据都放一个向量库,会不会更简单?
表面上简单,但权限、版本和事务更新可能需要跨系统协调。项目已经有可靠业务数据库时,要先考虑哪些字段应该留在权威存储里,不能因为支持元数据就把所有业务都迁过去。
什么时候值得更换方案?
当现有方案在目标召回、并发、更新或故障恢复要求下已经遇到明确瓶颈,而新方案能解决它时。迁移要核对向量模型、距离方式和数据版本,再用双路查询验证,不能只重新导入后就切流量。
面试速记卡
- FAISS:检索库,应用需要补齐数据服务能力。
- pgvector:PostgreSQL 扩展,适合结合业务字段与数据库能力。
- Milvus:专门的向量数据服务,需要考虑部署与维护。
- 选型变量:召回、过滤、更新、并发、恢复和运维成本。
- 验证方式:相同数据与质量要求,比较真实负载,不按条数拍板。
