
🧑💻 面试官:你让 AI 增加一个导出功能,页面能打开,文件也能下载,可以交付了吗?
🙋♂️ 我:还需要跑测试,确认导出的内容符合要求。
🧑💻 面试官:AI 顺手写了测试,全部通过。但需求要导出所有筛选结果,它只导出了当前页,怎么办?
🙋♂️ 我:说明测试和实现可能用了同一个错误理解,需要回到需求重新检查。
🧑💻 面试官:那你怎么证明它没漏数据、没导出别人的数据,也没为了通过测试删掉原来的检查?
AI 写代码之后,真正要验收的是“这次改动有没有满足需求”,而不是“AI 能不能为自己的代码写出一组绿灯”。
面试速答(60 秒版)
代码能运行,只能说明它通过了部分检查,不能说明需求已经完成。
我会先把需求转成能观察的验收条件。例如导出全部筛选结果,就需要验证跨页数据、筛选条件、字段内容和用户权限,而不只是检查下载按钮能不能点击。
然后审查实际代码差异,运行测试、静态检查和必要的端到端验证。AI 可以协助补测试,但测试的预期结果要来自需求和独立准备的数据,不能只根据当前实现反推。
同时还要检查它有没有修改无关文件、降低原有测试要求,或者引入不必要的依赖。
交付时,我需要说清楚改了什么、验证了什么,以及还有哪些情况没测到。如果关键场景没有验证,就不能把“本地能跑”写成“已经可以上线”。
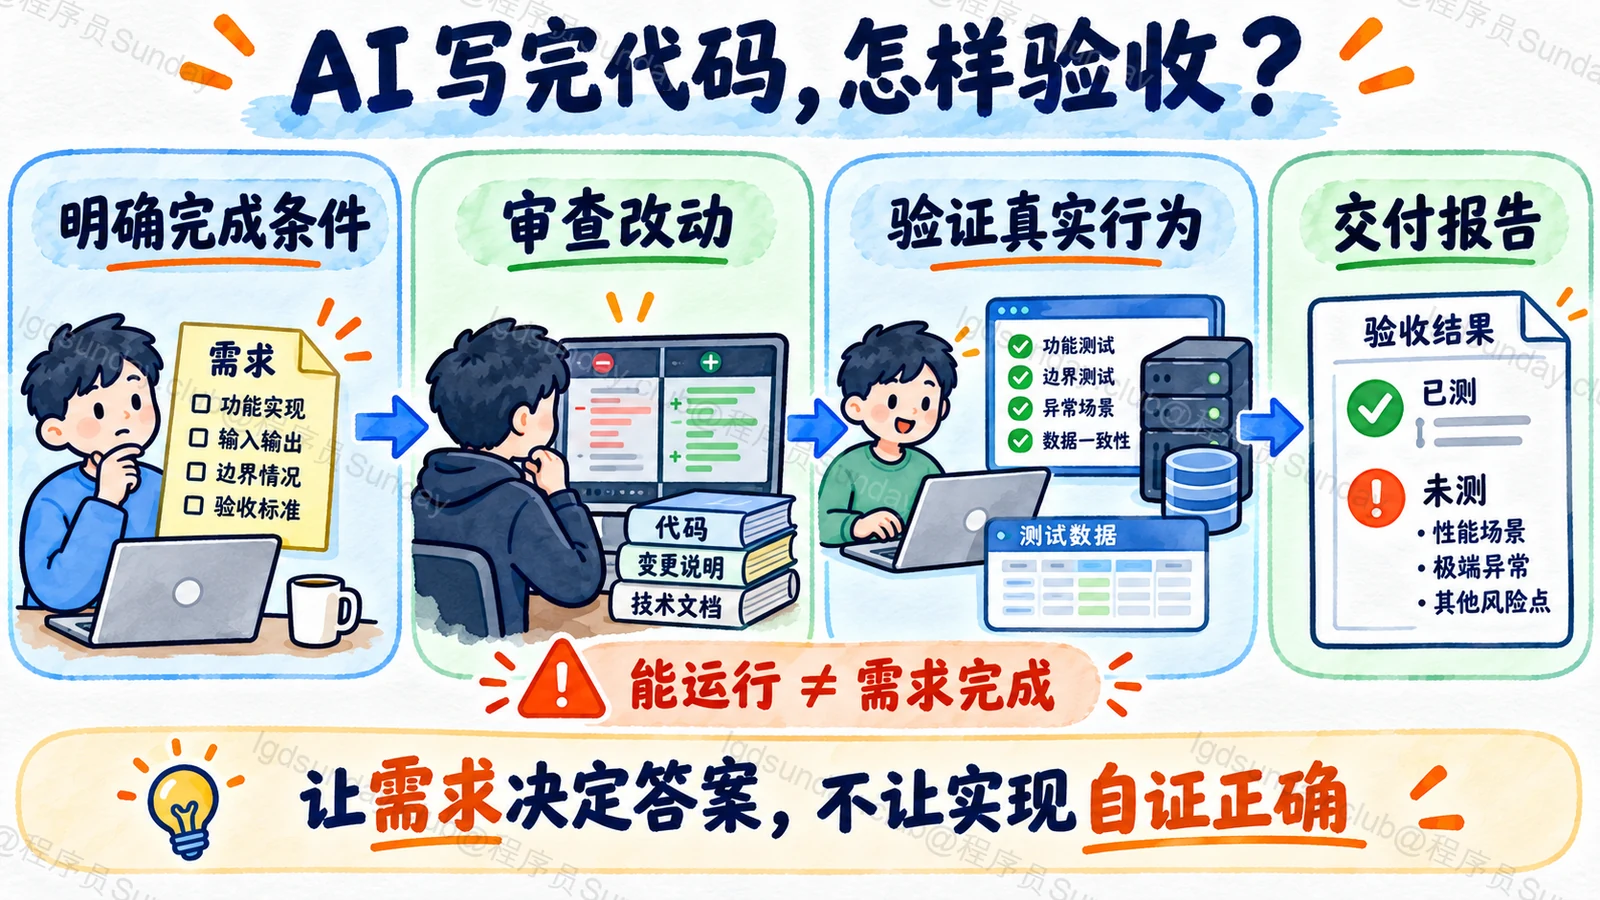
知识点详解:怎样验收一次 AI 代码改动?
第一步不是多跑几次,而是把“完成”说清楚
假设一个后台系统有客户列表,每页显示 20 条数据。现在的需求是:按当前筛选条件,把当前用户有权访问的全部客户导出为 CSV。
如果只告诉 AI“加一个导出按钮”,它可能直接拿页面已经加载的 20 条数据生成文件。这个实现可以运行,下载过程也没有报错,但它没有完成真正的需求。
因此,写代码之前或者验收开始时,就应该把几个容易产生歧义的地方确认下来:导出当前页还是全部结果?导出哪些字段?没有结果时怎么办?筛选条件变化以后,以点击导出时的条件为准,还是以最初进入页面时的条件为准?
这些决定构成验收依据。如果需求本身不明确,不能靠 AI 多生成几个测试来弥补。
用一组能暴露错误的数据来验收
咱们可以为这个假设案例准备 47 条符合筛选条件的数据,让它必然跨过分页边界。同时,再放入几条不符合筛选条件的数据,以及另一位用户才有权访问的数据。
这里的 47 是人为构造的测试数量,不是线上统计。它的作用是让“只导出了第一页”这类错误容易被发现。
| 验收场景 | 应该检查什么 |
|---|---|
| 结果超过一页 | 导出应包含全部 47 条符合条件的数据 |
| 混入不符合筛选的数据 | 导出结果中不应出现这些记录 |
| 存在其他用户的数据 | 当前用户不能导出无权查看的记录 |
| 字段含中文、逗号或换行 | 用目标 CSV 读取方式验证内容没有错位 |
| 原有列表继续使用 | 筛选、分页和其他按钮没有被改坏 |
检查时不只数行数,还要比较记录标识和字段值。因为“47 行”也可能是重复导出了某些记录,同时漏掉另一些。
如果业务允许用户把文件直接交给电子表格软件打开,还需要单独考虑公式注入等安全问题,按产品约定处理危险单元格内容,不能把字符串原样拼接当成完整 CSV 实现。OWASP 对 CSV 注入的说明可以作为这项安全检查的依据。
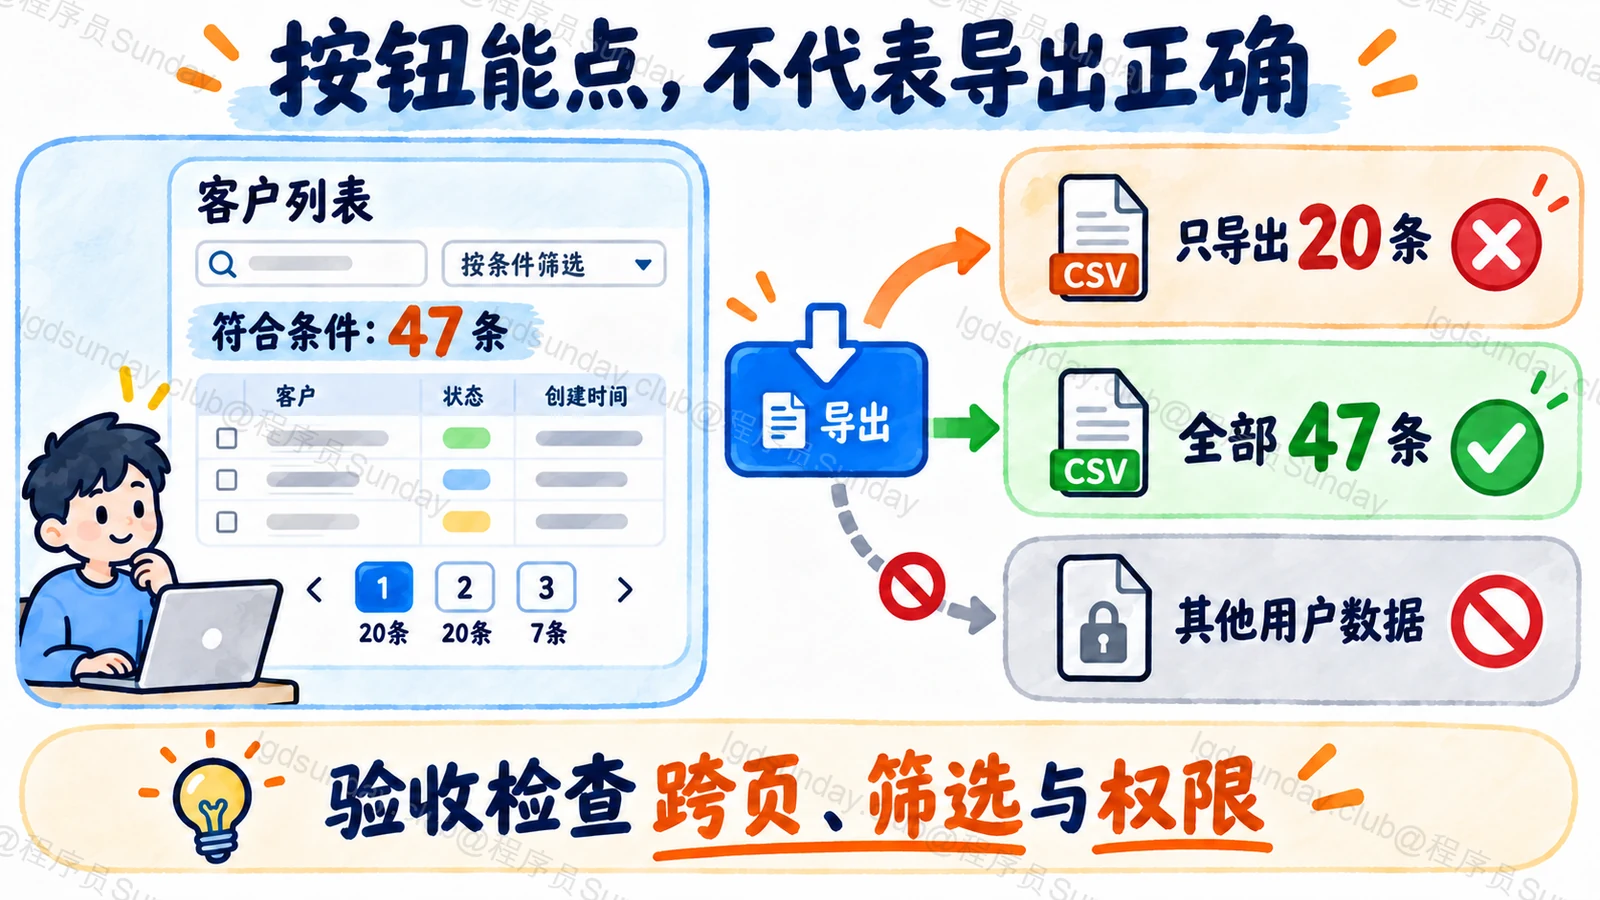
AI 自己写测试,问题在哪里?
问题不在于测试一定不能让 AI 写,而在于实现和测试可能一起误解了需求。
例如 AI 认为“导出”就是导出当前页,于是测试也只构造 20 条数据,再断言文件里有 20 条。测试会通过,但完全没有检查跨页要求。
更合适的做法是先保留独立的验收条件和测试数据,再让 AI 补充测试实现。评审时重点检查断言:它到底在证明什么?有没有把原本严格的断言改成“结果非空”?有没有把失败用例跳过?
也可以让另一次独立审查寻找遗漏,但换一个模型并不自动获得正确答案。最终还是要对照需求、真实执行结果和代码差异。GitHub 的 AI 代码审查指南也强调功能检查、需求对齐以及对实际改动的审查。
测试以外,为什么还要看 Diff?
因为测试只能覆盖被检查的行为,Diff 能告诉你这次到底改动了什么。
比如增加导出功能,本来只需要调整接口和页面,却顺便关闭了权限中间件、改了全局编码设置,或者升级了一大批依赖。即使当前用例能过,也值得追问:这些变化是需求必需的吗?有没有更小的改法?
审查依赖时,还应核对包是否真实存在、来源是否可信、项目是否确实需要它。不能因为 AI 写出一个安装命令,就默认这个包适合引入。
最后,从实际入口执行一次导出流程,验证浏览器发出的参数、服务端返回的内容和最终文件。单元测试适合检查局部规则,但页面和接口之间传错筛选字段,往往要在联调时才能发现。
验收记录也不用写成大报告。把代码版本、执行过的检查、关键结果和未覆盖情况记下来,就能让接手的人知道哪些结论有依据。没有测试环境的场景,明确写“未验证”,比一句含糊的“应该没问题”更有用。
面试官继续追问
老项目没有测试,怎么验收?
先围绕本次改动建立最小的一组检查,不必等整个项目补齐测试。记录旧行为,为导出准备可重复使用的数据和操作步骤,再逐步把关键规则自动化。人工验证也可以作为证据,但要说清楚范围,不能假装已有完整回归覆盖。
AI 为了修复失败测试,修改了测试文件,能接受吗?
要看需求是否真的改变了原来的行为。如果行为没有变,只是为了让绿灯出现而放宽断言,就不应该接受。若需求确实变化,需要说明旧断言为什么不再成立,同时补上新规则的验证,不能只把旧用例删除。
所有测试通过,就可以自动发布吗?
不一定。还要看变更风险和团队发布规则。普通样式调整与权限、账务、数据迁移的验证强度不同。涉及高风险操作时,还可能需要人工审查、灰度和回滚准备;测试通过是必要证据,不是对所有运行环境的保证。
面试速记卡
- 验收对象:需求和可观察结果,不是模型的完成声明。
- 测试依据:预期结果来自独立需求,不能由实现自行定义。
- 数据设计:覆盖边界、异常和权限,而不只验证正常路径。
- 改动审查:看清 Diff、测试断言和新增依赖。
- 交付说明:已验证与未验证分开写,不扩大结论。
