
🧑💻 面试官:让大模型给客服工单分类,只写分类规则,效果不太稳定,你会怎么改?
🙋♂️ 我:可以补几个分类正确的例子,也就是 Few-shot Prompting,让模型知道我们希望它怎么分。
🧑💻 面试官:我给了十条“导出失败,归为故障”的例子。用户问“导出按钮在哪里”,它也分成故障了,怎么办?
🙋♂️ 我:这些例子太像了。还需要告诉它,同样提到导出,也可能是在咨询操作方法。
🧑💻 面试官:那我把历史工单都塞进去,是不是就不用微调了?给它看过一次,下次还要再给吗?
这道题要讲清楚的是:例子在帮模型理解这次任务的判断标准,但看过例子,不等于模型参数已经更新。
面试速答(60 秒版)
Few-shot Prompting 就是在提示词里放入少量“输入和正确输出”的例子,再让大模型处理新的输入。
例如,给客服工单分类时,光说“分成故障、使用咨询和功能建议”,模型未必清楚我们的具体标准。补上几个容易混淆的例子,它就更容易理解,同样提到“导出”,报错和询问按钮位置应该分到不同类别。
这些例子是在本次输入中起作用,不会因为看了一遍就更新模型参数,所以它和微调不一样。下一次独立请求如果还要参考这些例子,应用仍然需要把它们放进输入。
选例子时,我会优先覆盖真实任务和容易分错的边界,而不是反复堆相似样本。最后用没放进提示词的新工单比较效果,看看错误是否真的减少,也看看增加的 Token 和等待时间是否值得。
知识点详解:例子到底帮模型补上了什么?
规则写了,模型为什么还是会理解错?
假设咱们要给一款协作软件做工单分类,只有三个类别:故障、使用咨询、功能建议。
看上去很简单。可收到这样一条消息时,问题就来了:“我找不到导出按钮。”
它是在问按钮在哪里,还是按钮本来有、现在突然消失了?如果业务规则也没说清楚,换个人来分,同样可能犹豫。
所以,先把规则补完整。例如,用户明确描述报错或原有功能异常,才归为故障;询问怎样操作,归为使用咨询;希望增加尚未提供的能力,归为功能建议。信息不足的工单,先进入待确认流程。
规则决定了我们想怎么分。例子的作用,是把这些规则在具体句子里的用法演示出来。 不能规则还没想明白,就让模型从几条互相矛盾的样本里猜。
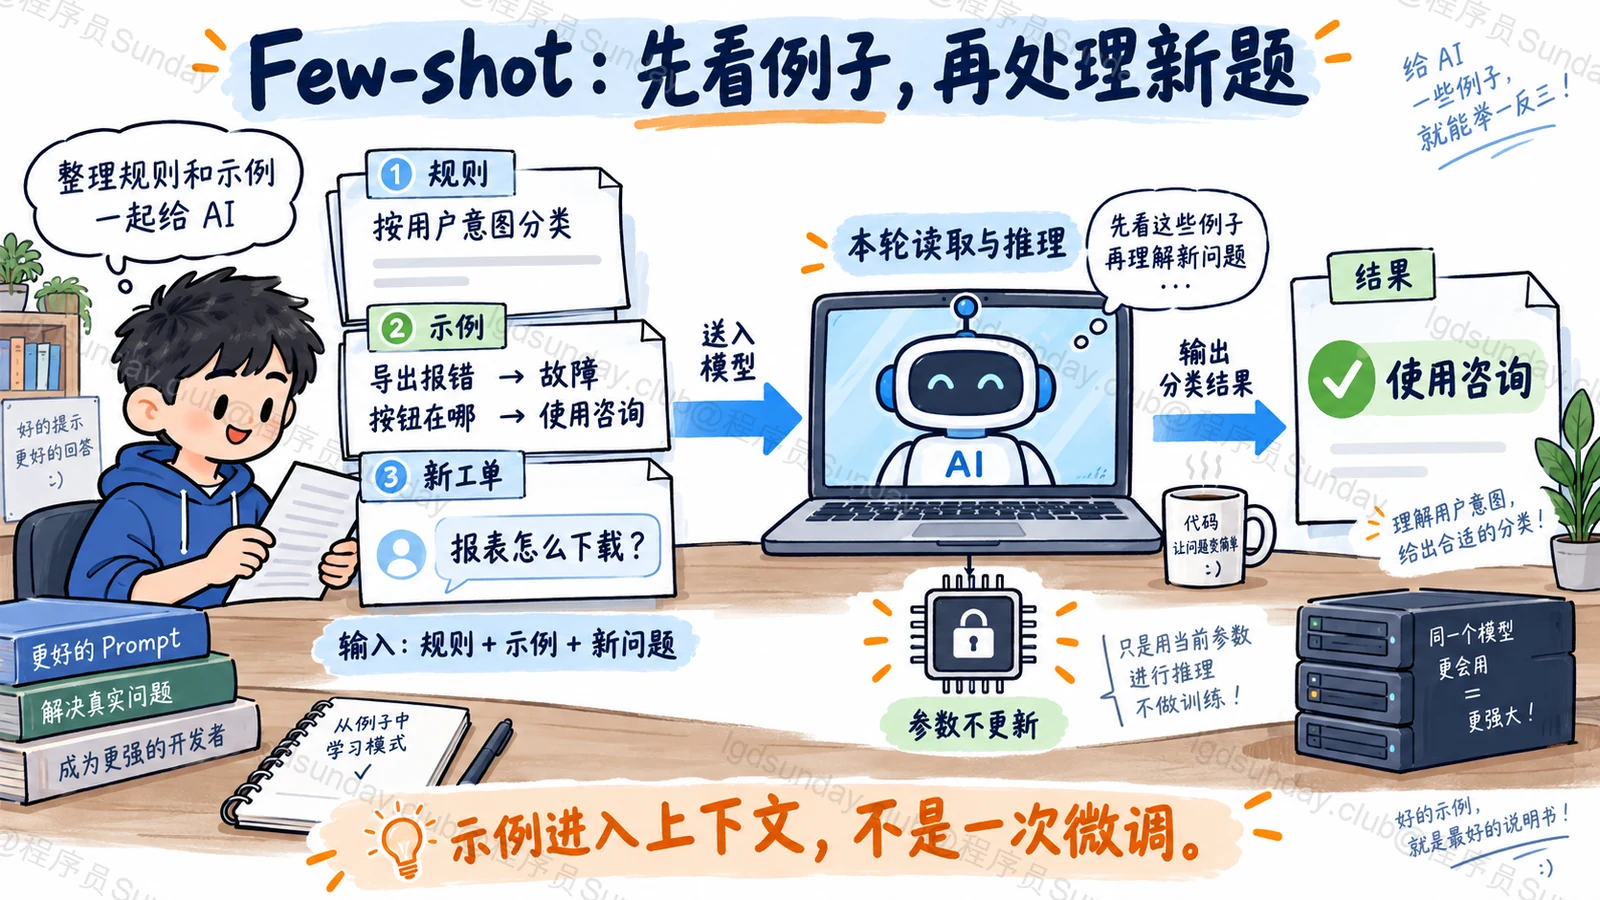
Few-shot 是把正确做法放进这次输入
咱们可以在规则后面加上这样的内容:
示例一:点击导出后提示服务器错误。→ 故障
示例二:请问导出按钮在哪里?→ 使用咨询
示例三:希望以后可以把报表导出成图片。→ 功能建议
待分类工单:想把本周报表下载到电脑上,应该点哪里?
模型看到的不再只有几个类别名称,还能看到“什么样的表达,对应什么样的结果”。最后那条工单虽然换了说法,但问的仍然是操作方法,按咱们的标准应该归为使用咨询。
不给例子、只说明任务,通常叫 Zero-shot;给出少量例子,就是这里说的 Few-shot。它们描述的是提示方式,不是两个不同的模型。Google 的提示设计文档也用这个区别解释两者。
这里的“理解了”,别直接等同于“训练好了”。
请求发出去时,模型读取规则、示例和新工单,然后生成分类结果。正常的这次推理没有训练步骤,不会因为这些示例而调整参数。《Language Models are Few-Shot Learners》讨论的这种用法,就是在不做梯度更新的情况下,通过文本提供任务和示例。
因此,换成一条不带历史的独立请求,模型不会自动带着刚才那几条示例继续工作。聊天里看起来“记住了”,通常是应用又把相关历史传了进去。
该补什么例子,要看它究竟分错在哪里
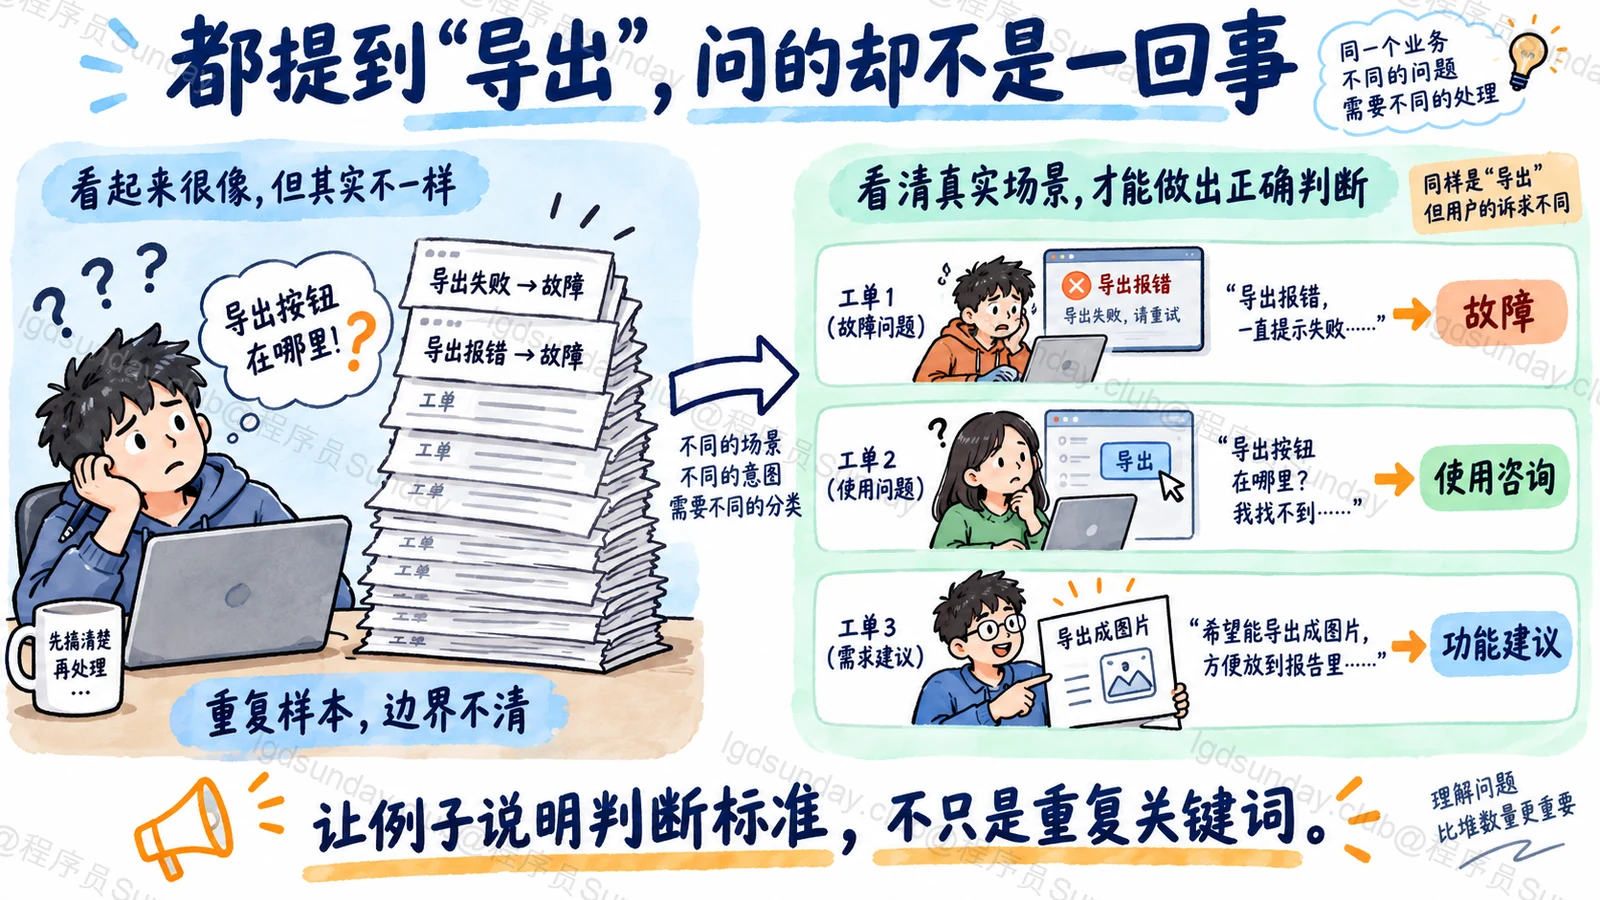
再回到开头。十条样本都是“导出失败→故障”,为什么补了很多,还可能分错?
因为这些样本只展示了一种情况,没有告诉模型:“导出”这个词本身,不足以决定类别。我们想教的是用户意图,示例却一直在重复同一种措辞。
这时,补一条“导出按钮在哪里→使用咨询”,往往比再补一条导出报错更有针对性。它让两个容易混淆的情况同时出现,区别就在眼前。Anthropic 对示例的建议也强调相关性和多样性,避免让模型从重复样本里归纳出无关的规律。
不过,也别从一个极端走到另一个极端,只收集稀奇古怪的边界题。上线以后,大部分输入可能还是普通工单。例子既要有常见问法,也要覆盖实际出现过的混淆情况。
整理样本时,可以逐条问:这个例子是在补充一种新的判断情况,还是只换了几个字?如果是后者,就未必需要放进去。
怎样知道补例子真的有效?
先留一批没有放进提示词的工单,按业务规则人工核对类别。之后让同一个模型,分别使用“只有规则”和“规则加示例”两版提示词处理它们。
不要只看总共答对多少。咱们关心的“使用咨询被错分成故障”,有没有减少?修好导出相关问题以后,登录、成员管理这些工单有没有变差?信息不足时,是进入待确认,还是随便选一个类别?
示例数量也可以这样比较。少量示例已经够用,就不必把整个工单库发过去;继续增加以后,只有输入变长、耗时增加,分类却没改善,那么这部分例子就没有保留的必要。
如果样本很多,可以按新工单选择相关示例,但仍要照顾容易混淆的类别。只按字面相似度找,可能又选出一整排“导出故障”,回到原来的问题。
还有一点要特别注意:调试时反复看过、据此改过提示词的那批工单,已经参与了方案选择。最后还需要另一批没有参与调整的题,检查效果是否能保持。否则只是把这一小批题越改越熟。
面试官继续追问
例子里的答案和文字规则冲突,模型会听谁的?
不能指望它每次都按我们的想法解决冲突。先统一标注标准,修正样本,再发给模型。如果连业务人员都对分类有分歧,就先明确规则,而不是继续堆例子。
用 Few-shot,是不是就不用做结构化输出了?
不是。例子主要演示“怎么判断、怎样回答”,不能保证输出一定符合程序要读的结构。需要固定字段和类别时,仍可使用模型支持的结构化输出,并在后端验证。结构合规和类别判断正确,也要分开检查。
能不能让模型自己生成示例?
可以用来起草,但要按业务标准核对,尤其是容易混淆的工单。模型生成的标签不天然正确,更不能拿同一批自生成样本既当示例,又当证明效果的测试题。
面试速记卡
- Few-shot:在输入里给少量正确示例,再处理新问题。
- 主要作用:把抽象要求变成具体判断和输出方式。
- 与微调的区别:示例进入上下文,正常推理不更新参数。
- 选例子:覆盖常见任务和混淆边界,不只堆相似句子。
- 验证效果:用未参与提示调整的新题,同时检查错误类型与成本。
