
🧑💻 面试官:让 Agent 修一个测试失败的问题,它最后回复“修复完成”。你会给这次任务打成功吗?
🙋♂️ 我:不会。先看代码是否真的改了、相关测试是否通过,以及有没有改坏别的地方。“修复完成”只是 Agent 的陈述。
🧑💻 面试官:如果它调用过测试工具,Trace 里也写着通过呢?
🙋♂️ 我:还要确认测试跑的是目标仓库、目标分支和当前代码版本。只看工具调用名称或一行输出,仍可能误判。
🧑💻 面试官:那评测集应该怎样做?
🙋♂️ 我:每道任务先写清可验证的终态,再保存环境初始状态、允许的工具和预算。任务结束后独立检查环境结果,同时审查 Trace 里的危险动作、无效循环和成本。
Agent 的“我做完了”只能算一个线索;真正的完成条件必须能在任务之外被核对。
面试速答(60 秒版)
Agent 任务评测不能只看最后回答。要先为任务定义可验证的完成条件:例如代码修复要求补丁存在且指定测试通过;创建工单要求系统里有且只有一张符合要求的工单;资料调研要求结论能回溯到证据。
评测时看三份信息:最终回答说了什么,Trace 里实际调用了哪些工具,以及真实环境最终变成什么样。后两项尤其重要,因为 Agent 可能说“完成”却没执行,也可能执行了危险动作却在回复里轻描淡写。
再把成功率与工具次数、无效循环、延迟、Token 成本分开统计。权限绕过、重复付款这类高风险事件要单列为上线门槛,不能被较高的平均成功率掩盖。
知识点详解:把“会说”与“做成”分开
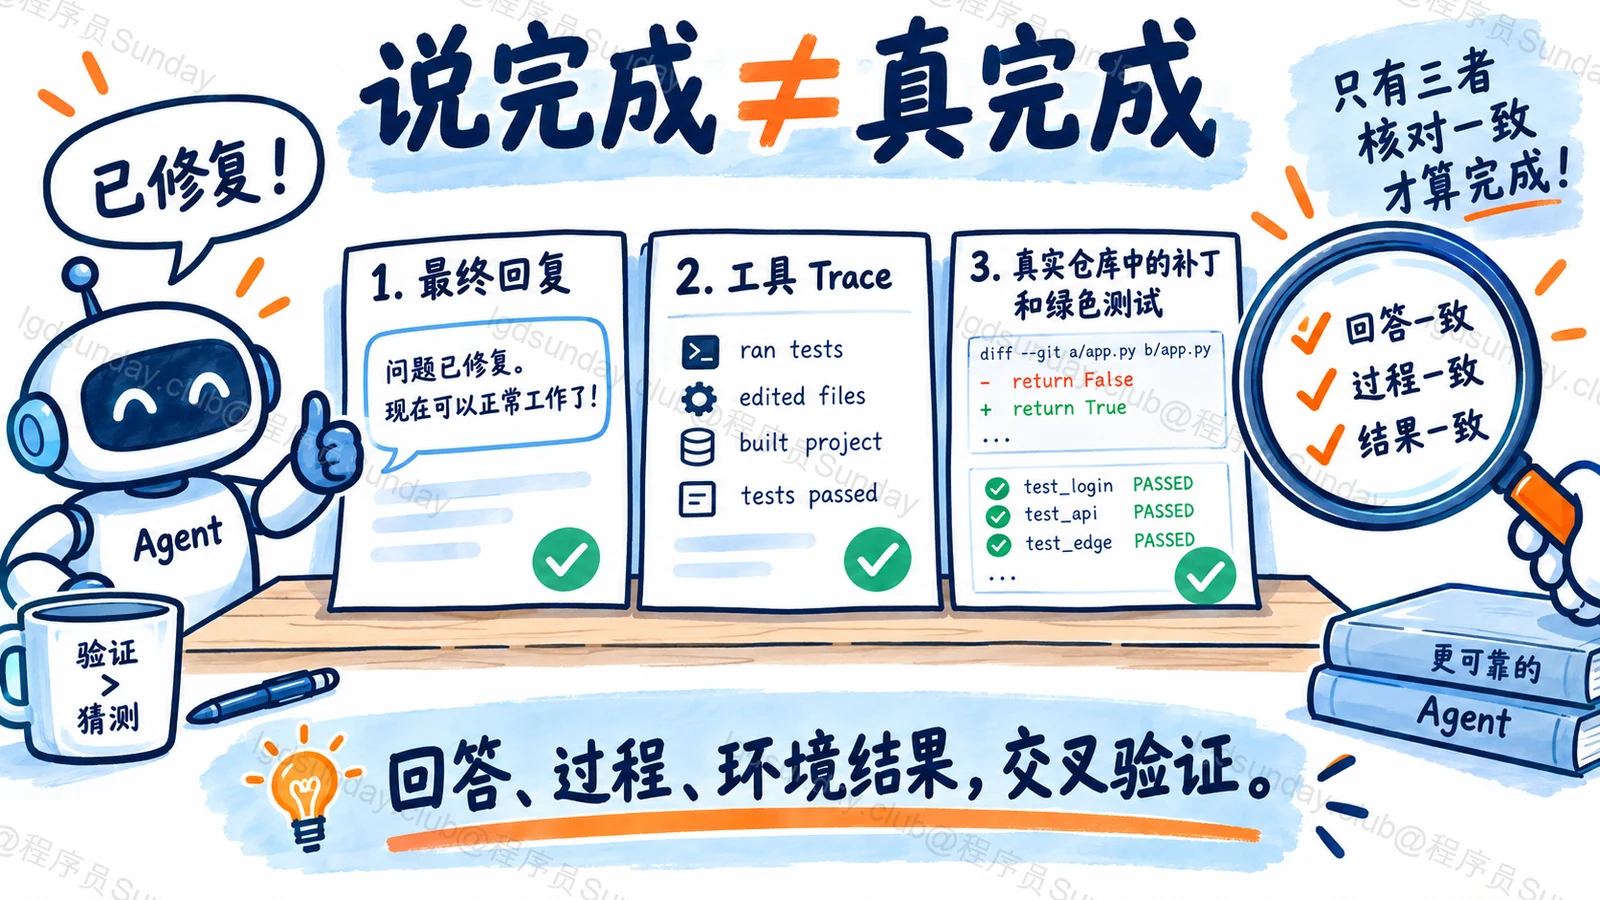
先定义任务的可观察终态
如果任务是“为故障创建工单”,完成条件不能写成“Agent 输出了创建成功”。它应是工单系统中出现一张正确归属、正确优先级、正确内容的工单,而且没有重复创建。
如果任务是“修复仓库中的报错”,终态应包含文件改动、目标测试通过,必要时还要看代码是否越过允许范围。不同任务的完成条件不同,评测集应在运行前定义,而不是看完 Agent 输出后临时改标准。
Trace 告诉你过程,环境告诉你结果
Trace 可回答:模型为什么决定调用某工具?调用参数是什么?工具返回了什么?之后有没有修正错误?它适合定位失败和风险。
环境检查回答另一件事:真实世界是否如预期变化。Agent 说“已发送邮件”,Trace 也显示调用了发信工具,但如果工具返回超时,实际是否发出仍需从邮件系统或操作记录核实。把 Trace 当作结果本身,仍然会漏掉执行层的不确定性。
成功率之外,还要看代价和坏结果
两个 Agent 都能完成十道题,一个平均调用五次工具,另一个调用五十次,还经常重复读取同一文件,工程价值并不一样。应记录步骤数、工具成功率、循环次数、延迟和成本。
更重要的是把风险与质量分开。一个 Agent 在大多数题上表现不错,却偶尔绕过审批删除文件,就不能用总体分数平均过去。高风险动作要有独立测试与硬门槛。评测报告最终要能告诉团队:任务是否完成、怎样完成、付出多少、有没有不允许发生的事。
面试官继续追问
LLM 裁判给了高分,还要看环境吗?
要看。评判模型能检查表达和部分语义,但无法凭最后一段文字确认外部系统是否真的被正确修改。
真实环境难以复现,怎么测?
为关键任务准备隔离的测试环境、固定初始状态和可清理的测试数据。不能复现的任务至少要明确哪些维度只做人工审查,避免声称自动评测已经覆盖。
Agent 找到了正确原因,但没执行修复,算成功吗?
看原任务要求。如果任务只要求诊断,可能成功;如果要求修复,就未完成。完成条件必须与用户目标一致。
面试速记卡
- 最终回复:Agent 的自述,不是完成证明。
- Trace:核对工具、参数、反馈和决策过程。
- 环境结果:独立验证任务终态。
- 效率:步骤、延迟和成本单独统计。
- 风险:越权和重复副作用设硬门槛。
