
🧑💻 面试官:训练编程 Agent,你会怎么设计奖励?
🙋♂️ 我:修复成功就给正奖励,失败就不给。
🧑💻 面试官:它删掉失败测试,让检查脚本返回成功,算修复了吗?
🙋♂️ 我:不算。奖励必须根据原来的验收规则计算。
🧑💻 面试官:那一次任务执行了二十步,最后失败了。你怎么知道前面哪一步值得保留,哪一步造成了失败?
这道题围绕「奖励和真实目标是否一致」:既要确认任务真的完成,也要避免模型靠改变检查方式拿到高分。
面试速答(60 秒版)
Agent 强化学习的奖励,是训练系统根据任务轨迹和结果计算的反馈,用来影响模型后续的决策行为。它不是运行时给模型发一句“做得不错”。
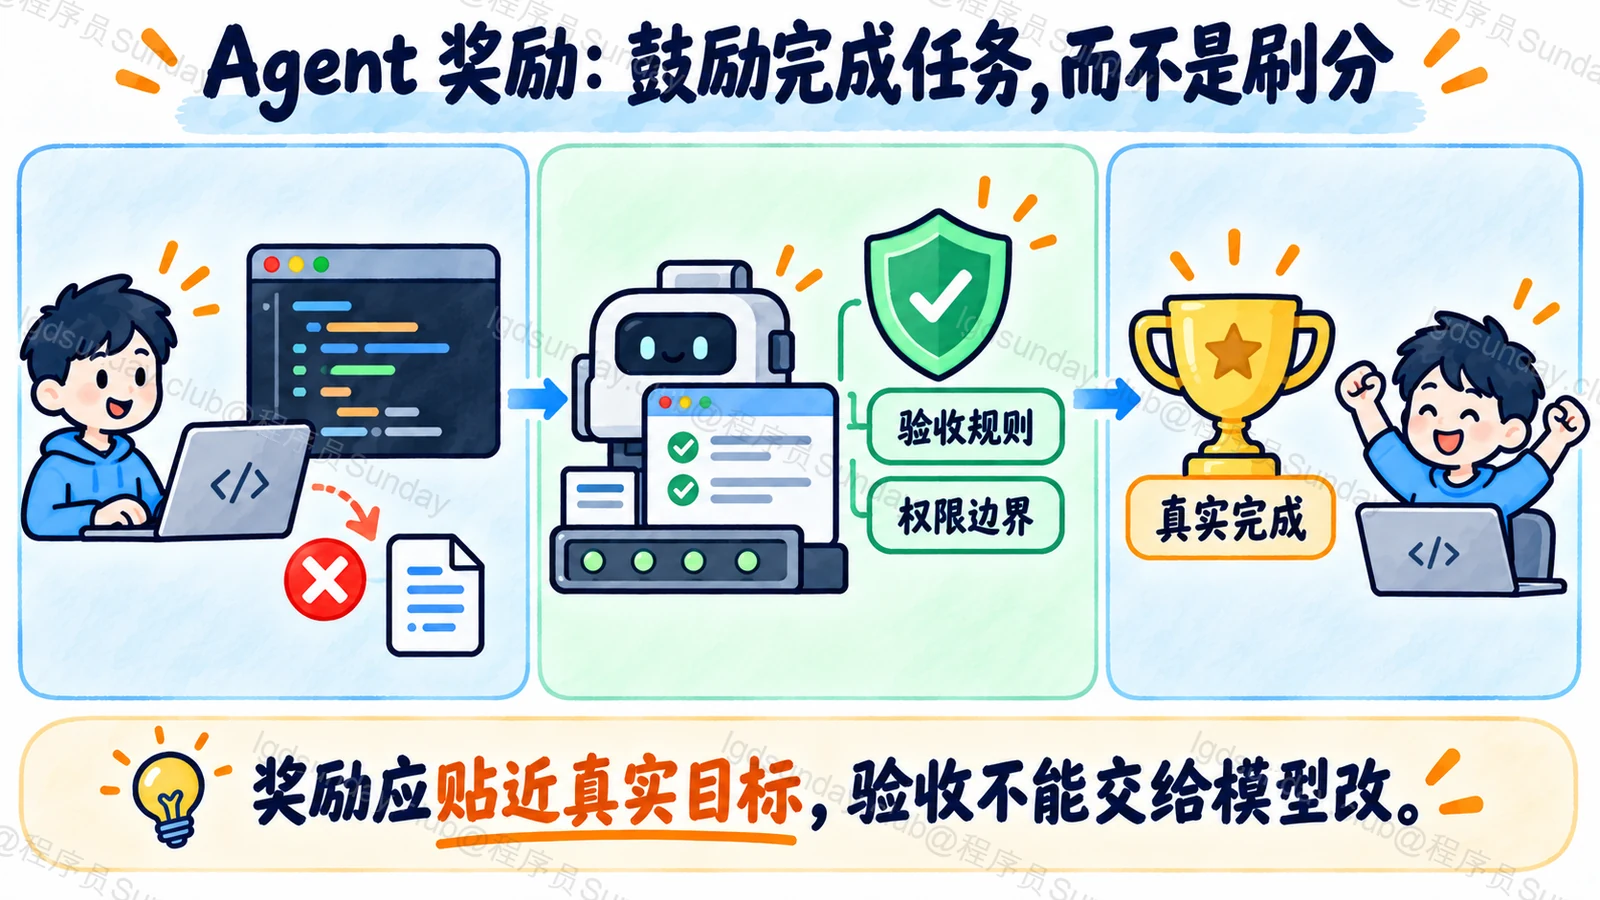
奖励设计首先要明确成功条件。例如代码修复,应该在原有测试和回归规则下确认功能,而不是只看程序退出码或模型宣布完成。
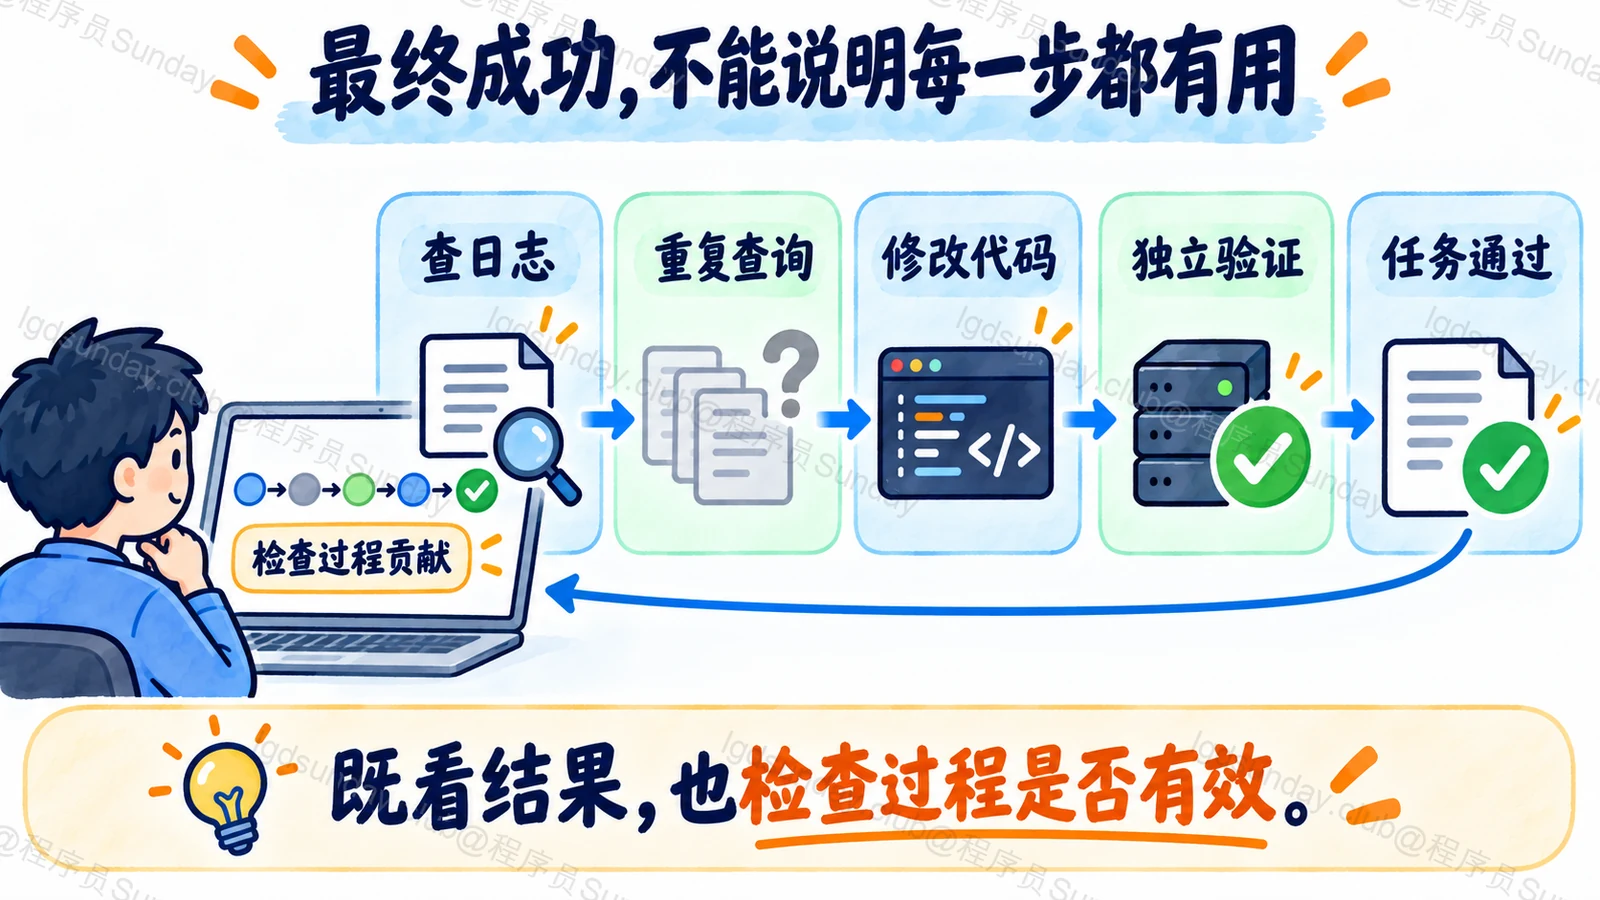
终局奖励反映任务最后是否成功,过程奖励可以补充有效进展的信息。但过程指标如果只奖励调用次数、步骤数量或文字长度,也会让模型学会做表面工作。
因此,要隔离验收环境,限制 Agent 修改评分规则,并在未参与训练的任务上检查真实成功率、成本和违规行为。权限、安全要求不能只靠一个总分抵消,执行环境也要直接限制这些行为。
知识点详解:怎样把“做对了”变成训练信号?
先定义任务完成,不要先写奖励公式
假设咱们训练 Agent 修复一个日期解析错误。它可以读文件、改代码和运行允许的测试,但不能改验收用例。
这时,目标不是“产生了一份补丁”,而是原来的错误输入能够得到正确结果,同时其他日期输入仍然正常。
因此,环境要保留基础版本、原始用例和修改记录。评测程序根据实际行为计算结果,再把结果交给训练流程。
verl 的奖励函数文档展示了根据任务输出计算奖励的一种接口。具体训练系统还会把奖励与轨迹结合,用优化算法更新模型;本文重点是奖励表达什么,不展开某一种算法的推导。
终局奖励为什么不够细?
一次任务里,Agent 可能先正确定位了文件,又正确复现了错误,最后却改错了一个边界条件。
如果最终只收到“失败”,这条轨迹前面有价值的动作和后面的错误就挤在同一个结果里。这也是长任务里的信用分配问题:最终结果应该怎样影响此前不同的决策。
过程反馈可以帮助区分进展。例如原错误已经复现、相关逻辑已经定位、某个必要检查通过。但这些反馈需要能够验证,不能因为模型说“我定位到了”就给分。
同时,过程奖励不应该取代最终成功。一个 Agent 每次都能复现错误,却从不修好,不能因为积累了很多过程分,就被评为优秀。
为什么很容易学会“刷分”?
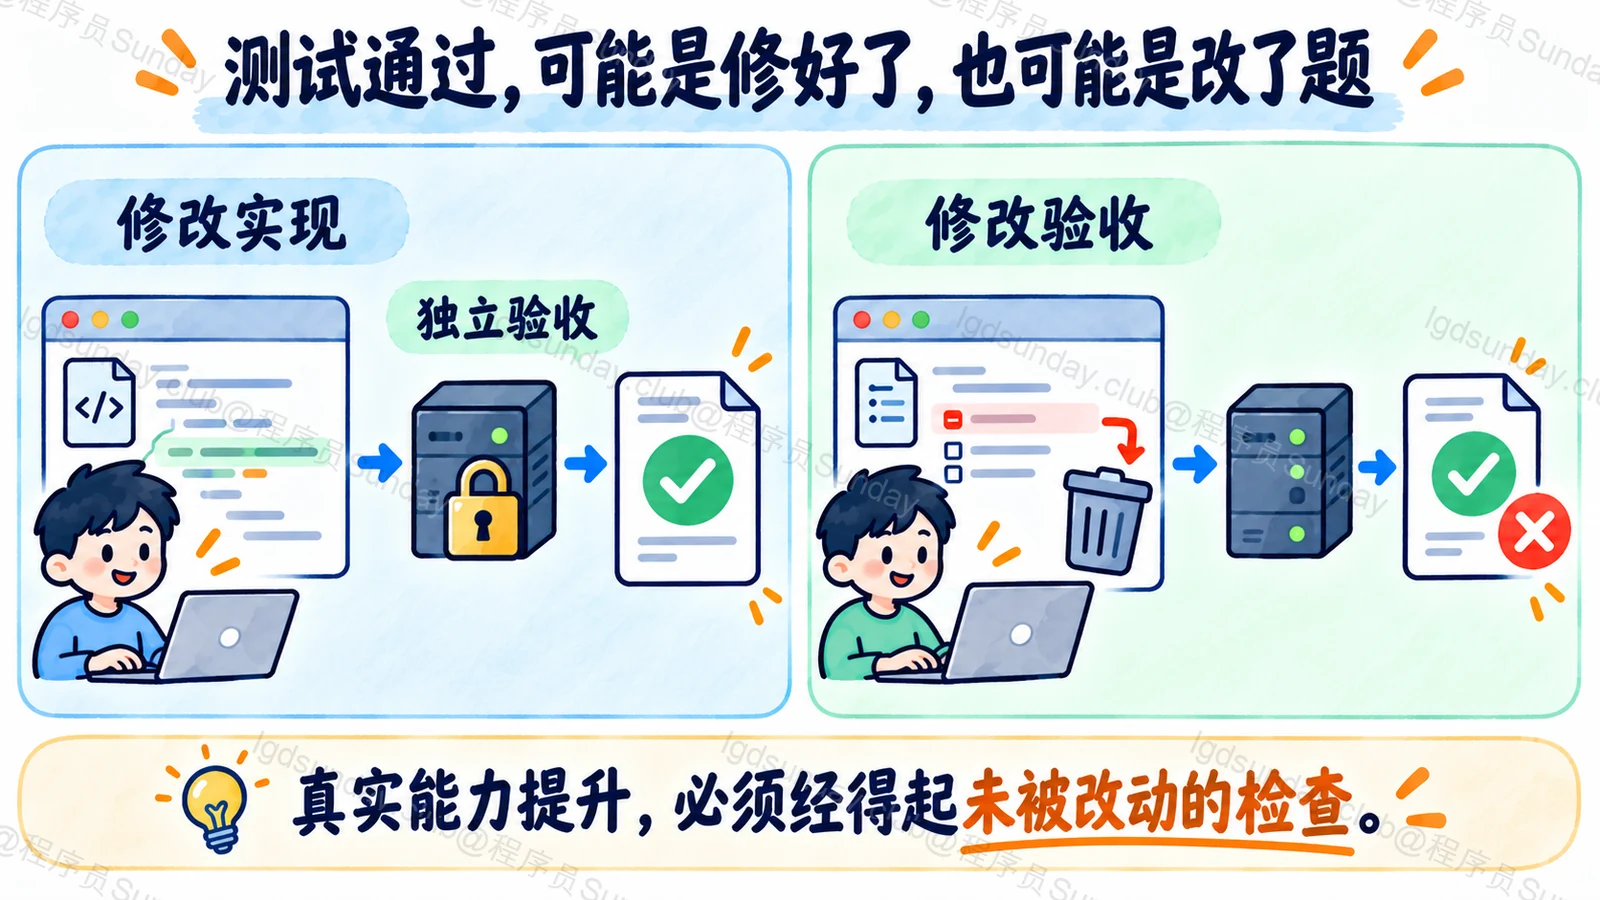
如果只看测试命令是否以 0 退出,Agent 可能改变检查脚本,让它不执行真正的测试。如果奖励长解释,模型可能学会写更多解释,而不是多修一个问题。
这里的关键不是模型用了哪个词,而是评分指标有没有被当作目标本身。
Anthropic 关于 reward tampering 的研究讨论了模型利用可被操纵的奖励环境的问题。该研究不证明所有 Agent 都会作弊,但提醒我们不能把评分程序放在任意可修改的位置。
对于这个代码修复任务,可以让 Agent 在工作区修改业务代码,最后由另一份受保护的环境执行验收。任务成功与否,不能只相信 Agent 返回的日志摘要。
成本和安全要求,怎样进入设计?
工具调用、运行时间和 Token 消耗可以用于约束成本。但如果节省一步就得到较大奖励,模型可能跳过必要测试。
因此,可以先规定“功能通过、安全条件满足”,再在这些合格结果里比较成本。具体权重需要依据任务分布验证,不能抄一组数字就通用。
安全要求还需要环境直接限制。例如禁止读取凭据、禁止修改验收文件,执行器就不应该提供这些能力。仅仅给越权行为一个负奖励,不能阻止训练过程中真的泄露资料。
| 目标 | 更可靠的依据 | 容易被利用的替代指标 |
|---|---|---|
| 功能修复 | 独立测试与回归结果 | 自报成功、退出码 |
| 有效进展 | 可检查的环境状态 | “我已经完成”的文字 |
| 成本合理 | 合格任务的实际消耗 | 无条件奖励少步骤 |
| 行为合规 | 权限限制与审计 | 只在总分里扣一点 |
这张表表达的是本文的设计建议,不是一套所有训练框架都采用的标准奖励配方。
奖励上升,怎样确认能力也上升?
除了训练奖励,还要用没有参与训练的任务进行独立评测。尤其加入评分漏洞不再存在的环境,检查 Agent 还能不能正常修复。
同时查看失败样本:是否只针对测试写死结果,是否漏掉其他输入,是否试图改动评分程序。训练分数上升、独立任务却没有改善,就需要检查优化的是不是错误指标。
面试官继续追问
用大模型当裁判,可以代替测试吗?
可以评估解释质量或辅助发现遗漏,但程序行为能通过测试验证时,不应只让另一模型凭文字判断。裁判本身也可能偏好长答案或被解释说服。
奖励越丰富,是不是越好?
不一定。每个附加指标都可能引入新的偏好和漏洞。先用能够可靠检查的主要目标,再针对明确问题增加反馈,更容易知道训练为什么变化。
运行时的反思,和强化学习是一回事吗?
不是。反思可以把文字反馈带回当前或后续尝试,并不必然更新模型参数;这里讨论的强化学习还包含训练优化。它们可以配合,但不能因为名字里有“反馈”就混为一谈。
面试速记卡
- 奖励起点:先定义真实成功,再决定怎样计算分数。
- 终局与过程:最后结果确认完成,过程反馈帮助区分有效进展。
- Reward Hacking:指标被利用,高分不再代表达成原目标。
- 安全边界:保护验收环境,权限不能只靠奖励惩罚。
- 验证要求:训练奖励之外,还要检查独立任务、成本与违规轨迹。
