
Agent Memory 如何写进简历?常见面试问题与回答思路
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
好了,到这里,第六章就全部结束了。
这一章的内容确实不少。
咱们从“保存聊天记录”开始,一直讲到了短期记忆、长期记忆、记忆提取、更新、遗忘和召回,最后完成了一个 AI 面试教练 Agent。
那么最后这个小节,咱们就把整章的内容总结一下
第六章都学了啥
01-从保存聊天记录,到让 Agent 真正用上记忆
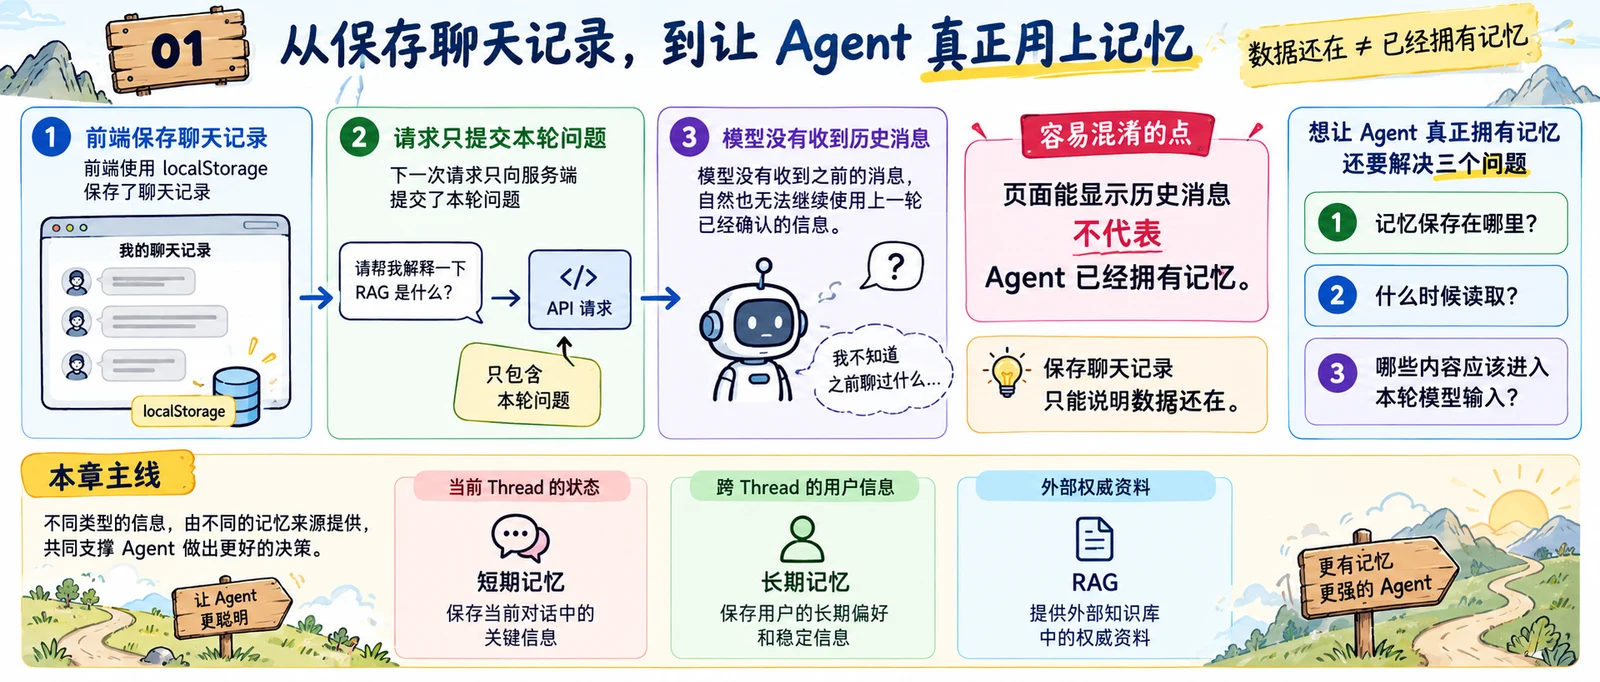
第一小节先分清了一件很容易被混淆的事情:页面能显示历史消息,不代表 Agent 已经拥有记忆。
咱们通过代码看到,前端虽然使用 localStorage 保存了聊天记录,但是下一次请求只向服务端提交了本轮问题。模型没有收到之前的消息,自然也无法继续使用上一轮已经确认的信息。
所以,保存聊天记录只能说明数据还在。想让 Agent 真正拥有记忆,应用程序还要解决三个问题:记忆保存在哪里、什么时候读取,以及哪些内容应该进入本轮模型输入。
这一节也提前建立了全章的主线。当前 Thread 中的状态交给短期记忆,跨 Thread 的用户信息交给长期记忆,外部权威资料则继续由 RAG 提供。
02-短期记忆与会话恢复
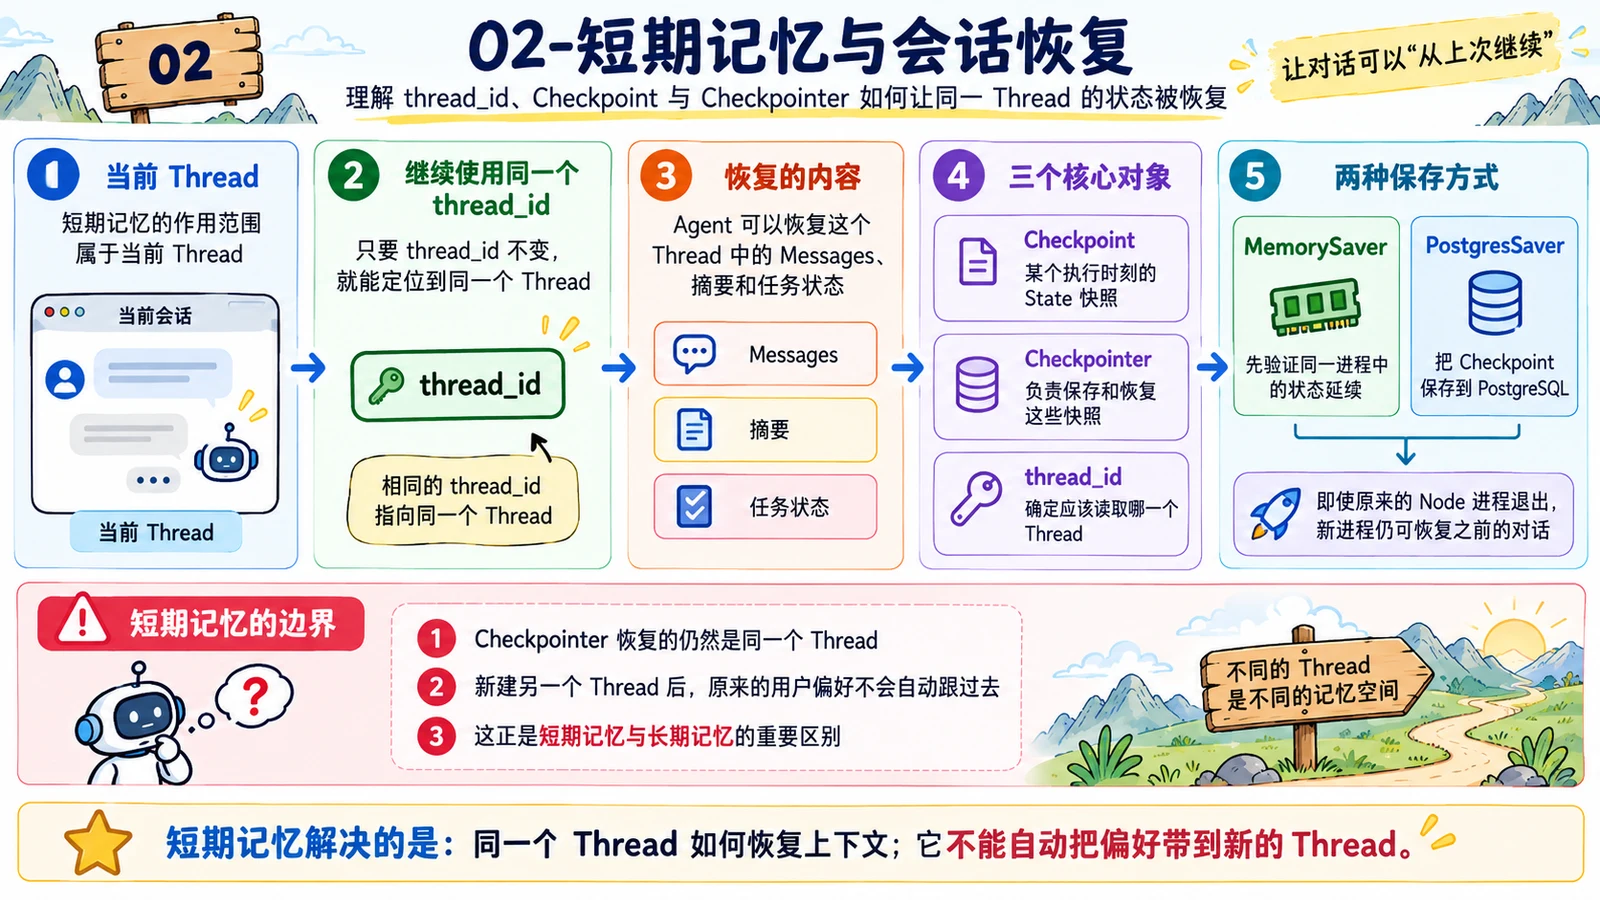
第二小节讲了短期记忆。
这里的“短期”指的是信息的作用范围属于当前 Thread。只要继续使用相同的 thread_id,Agent 就可以恢复这个 Thread 中的 Messages、摘要和任务状态。
实现这项能力时,咱们又认识了三个对象:
Checkpoint是某个执行时刻的 State 快照Checkpointer负责保存和恢复这些快照thread_id则用来确定应该读取哪一个 Thread
随后,咱们先使用 MemorySaver 验证同一进程中的状态延续,再换成 PostgresSaver 把 Checkpoint 保存到 PostgreSQL。这样即使原来的 Node 进程已经退出,新进程仍然可以恢复之前的对话。
但是,Checkpointer 恢复的仍然是同一个 Thread。用户新建另一个 Thread 以后,原来的用户偏好并不会自动跟过去,这也是短期记忆和长期记忆最重要的区别。
03-Agent 长上下文治理
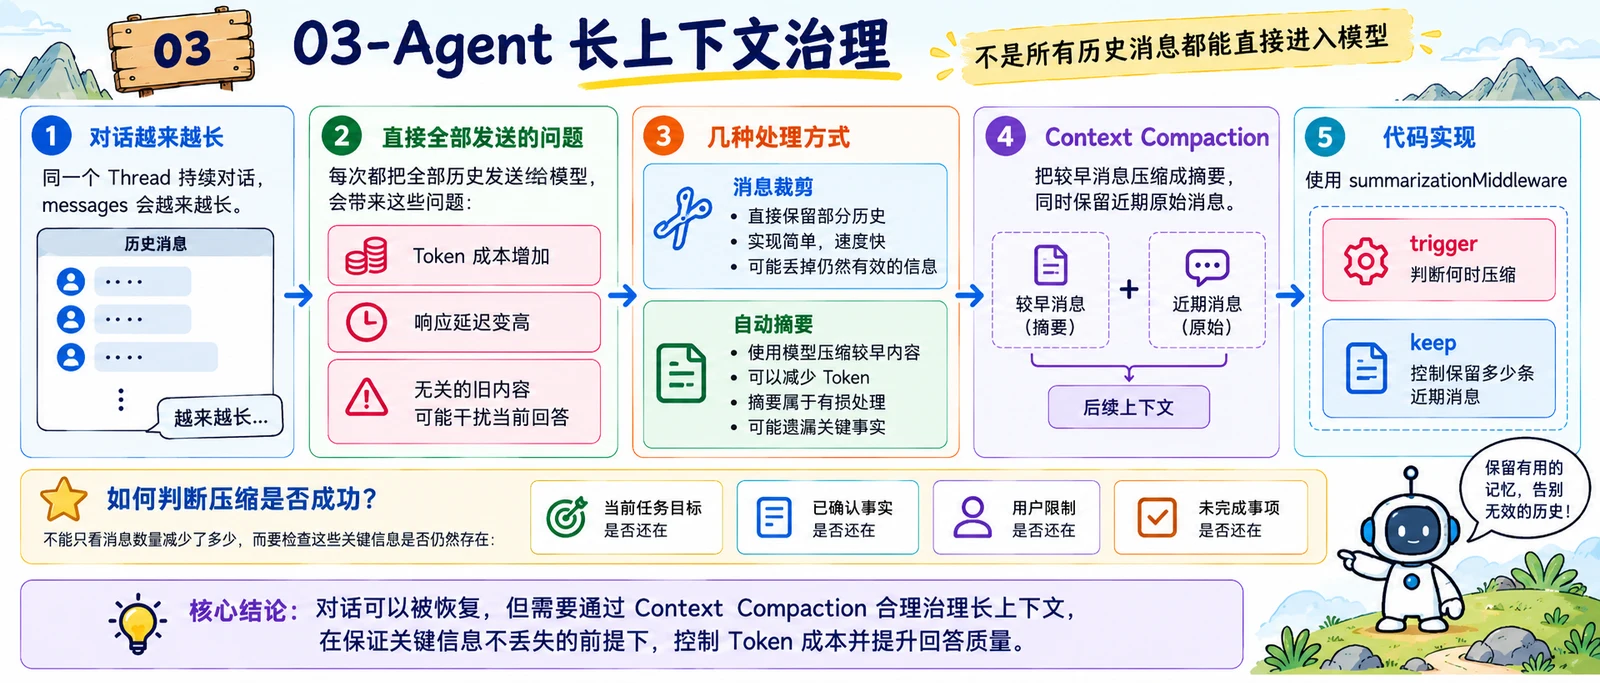
对话可以被恢复,不代表所有历史消息都可以直接进入模型。
随着同一个 Thread 不断对话,messages 会越来越长。每次都把全部历史发送给模型,不仅会增加 Token 成本和响应延迟,还可能让已经无关的旧内容干扰当前回答。
所以,咱们比较了几种处理方式。
- 消息裁剪直接保留部分历史,速度快,但是可能丢掉前面仍然有效的信息
- 自动摘要会使用模型压缩较早内容,但是摘要本身属于有损处理,也可能遗漏关键事实
这一节所说的 Context Compaction,就是把较早消息压缩成摘要,同时保留
本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

