
Agent 上下文压缩:消息裁剪、自动摘要与 Context Compaction
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
上一小节,咱们使用 Thread + Checkpointer 实现了短期记忆。
同一个 Thread(会话窗口) 第二次调用时,LangGraph 会先恢复之前保存的 State。
用户在这个基础上继续进行准问的时候,Agent 就可以从历史消息中找到对应的信息并返回了。
咱们来看个场景,就用咱们之前用过的售后场景就可以。
用户最开始告诉 Agent:
订单 A2048 是一台 3800 元的咖啡机,外壳破损。
我还没有上传破损照片,客服说超过 3000 元需要人工审核。
请只告诉我处理流程,不要替我提交退款。
后面,这个用户又聊了周末营业时间、电子发票,还补充了咖啡机签收 3 天、外包装仍然保留。
最后他问:
根据前面说过的情况,这笔退款要走自动流程还是人工审核?
现在还缺什么材料?不要替我提交。
想要回答最后这个问题,模型就需要历史消息了。
但是,大家想一下,他需要的是全部的历史消息吗?
肯定不是的
它真正需要的不是历史里的每一句话,而是:订单号、金额、破损情况、照片状态、审核规则和用户不允许自动提交退款的限制。
至于“周末几点营业”,对当前问题已经没有用了。
因此,如果咱们什么都不处理,一次调用的过程就是下面这样的:
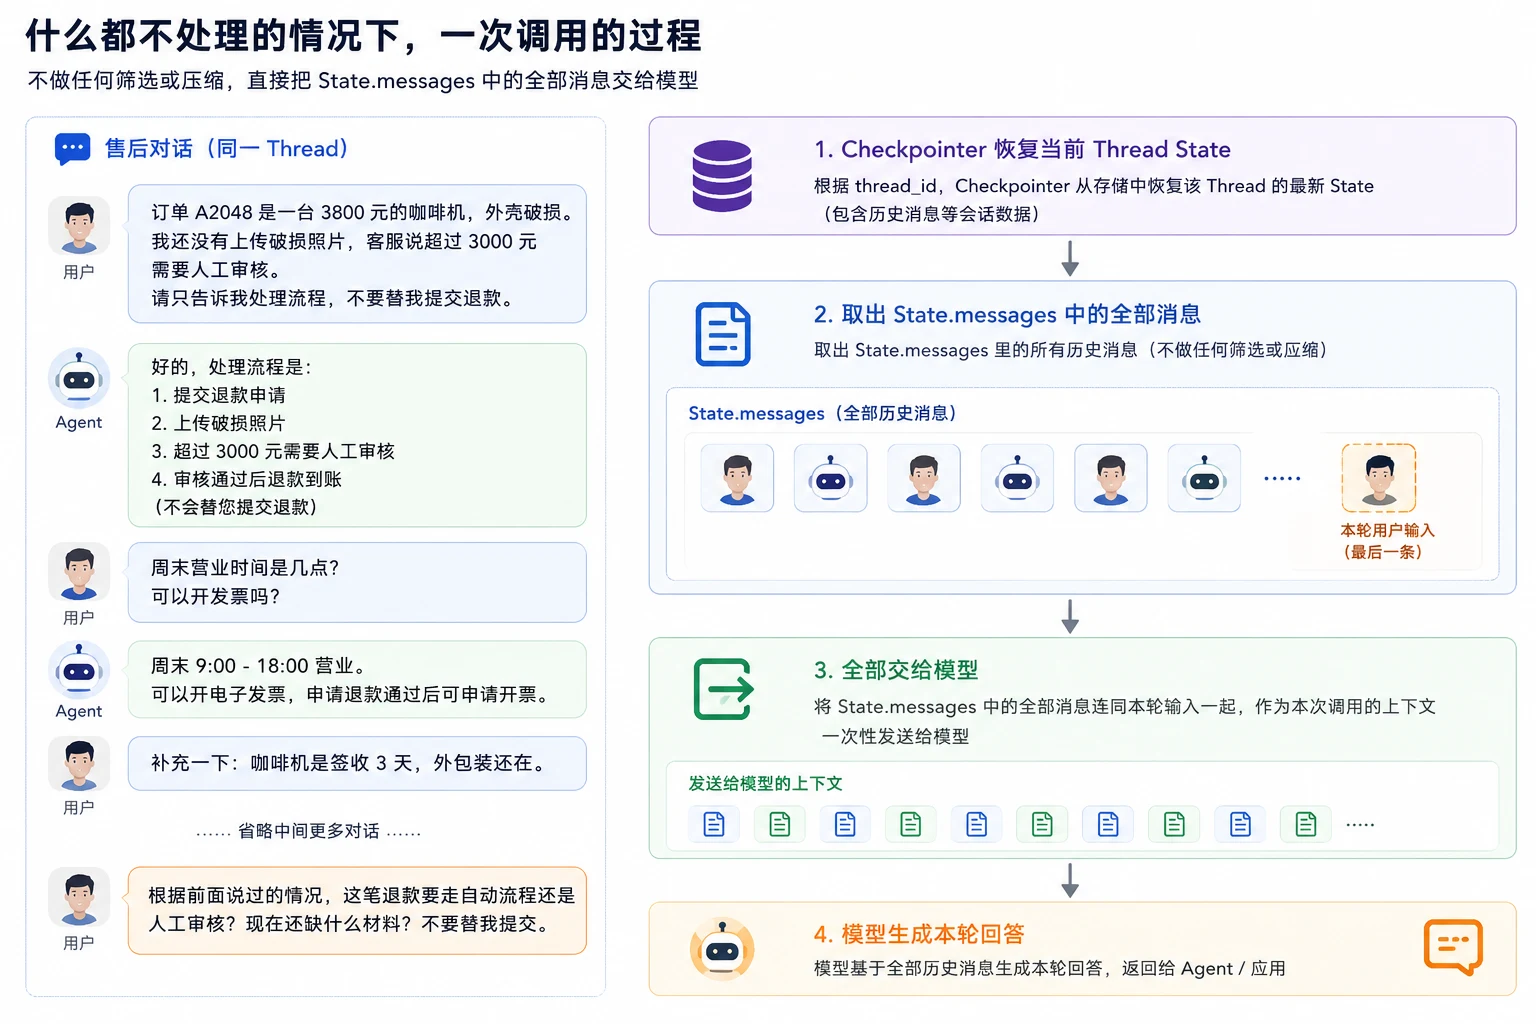
对话越长,messages 越长,模型每一轮需要重新处理的内容也越多。
但是,这里就会有一个问题,那就是:如果用户一直在这个窗口聊天,那是不是就意味着,聊天的信息会越来越多。
这样的话,就会带来三个问题:
- 调用成本继续增加
- 模型响应会变慢
- 大量已经没用的旧消息还可能干扰当前判断
如果想要解决上面这几个问题的话,那就不能只依靠短期记忆,还得依靠长对话处理了。
LangChain 官方的 Short-term Memory 文档给出了几种长对话处理方式。这一节主要看两种:
- 消息裁剪
- 自动摘要
消息裁剪、自动摘要和 Context Compaction 分别是什么
一个一个来看
消息裁剪
消息裁剪,也就是 Trim Messages。
简单来说就是:当历史消息太多时,只选择其中一部分交给模型。
最常见的就是只保留最近几条,大致是下面这样:
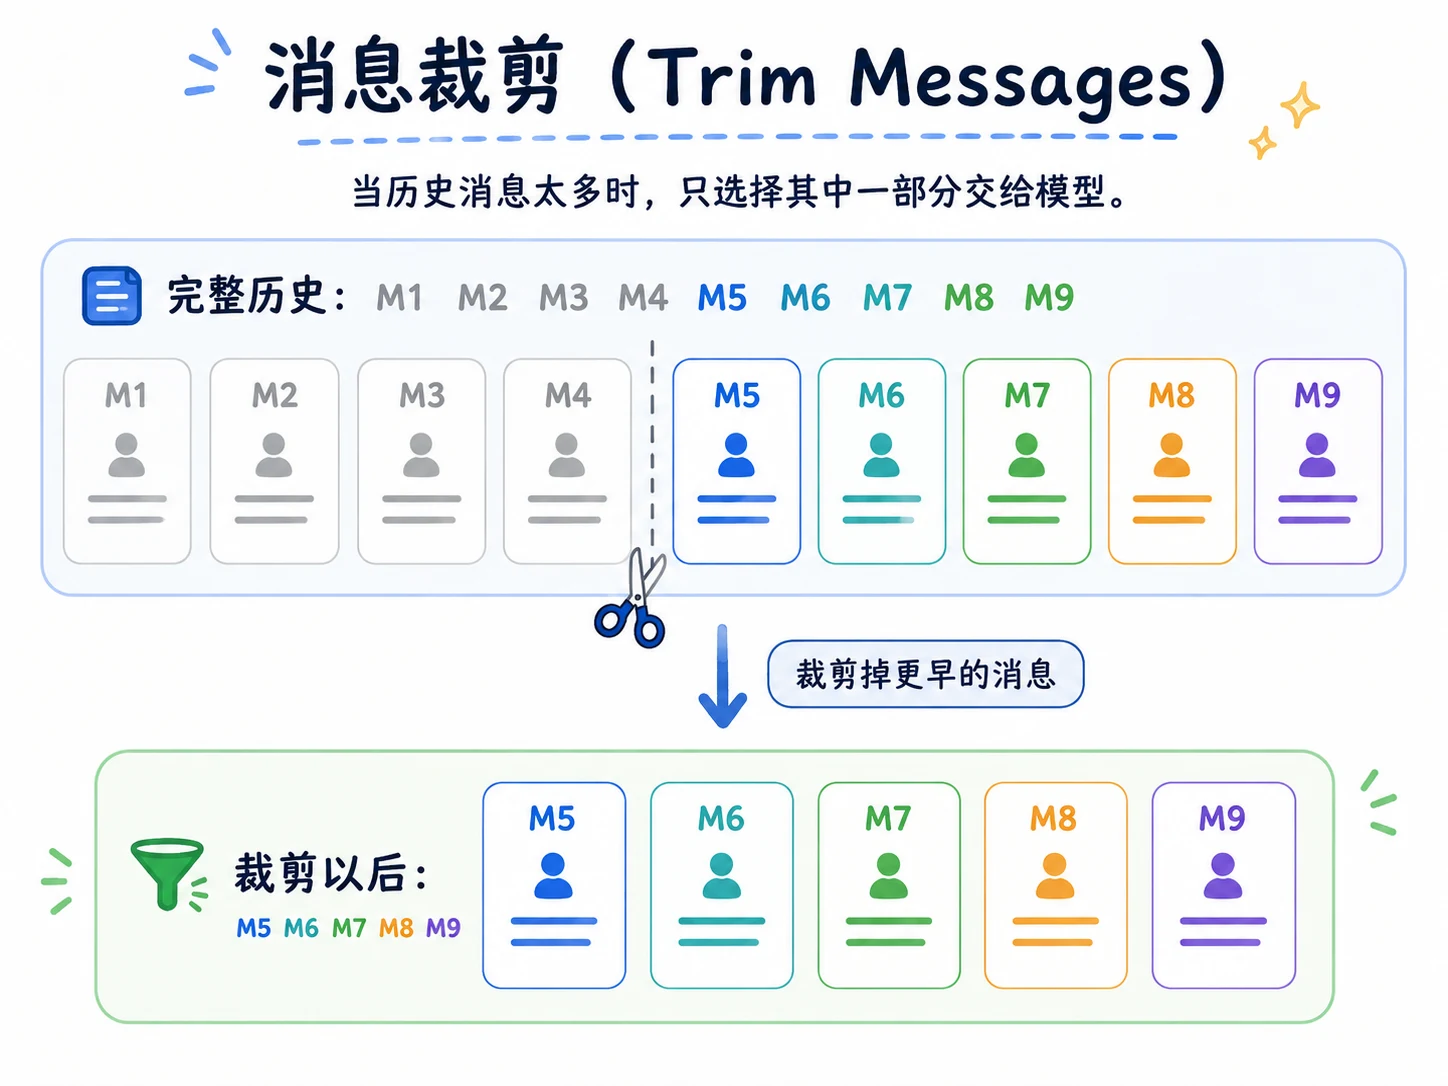
简单粗暴
但是这样做的话,也会有问题。
那就是:如果订单号和退款金额出现在 M1,直接保留最后五条消息以后,前面
本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

