
记忆提取:Agent 应该记住什么,什么时候写入
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
上一小节,咱们已经把长期记忆保存到了 Store 中了。
当用户明确提到:“请记住我的沟通偏好” 时
模型会调用 save_user_profile,然后把整理好的画像保存起来。
但是,这个场景其实是比较简单的场景。
因为用户都已经明确告诉 Agent:这句话需要记住 了。
但是大家想想,用户不可能每次跟 Agent 沟通都专门说这么一句话吧。
一般情况下,咱们跟 LLM 沟通,撑死就是这样:
我平时使用 TypeScript 开发,后续项目默认使用 Node.js。

不过这一次为了配合同事,请只用 Python 写当前脚本。

同事说财务部可能更喜欢 Excel,但我也不确定。

我的身份证号是 110101199001011234,请顺便保存下来。
这几句话都来自用户,但是显然不能全部保存成长期记忆。
- 第一句话说的是用户平时使用的技术栈,后面的新会话可能还会用到。
- 第二句话只要求 当前脚本 使用 Python。要是把它保存成长期偏好,下一次 Agent 可能就错误地使用 Python 了。
- 第三句话是用户转述的未确认信息。最后一句虽然明确要求保存,但是包含身份证号,也不能因为用户说了“保存”就直接写进 Agent Memory 里面。
所以,能够使用 Store 只是第一步。
接下来还有一个更麻烦的问题:Agent 应该从对话中提取什么,又应该在什么时候把它写入长期记忆?
记忆提取到底在做什么
Memory Extraction 可以翻译成 记忆提取。
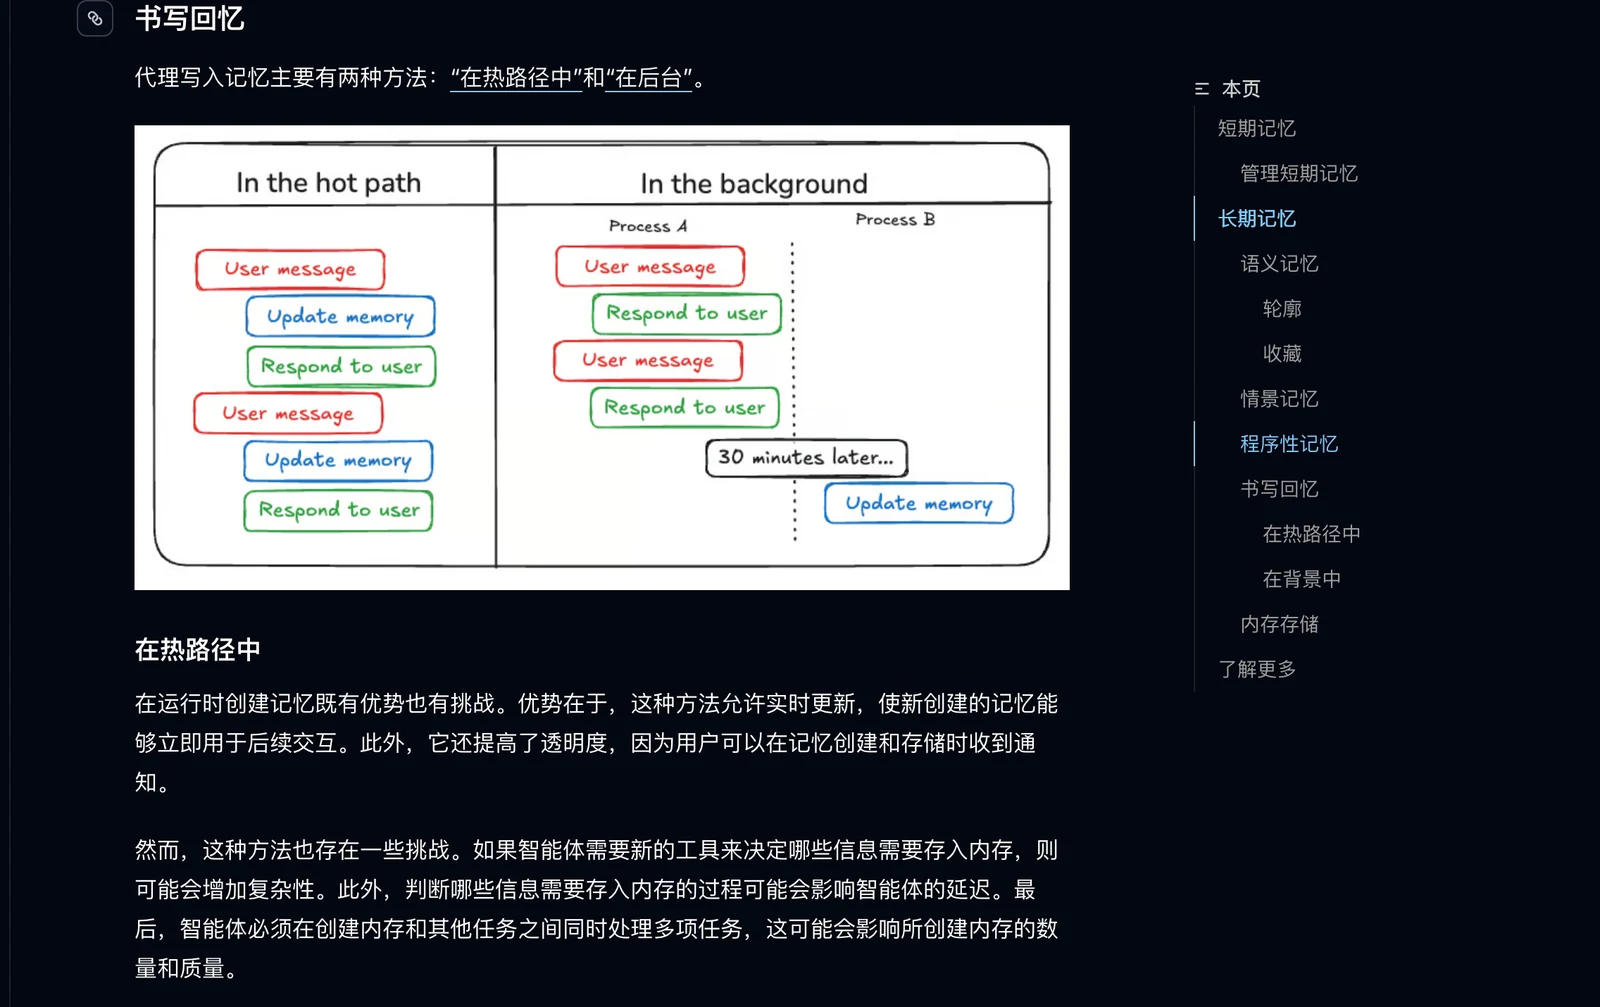
它是一种常见的 Agent 工程流程,简单来说:
记忆提取,就是从本轮对话中找出未来可能继续使用的信息,并把它整理成程序能够处理的结构化候选。
注意,这里说的是 候选。
模型认为某句话值得记住,不代表就必须保存。
因为模型可能把一次性要求「误判」成长期偏好。
因此,完整的记忆写入流程应该是这样的:
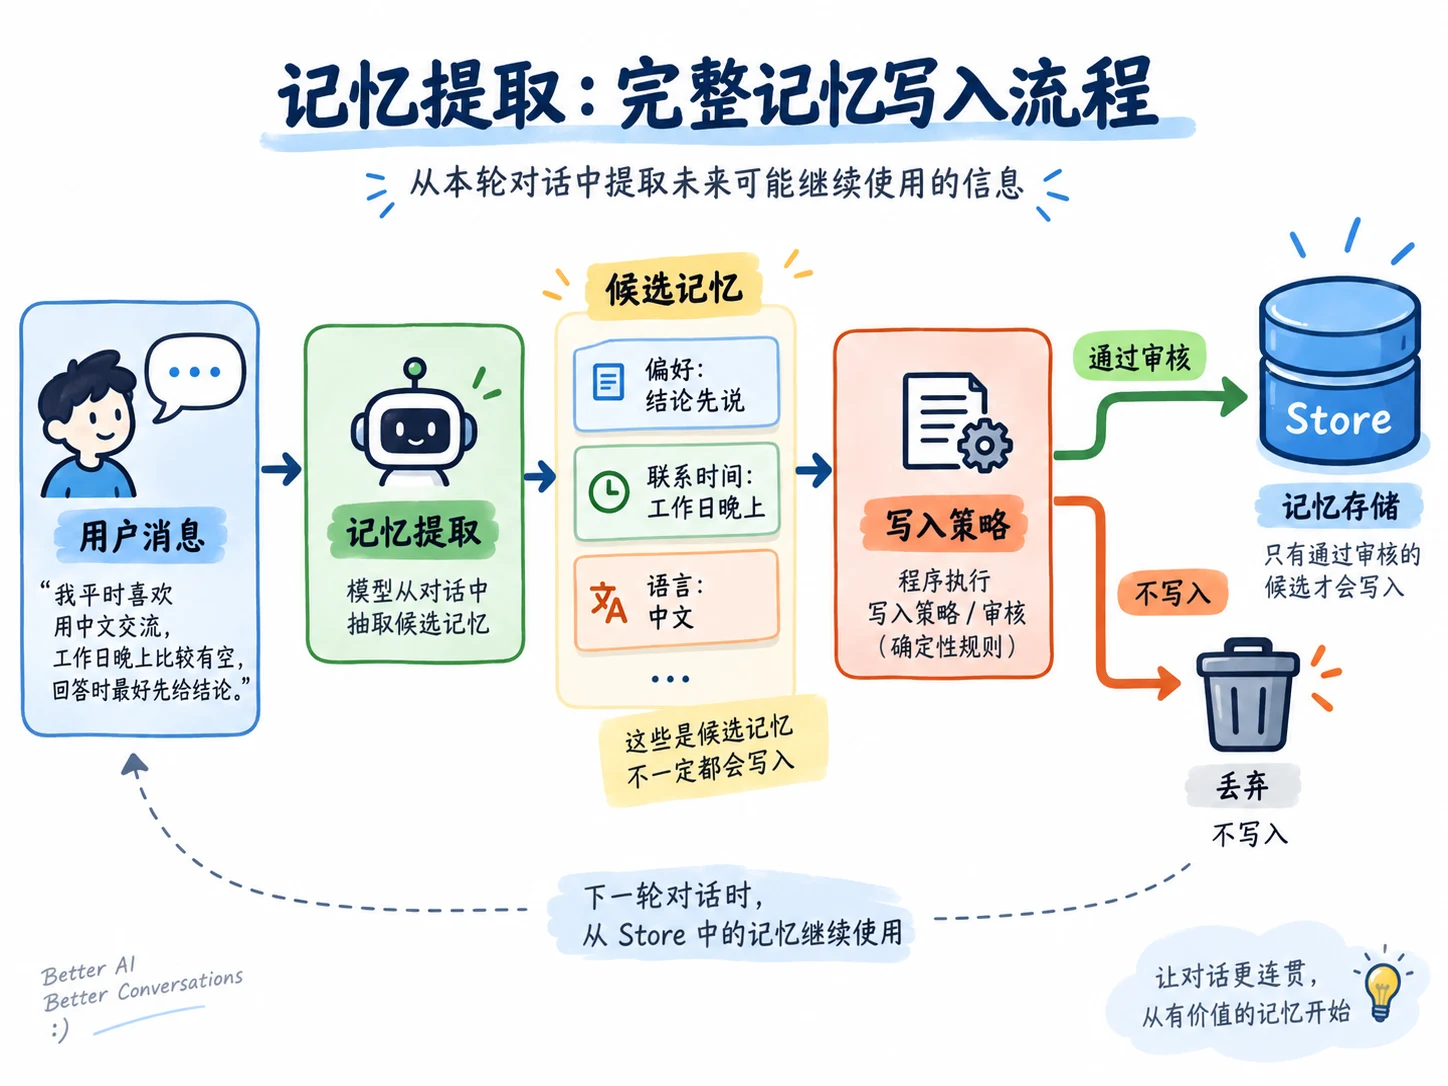
模型比较擅长理解自然语言,所以让它负责提取。
而 有没有保存许可、是否包含敏感信息 这些要求则更适合交给确定性代码的策略进行处理。
这就是咱们这一小节的核心:模型负责提取候选信息,Agent 程序掌握最终写入权限。
那么什么内容才值得长期保存呢?
前面的例子已经说明,不能只看用户的一句话里有没有 “请记住” 这种。
真正决定一条信息能不能写入的,主要来自于以下几点:
第一:看它的使用范围
“我平时使用 TypeScr
本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

