
Agent 记忆更新与遗忘:去重、冲突修正和删除
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
上一小节,咱们已经可以从对话中提取出一条候选记忆,然后经过程序审核,把真正值得长期保存的信息写入 Store。
不过,大家回头看一下上一节的 saveAcceptedMemories()。
每保存一条记忆,它都会调用 randomUUID() 生成一个新的 Key:
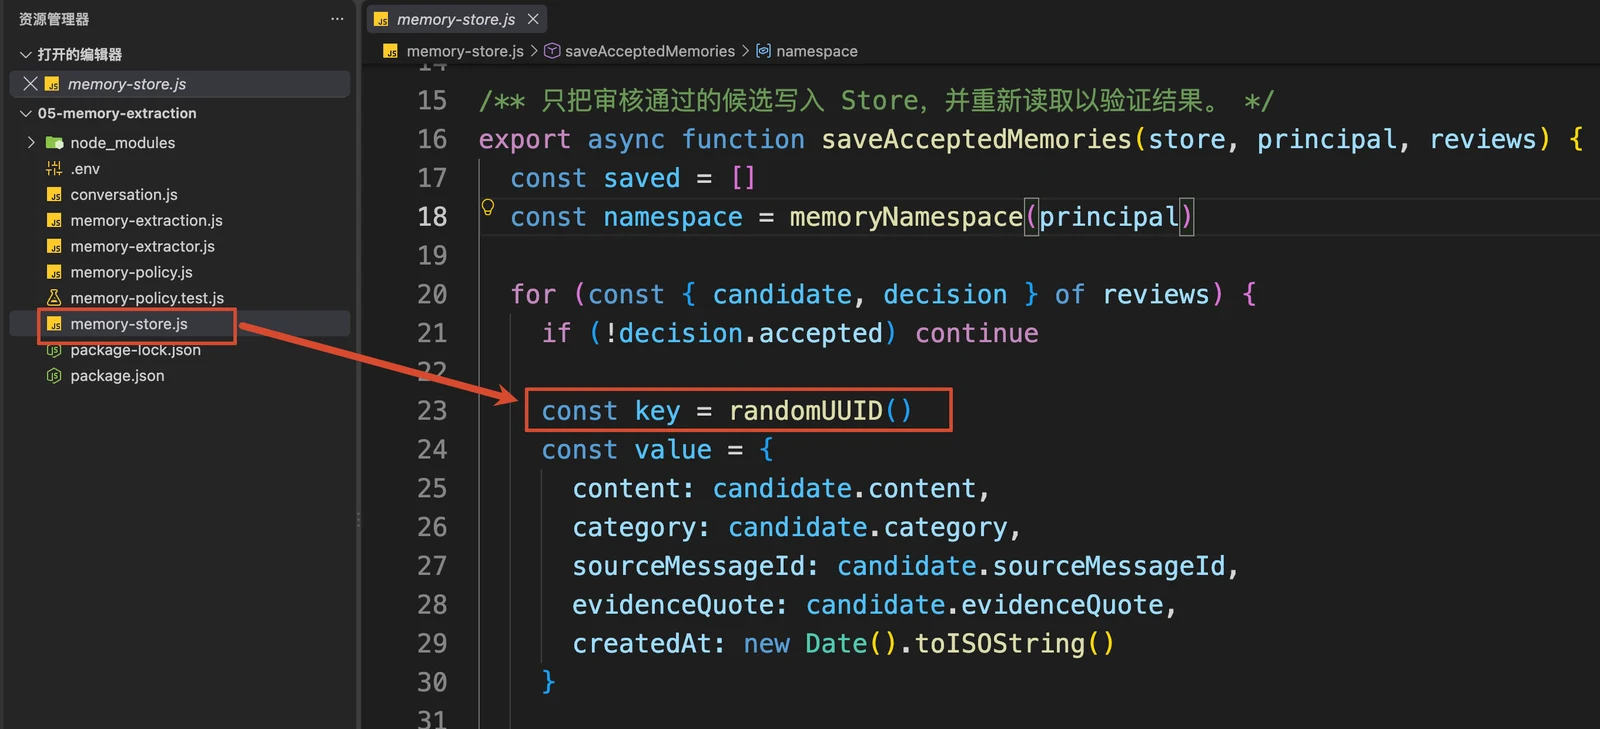
这样保存一条新信息当然没有问题。
但是,假设用户今天说:“以后默认使用 Node.js。”
明天又说:“后面的例子还是用 nodejs 吧。”
两句话都可以通过审核,也都会使用一个新的 Key 保存。
结果就是:同一个偏好,Store 里出现了两条。
如果仅仅只是重复,问题还不算特别严重。
假如过几天用户又说:“修改一下之前的偏好,以后默认使用 Python。”
现在 Store 里就会同时出现 “默认使用 Node.js” 和 “默认使用 Python” 两条冲突的内容。
那么,下一次 Agent 读取记忆的时候,到底应该相信哪一条呢?是吧。
那有同学可能会说,这不简单吗?
用户最后一次说的,肯定是最新的呀,直接覆盖不就可以了吗?
没有那么简单哈
这就是这一小节要解决的问题:当新的候选记忆出现以后,不能每次都直接新增。程序还要结合已有记忆,决定这一次到底应该怎么处理。
什么是语义记忆
根据 LangChain 官方的 Memory Overview 的描述,用户事实、用户偏好这一类长期记忆属于 Semantic Memory,也就是 语义记忆。
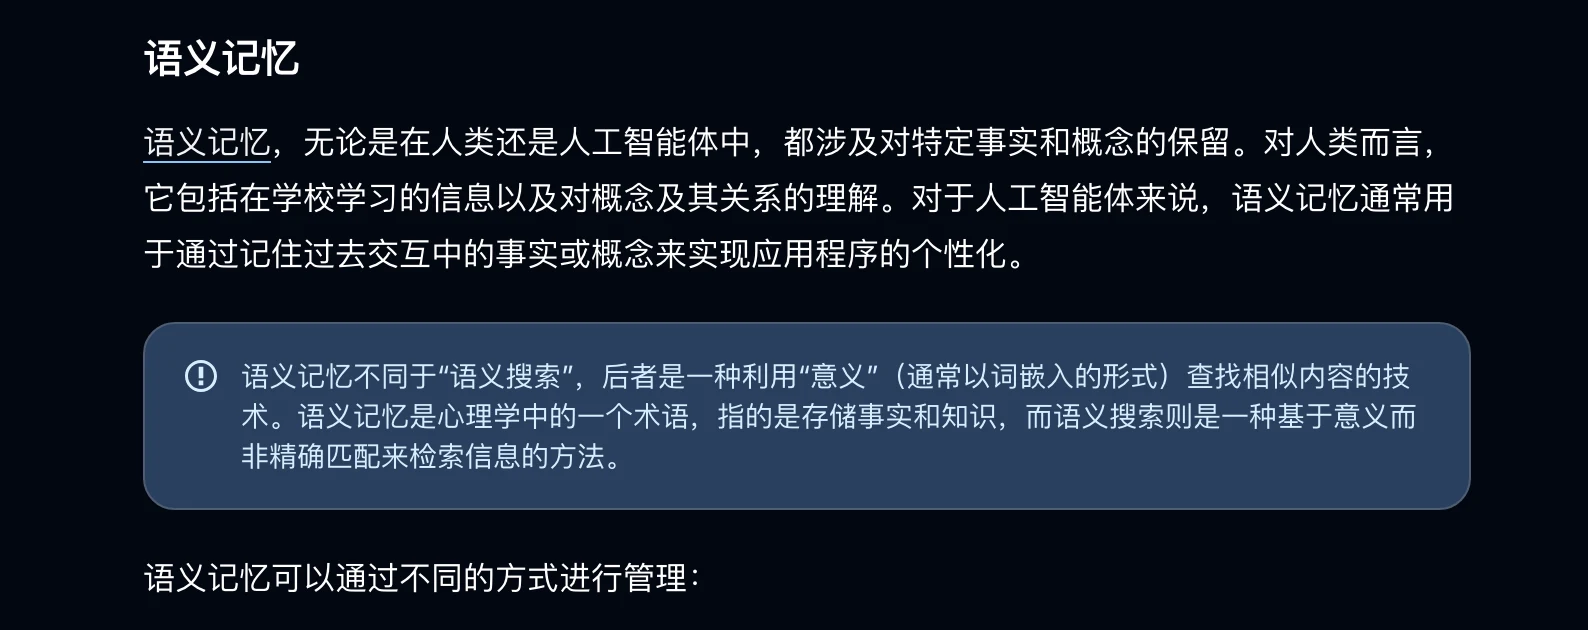
比如:
用户默认使用 Node.js
用户习惯使用 TypeScript
用户希望先看结论
这些信息描述的是“这个用户有什么事实和偏好”,所以都是语义记忆。
官方文档又给出了两种常见的组织方式:
Profile(轮廓):把用户信息整理成一份持续更新的画像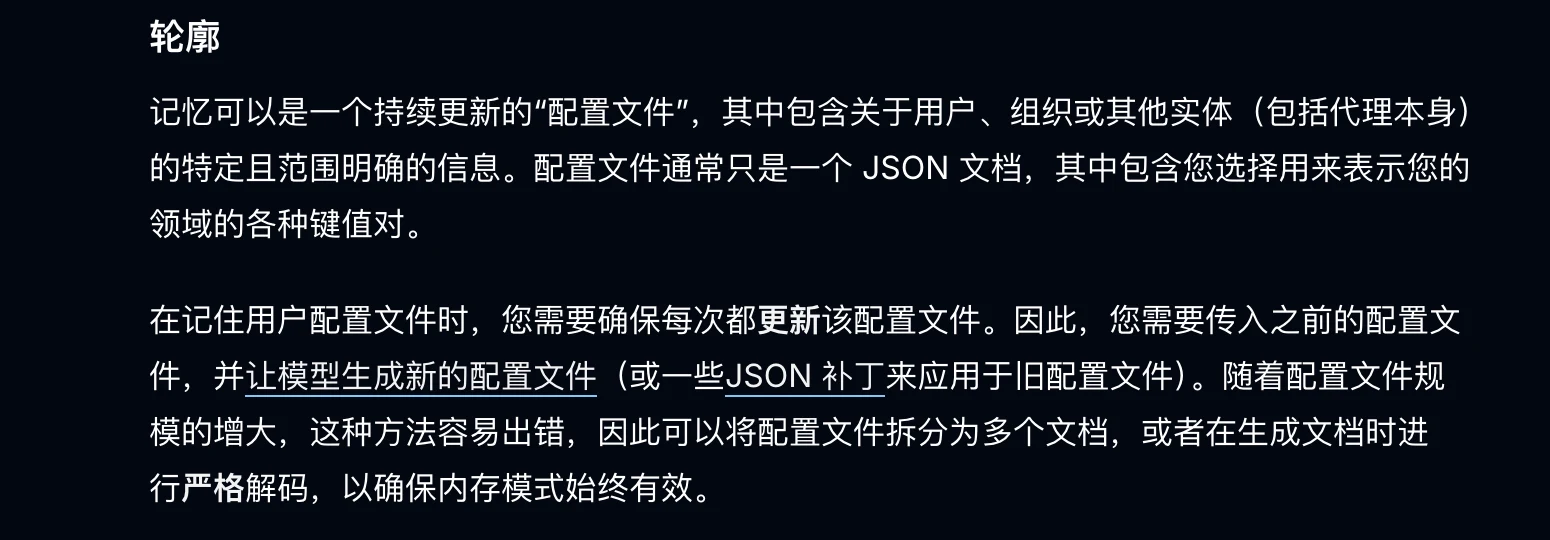
Collection(收藏):把不同信息拆成多条独立记忆,后续继续新增、更新或者删除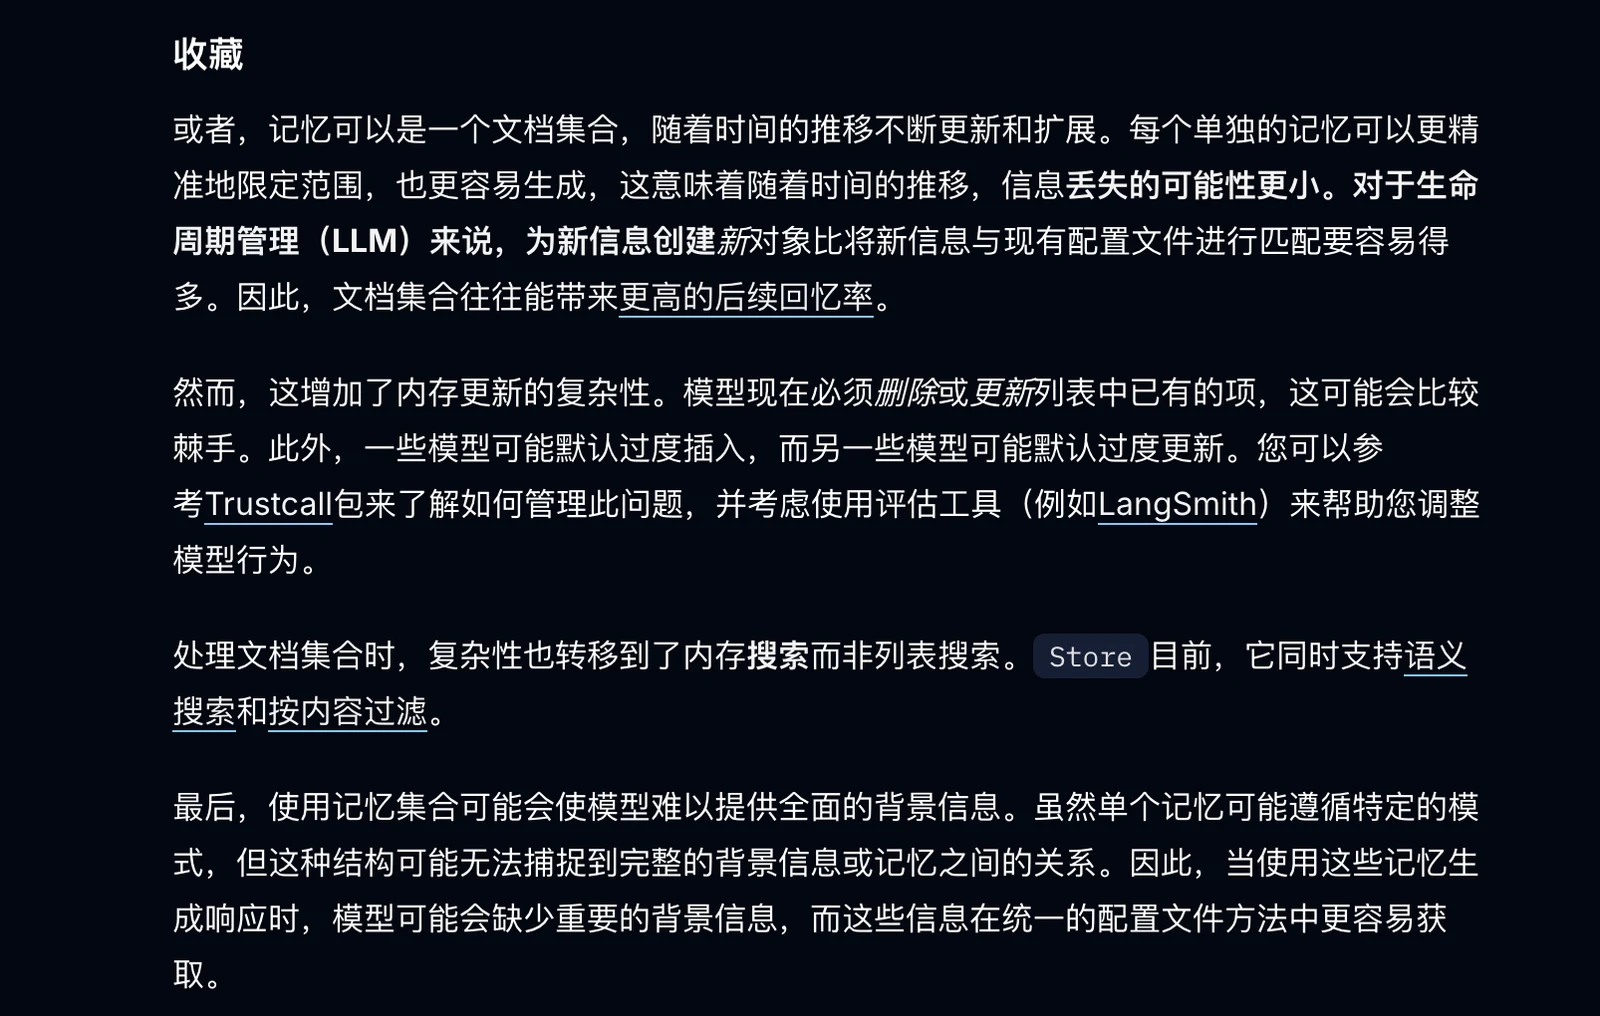
上一节中,咱们使用随机 UUID 保存每一条候选,其实就更接近 Collection(收藏) 的方式。
这种方式新增很方便,但是它也有对应的维护问题,那就是:当新的信息不断出现时,模型可能会过度新增,也可能错误更新已有内容。因此,应用程序需要继续处理已有记录的更新和删除。
咱们现在遇到的,正是这个问题。
新信息出现以后,到底应该怎么处理
现在再回到前面的三个输入:
1 - 以后默认使用 Node.js。
2 - 后面的例子还是用 nodejs 吧。
3 - 修改一下之前的偏好,以后默认使用 Python。
它们都在描述同一个 key ,我们把这个 key 叫做: preferred_runtime
因为是同一个 Kry,所以最终会找到同一条已有记忆。
接下来,程序需要比较新值和旧值。
- 如果还没有旧记录,就执行新增。
- 如果新旧值相同,就不需要再次写入。
本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

