
Agent 记忆召回:如何选择本次回答需要的信息?
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
上一小节,咱们解决了记忆的更新、过期和删除的问题
做到这里以后,Store 里面已经可以保存很多长期记忆了。
假设,当前用户的 Store 里保存了下面这些内容:
回答语言:中文
回答风格:先说结论
默认运行环境:Node.js
上次咖啡机退款时,缺少机器序列号照片
用户记得以前 5000 元以内可以自动退款
出差期间只能通过邮件联系,不过这条要求已经过期
模型曾经猜测:高级会员可以跳过人工审核
现在,用户继续问:
请按我以前的习惯,简单说说这次咖啡机退款需要人工审核吗,
准备材料时有什么要注意的?现在还是按以前的标准处理吗?
大家想一下。
回答这个问题,需要知道什么信息呀?
至少 “默认运行环境:Node.js” 这个不需要吧。
所以,记忆保存下来以后,还缺少一个非常重要的过程,那就是:
根据当前问题,从已经保存的记忆中找出真正需要的内容,排除不能使用的内容,再把结果加入本轮模型输入。
这就是这一小节要讲的 记忆召回。
记忆召回到底在做什么
Memory Recall,也就是记忆召回,可以先理解为:
Agent 应用根据当前任务,从长期记忆中读取候选内容,经过筛选以后,把本轮真正需要的记忆交给模型使用。
整个过程大致是这样的:
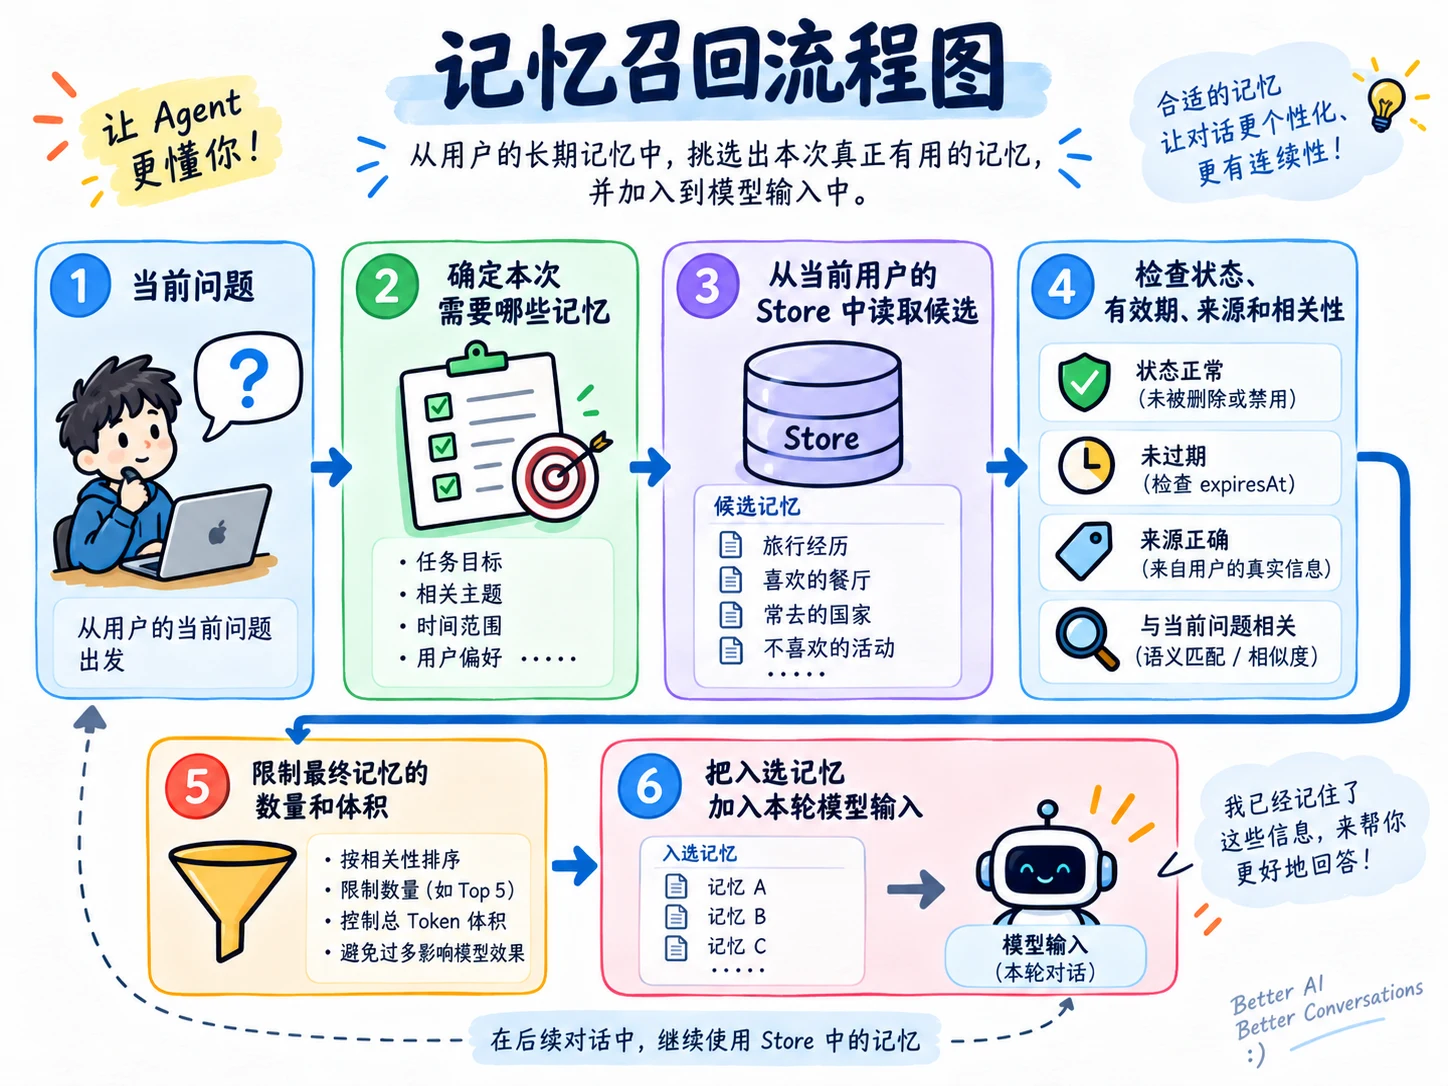
整个过程中,最核心的就是 **第三步 — 读取候选 **
我们知道,有些记忆的 Key 是确定的。
比如,Agent 每次回答都要知道用户的回答语言和表达风格,假设咱们已经知道要读取的字段就是:response_language(使用什么语言回答)
这种记忆就可以直接通过 store.get() 按 Key 读取。
但是,用户过去可能咨询过退款、发票、编程代码问题。应用提前并不知道当前问题与哪条历史记录有关,更不知道那条记录的 Key 是什么。
这种情况下,就可以使用 store.search(),根据当前问题搜索语义接近的历史记忆。
所以,本节会同时用到两种读取方式:
store.get():针对已经知道具体 Keystore.search():不知道具体 Key,只知道当前问题
而且,无论使用哪一种方法,找出来的内容都不能直接交给模型。
咱们还得继续判断:这条记忆是不是当前用户的、有没有过期、是否已经被修正 等等的
以上就是记忆召回的基本概念,应该还是比较简单的。
然后接下来,咱们就来看看代码
跑一次完整的记忆召回
本节代码在:
/Code/Node/第六章/07-memory-recall项目会使用智谱 embedding-3 搜索相关的历史记忆,因此需要在 .env 中配置:
ZHIPU_API_KEY=你的智谱 API Key
EMBEDDING_MODEL=embedding-本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

