
Agentic RAG:按需检索、多轮补查与证据判断
《Agent 大模型 0 到 1 系统课》 · 程序员 Sunday
你正在阅读本节的免费试读。完整课程 ¥499,可在文末添加作者微信购买。
上一小节,咱们实现了记忆召回。
Agent 可以根据当前问题,从长期记忆中找到需要召回的记忆内容。
看到这里大家想想,这个玩意是不是有点像咱们之前学过的 RAG 啊。
大家还记得 RAG 的定义是啥吗?
RAG 的全称是 Retrieval-Augmented Generation,也就是 检索增强生成。(忘记的同学,请回顾第二章内容~~)
简单来说就是:先根据用户问题,从外部知识库中找到相关资料,再把这些资料交给大模型生成答案。
比如,用户问:“退款金额超过多少元需要人工审核?”
RAG 会先从企业知识库中找到退款规则,再让模型根据规则回答。
这么看下来,记忆召回和 RAG 的处理方式确实很像哈:
- 记忆召回:根据当前问题,查找相关的用户记忆
- RAG:根据当前问题,查找相关的企业知识
它们都是先“找资料”,再把找到的内容交给模型。
但是,两者查询的数据不一样。
长期记忆保存的是 当前用户过去留下的信息,比如:用户偏好、历史经历和已经确认过的事实 等等的。
RAG 查询的则是 外部知识库中的资料,比如:退款规则、产品手册和企业制度 等等的。
咱们做个测试,大家觉得下面两个内容哪个属于 长期记忆,哪个属于知识库资料呢?
内容一:用户以前买过一台 3500 元的咖啡机
内容二:退款金额超过 2000 元需要人工审核
应该还挺好分辨的吧。
----------- 人工分割线 -----------
公布答案:其中内容一属于长期记忆,内容二属于企业知识库
那如果用户现在问:“我之前买的那台咖啡机,申请退款时需要人工审核吗?”
想要回答这个问题,Agent 就要同时完成两件事:
- 第一:从长期记忆中找到咖啡机订单和退款金额
- 第二:再从企业知识库中查询人工审核规则
这也是为什么学完记忆召回以后,咱们还要继续学习 Agentic RAG。
咱们在前面实现的 RAG 的时候,检索流程基本是程序提前写好的,大致就是下面这样:
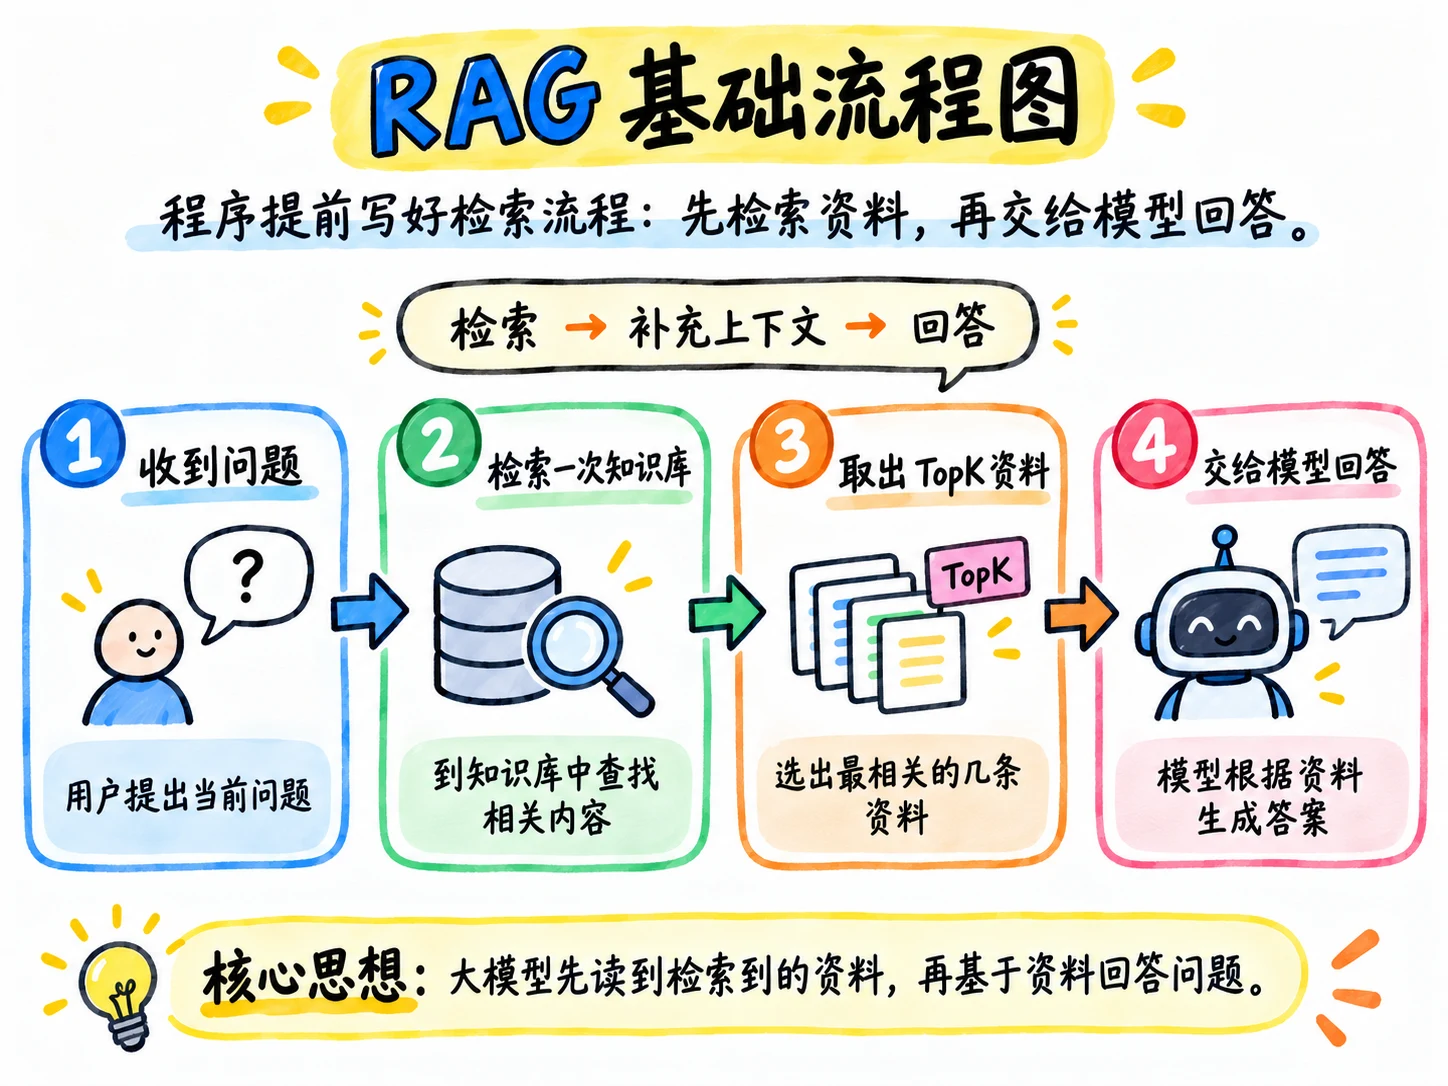
这样的流程处理目标明确的简单问题时,没有问题。
但是,实际开发中用户经常会把多个问题放在一句话里。比如:“订单 A2026 的咖啡机退款金额是 3500 元,需要人工审核吗?准备材料时还要注意什么?”
想要完整回答这个问题,至少需要两类资料:
- 退款金额对应的人工审核规则
- 咖啡机退款需要提交的材料
如果第一次只查到了人工审核规则,Agent 不能直接生成答案。
它还要知道:当前资料只能回答前半个问题,退款材料还没有找到,需要继续检索。
这就不再是简单的“检索一次,然后回答”了。
咱们需要让 Agent 根据当前问题和已经找到的资料,继续判断:这次需要查询知识库吗?应该查询哪类资料?当前资料够不够?不够的话,下一步还要查什么?始终查不到时,是追问用户还是拒绝回答?
你看,还挺复杂的吧
而这些事情,正好是 Agent 擅长解决的。
第四章和第五章已经讲过,Agent 不只是生成一次回答。它可以读取当前 State,选择 Action,观察执行结果,再决定下一步。
现在,咱们把 RAG 的检索能力交给 Agent,让“检索一次就回答”的固定流程,变成“检查证据、按需补查、资料齐全再回答”的执行过程。
而这个过程就是 Agentic RAG 。
所以我们可以简单理解 Agentic RAG 指的就是:利用 Agent 来辅助检索增强生成(RAG)的过程。
说得再直白一点:RAG 负责提供外部知识,Agent 负责决定怎样使用检索能力
到这里,咱们已经分别学过 RAG、Agent Loop、LangGraph 和记忆召回。
这一小节,就把这些知识连接起来,看看 Agent 怎样完成按需检索、多轮补查、证据判断和资料不足时的拒答。
Agentic RAG 的实际工作流程
上面已经通过实际问题看到了,Agentic RAG 解决的就是:固定的一次检索,不一定能够拿到回答复杂问题所需的全部证据 的问题
LangChain 官方的 Agentic RAG 介绍 里面给出了具体的执行流程,大致是三步:
- Agent 可以先判断是否需要调用检索能力
- 拿到资料以后判断是否相关
- 如果不相关,可以改写查询并重新检索
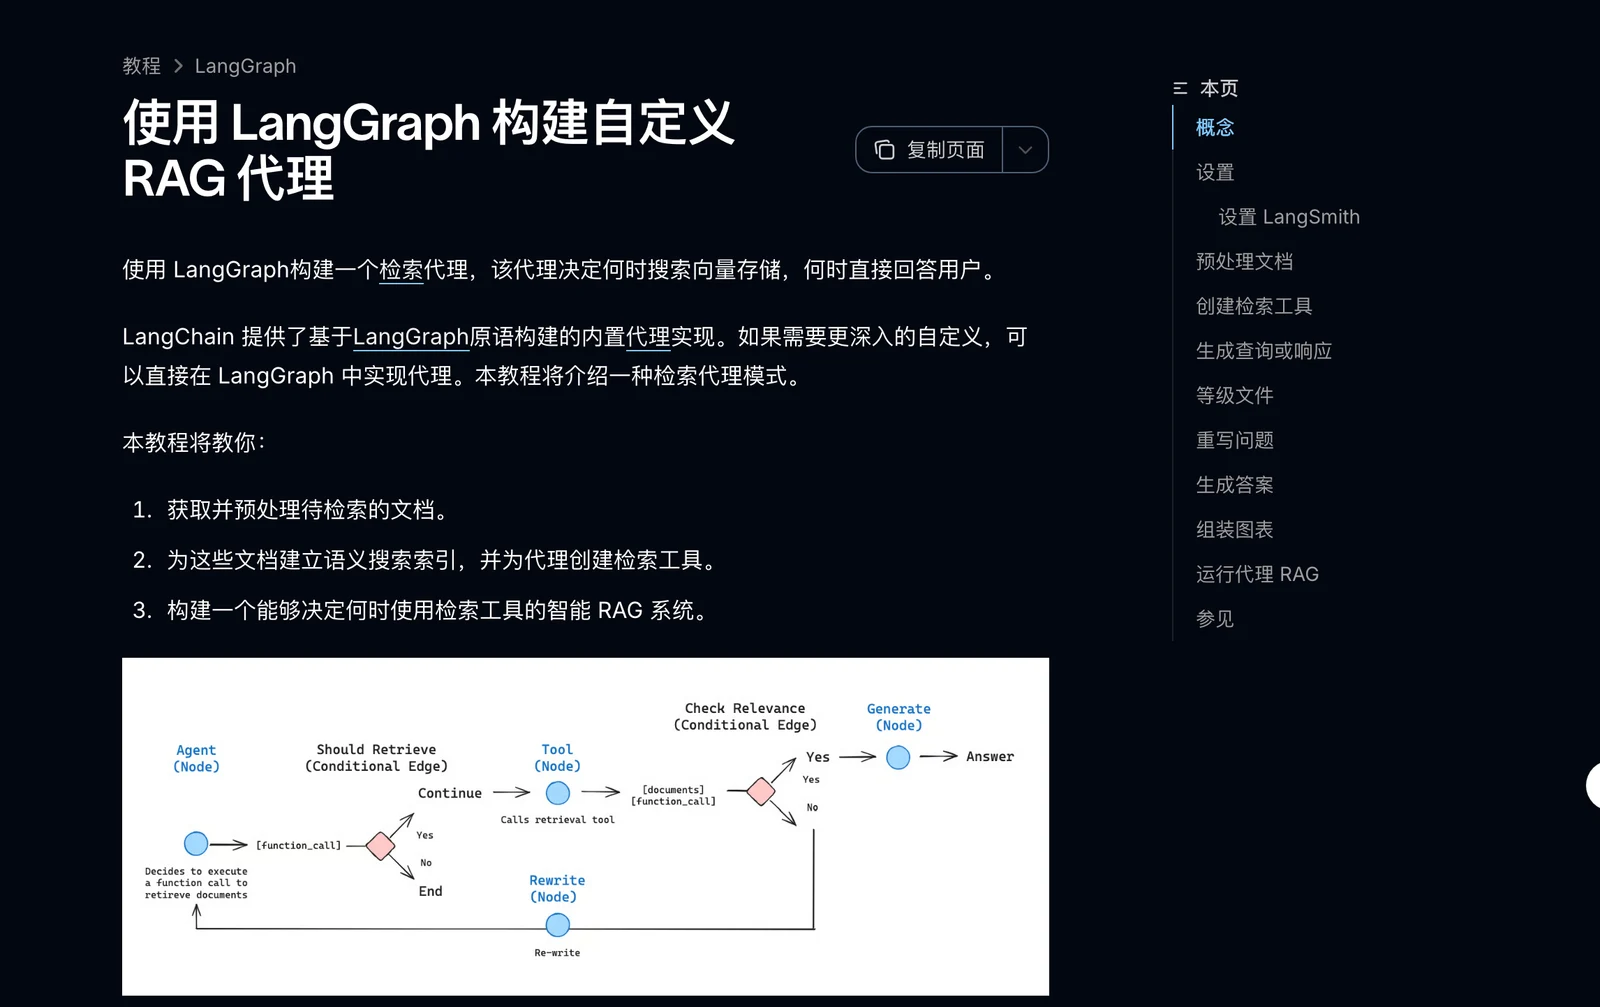
普通 RAG 和 Agentic RA
本节试读已结束
继续学习,解锁完整课程
购买《Agent 大模型 0 到 1 系统课》,
继续阅读本节剩余内容与后续课程。

