
MySQL 一条 SELECT 语句是怎么执行的?解析器、优化器、执行器分别做什么?
下面是一段模拟面试对话。
🧑💻 面试官:一条 SELECT 进入 MySQL 以后,会经过什么?
🙋♂️ 我:连接器、解析器、优化器、执行器,最后读取数据。
🧑💻 面试官:解析器知道哪个索引最快吗?执行器是不是一次把整张表都拿进来?
🙋♂️ 我:索引选择属于优化,执行方式要看计划。
🧑💻 面试官:EXPLAIN 估计只读十行,实际却等了很久。你怎么知道时间花在扫描、等待,还是别的阶段?
把各阶段的「输入和产物」讲出来,比背组件名称更有用:SQL 结构变成计划,计划再变成实际读取。
面试速答(60 秒版)
MySQL 收到 SELECT 后,需要完成连接与身份等处理,再解析 SQL,并在准备阶段检查表、列和相关语义。优化器根据查询条件、索引与统计等信息,选择执行计划。
执行器按照计划组织扫描、过滤、连接等操作,并通过存储引擎接口读取数据。以 InnoDB 为例,具体记录和数据页由引擎处理;读取可能命中缓冲池,不是每次都访问磁盘。SQL 执行说明。
因此,解析器主要理解查询,优化器决定执行方式,执行器负责实际执行。SQL 的逻辑处理顺序不能直接当作数据库的物理执行顺序。
排查性能时,EXPLAIN 先看计划,EXPLAIN ANALYZE 则会实际执行支持的语句并提供执行信息。还要考虑锁等待和其他阶段,不能看到使用索引就认定查询一定快。
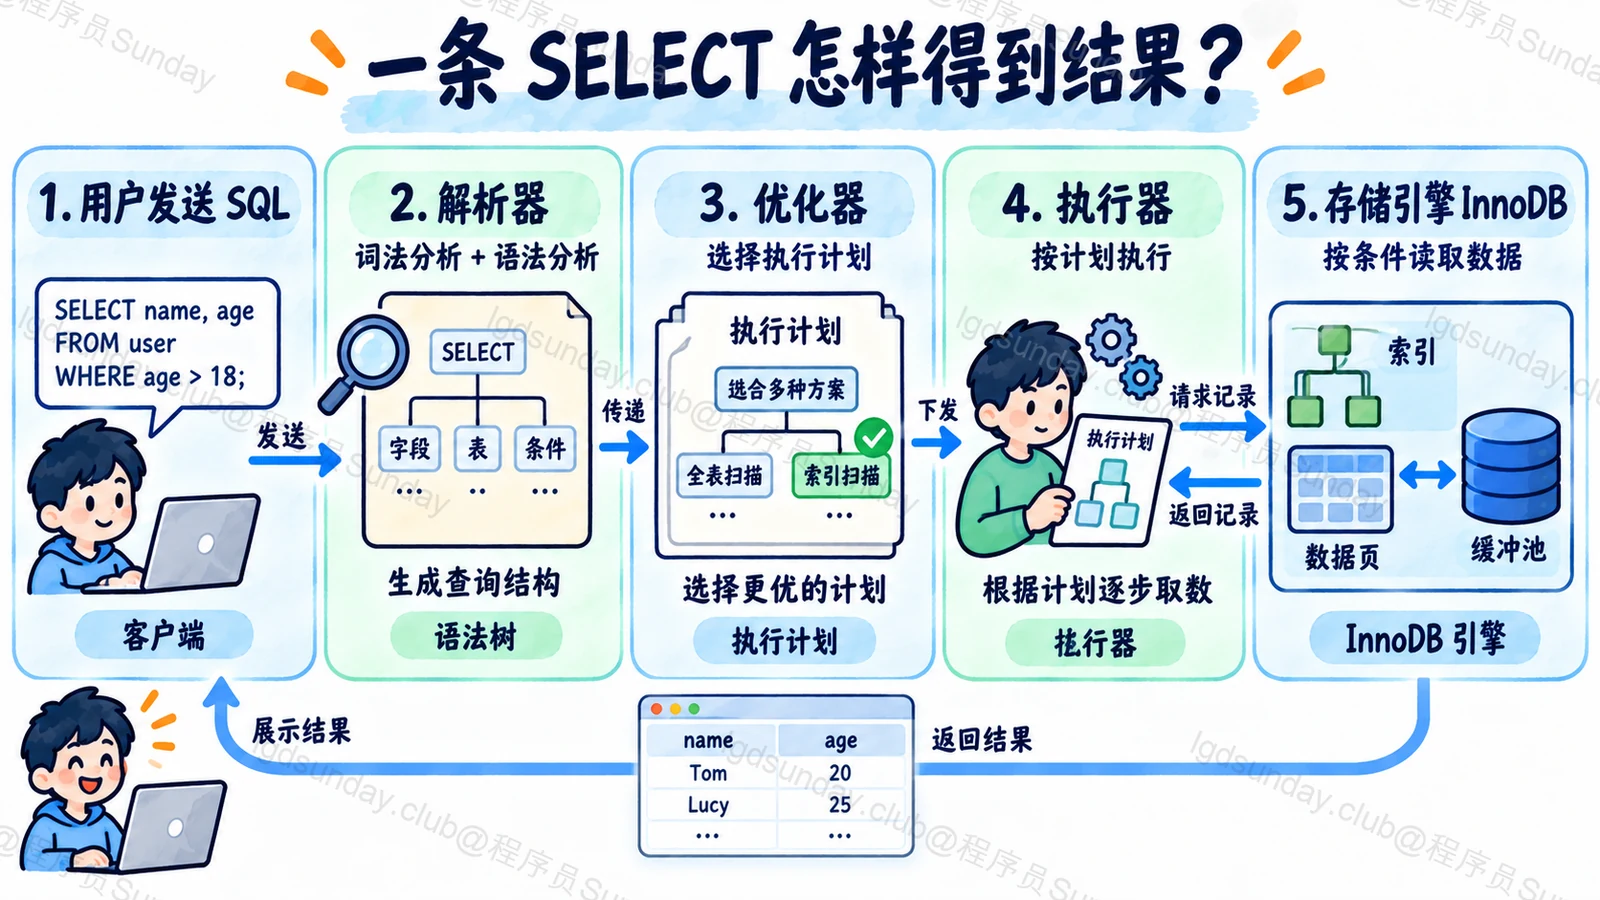
这张图先画出查询主干。连接、身份确认以及表和列的准备检查没有逐项展开;存储引擎返回的是记录,最终结果仍由执行器组织后交给客户端。
知识点详解:从 SQL 文本走到一批结果行
解析与准备,让查询可以被理解
假设查询某位用户最近十条记录。SQL 文本里包含表名、过滤条件、排序和 LIMIT。
解析过程先识别语法结构。准备工作还需要结合元数据解析表、列等引用,完成相应语义和权限检查。连接时确认身份,不代表之后所有对象访问都已经无条件批准。
这一阶段的产物是能够进一步处理的查询结构,不是“已经知道最快索引”的最终答案。语法错误、表不存在等问题,应按实际发生阶段理解。
优化器要比较不同的执行办法
同一个查询可能全表扫描,也可能使用 user_id 相关索引。如果存在适合过滤与排序的索引,还可能减少额外排序。
优化器结合条件、可选访问路径和统计估计成本,再形成计划。MySQL 8.4 查询优化。
这不是把 SQL 子句逐个照抄执行。例如过滤条件可以被提前处理,连接顺序可能调整,但最终结果必须保持相应语义。
统计信息是估计。数据分布与估计不一致时,选择的计划可能没有预期高效。计划合法与计划在当前数据上足够快,是两项不同判断。
执行器组织操作,引擎提供数据
选好计划以后,执行器安排扫描、过滤、连接、排序等操作。在 MySQL 8.4 中,可以从 TREE 等计划形式观察相应执行算子。
执行器向存储引擎请求数据。InnoDB 负责索引与记录访问,并按事务可见性等规则提供结果。Server 层不需要自行理解每个数据页的内部布局。
假设计划能按索引顺序找到某用户的最近记录,满足十条以后可能不必继续扫描全部数据。但若中间还有过滤,LIMIT 10 也不等于只检查十条记录。
结果返回同样可能按执行方式逐步进行,不必先把整张表装进应用内存,再交给用户。
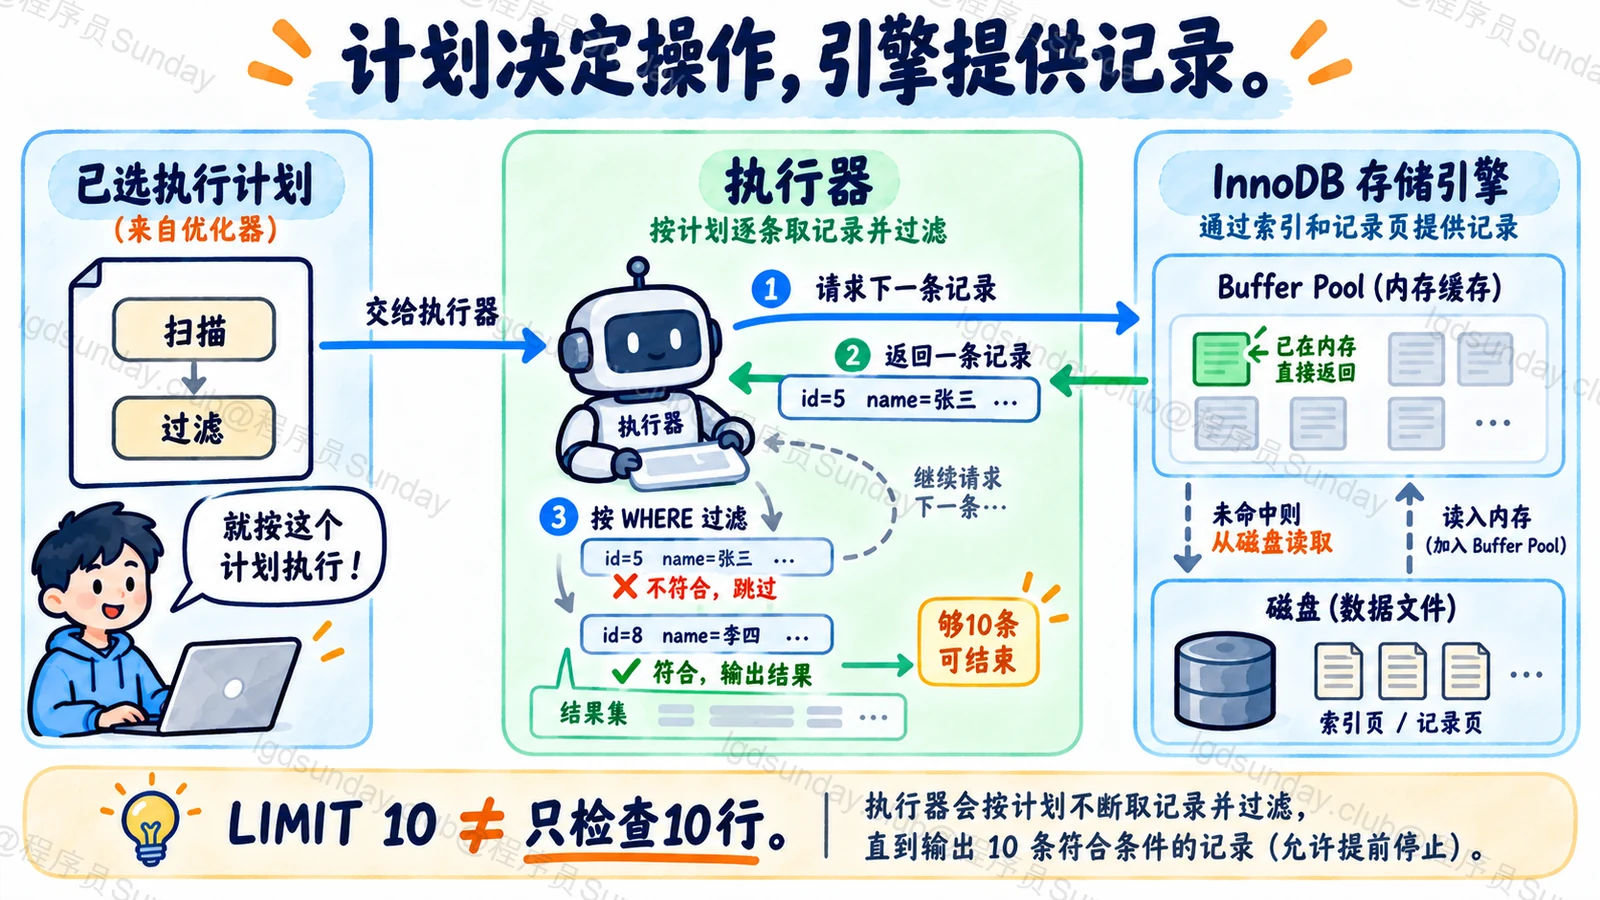
这里画的是允许提前结束的简单扫描、过滤计划。若还需要完成排序或其他操作,不能一找到十条匹配记录就直接停止。
不要沿用旧查询缓存图解
本文以 MySQL 8.4 的查询优化行为为主要范围。旧版本资料常画“先找 Query Cache,命中就直接返回”,不能原样搬到现代 MySQL。MySQL 8.0 已移除查询缓存相关配置。
同时,移除了旧 Query Cache,不代表没有其他缓存。InnoDB Buffer Pool 缓存数据页,两者缓存对象和一致性机制不同。
连接、语义检查、锁等待、数据扫描和网络返回都可能影响总耗时。把所有时间算在“执行器慢”上,会让排查范围过窄。
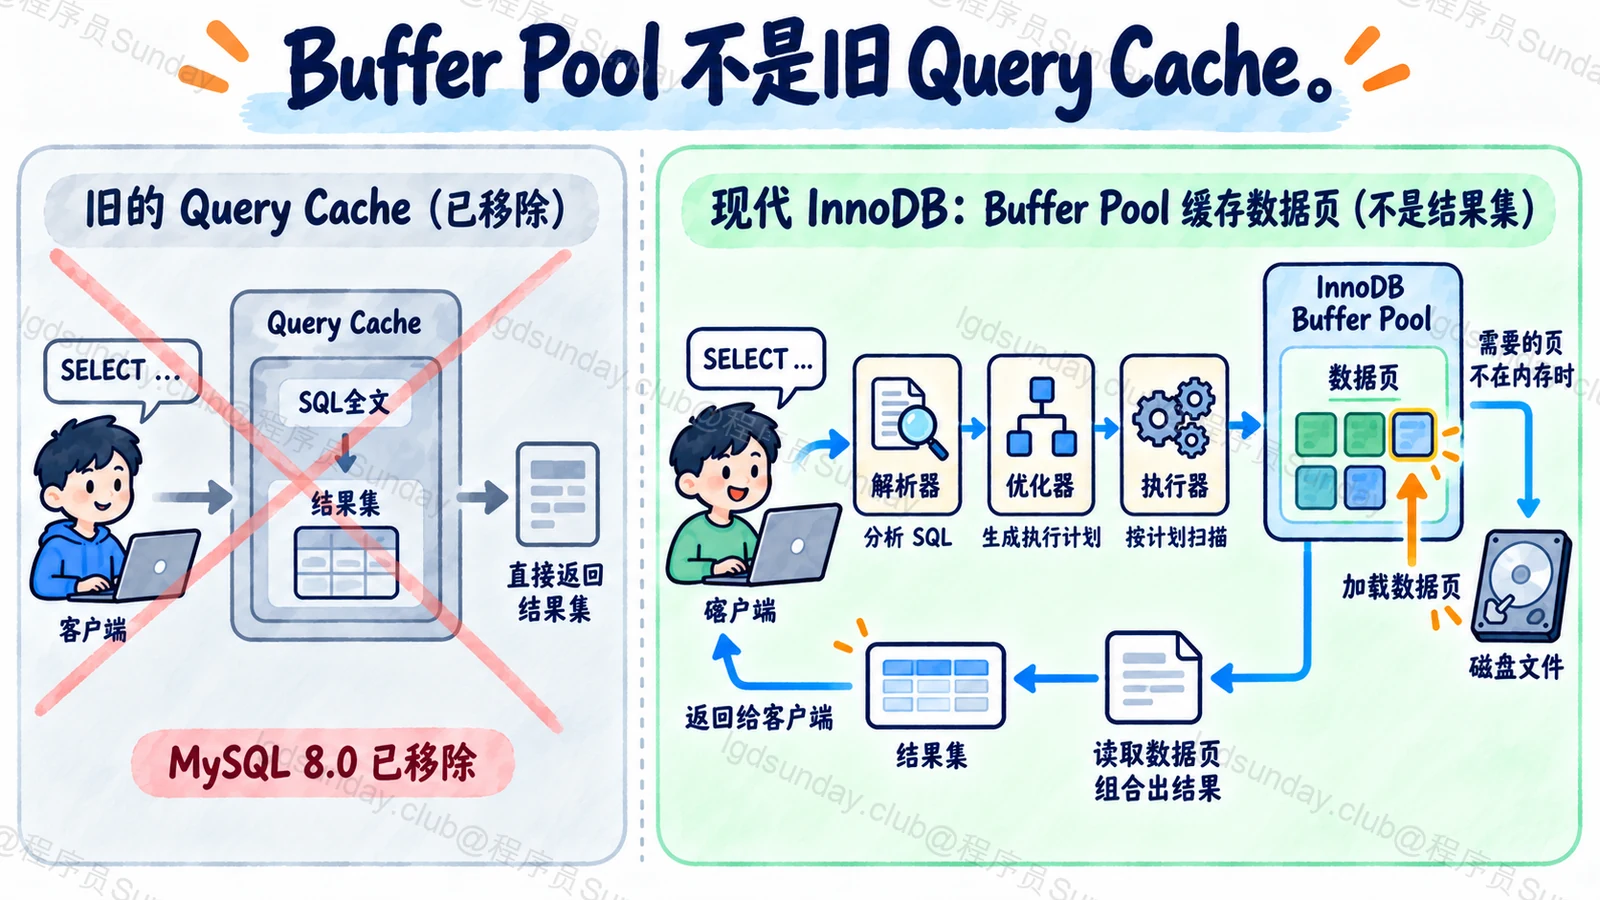
用计划与实际记录缩小问题范围
先用 EXPLAIN 看访问方式、估计行数和操作关系,再在可控条件下使用 EXPLAIN ANALYZE 获取实际执行信息。官方 EXPLAIN 文档。
ANALYZE 不是只读一份估计表:它会执行支持的语句,因此应先检查查询规模、环境和额外负载。
估计行数和实际行数差距大,可以继续检查统计与数据分布;计划合理但总体延迟高,还要查看等待和返回过程。本文未运行数据库,不提供伪造计划或测量数值。
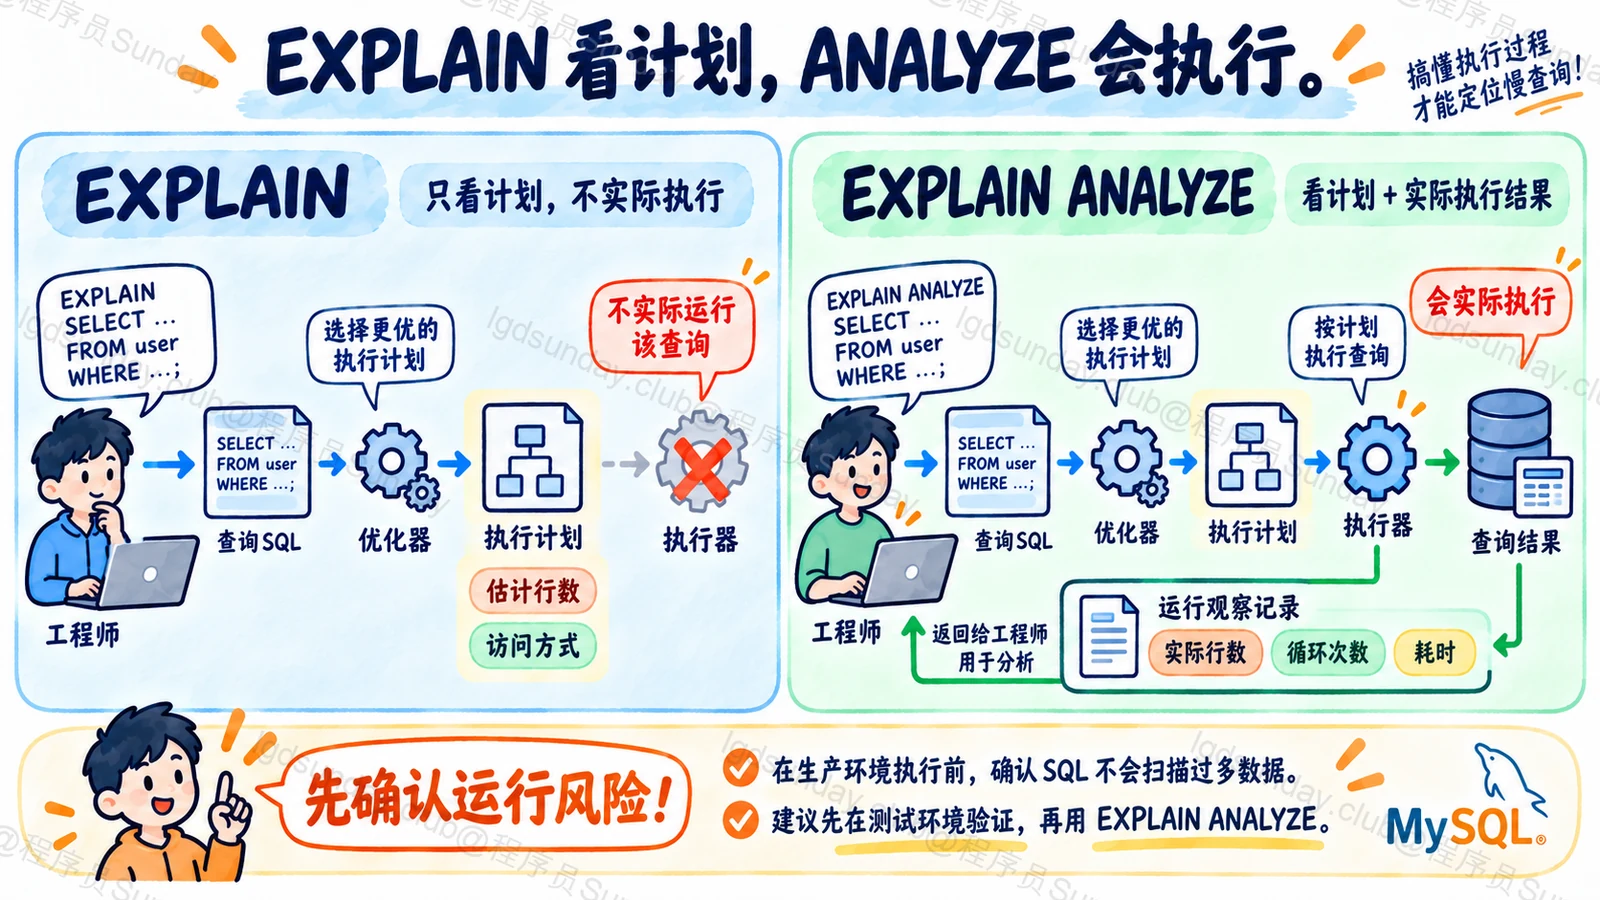
图中的“运行观察记录”指带实际执行信息的诊断计划,不是把原 SELECT 的业务结果表直接返回给工程师。
面试官继续追问
SELECT 的 FROM、WHERE、GROUP BY 顺序就是执行顺序吗?
这是理解结果语义的逻辑模型,不是所有物理算子的固定先后。优化器可以在保持语义的前提下转换查询。
有索引为什么还是慢?
可能匹配行太多、需要大量回表或排序,也可能主要时间花在等待。索引只是可用访问路径,不是性能结论。
准备语句是不是完全跳过解析与优化?
不能这样概括。预处理可以复用部分工作,但执行时仍受参数、元数据变化和具体机制影响。需要按所用版本与接口核对,不把“预编译”当作永久固定计划。
面试速记卡
- 解析与准备:理解 SQL,并结合元数据检查引用和语义。
- 优化器:根据条件、索引与统计选择计划。
- 执行器:组织算子,通过存储引擎读取数据。
- 存储引擎:负责具体记录、索引、数据页与可见性。
- 排查方法:区分估计与实际,也检查等待和结果返回。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 后端(广告部门) · 实习
在 MySQL 中,一条 SQL 的执行流程是什么?(题意整理)
【实习】字节后端一面(凉)、美团(offer)后端一二面面经 · 字节部分 ↗
字节一面记录为 2021-05-11;原帖编辑于 2021-05-31