
MySQL 的 InnoDB 和 MyISAM 有什么区别?为什么默认使用 InnoDB?
下面是一段教学用的模拟面试。
🧑💻 面试官:InnoDB 和 MyISAM 怎么选?
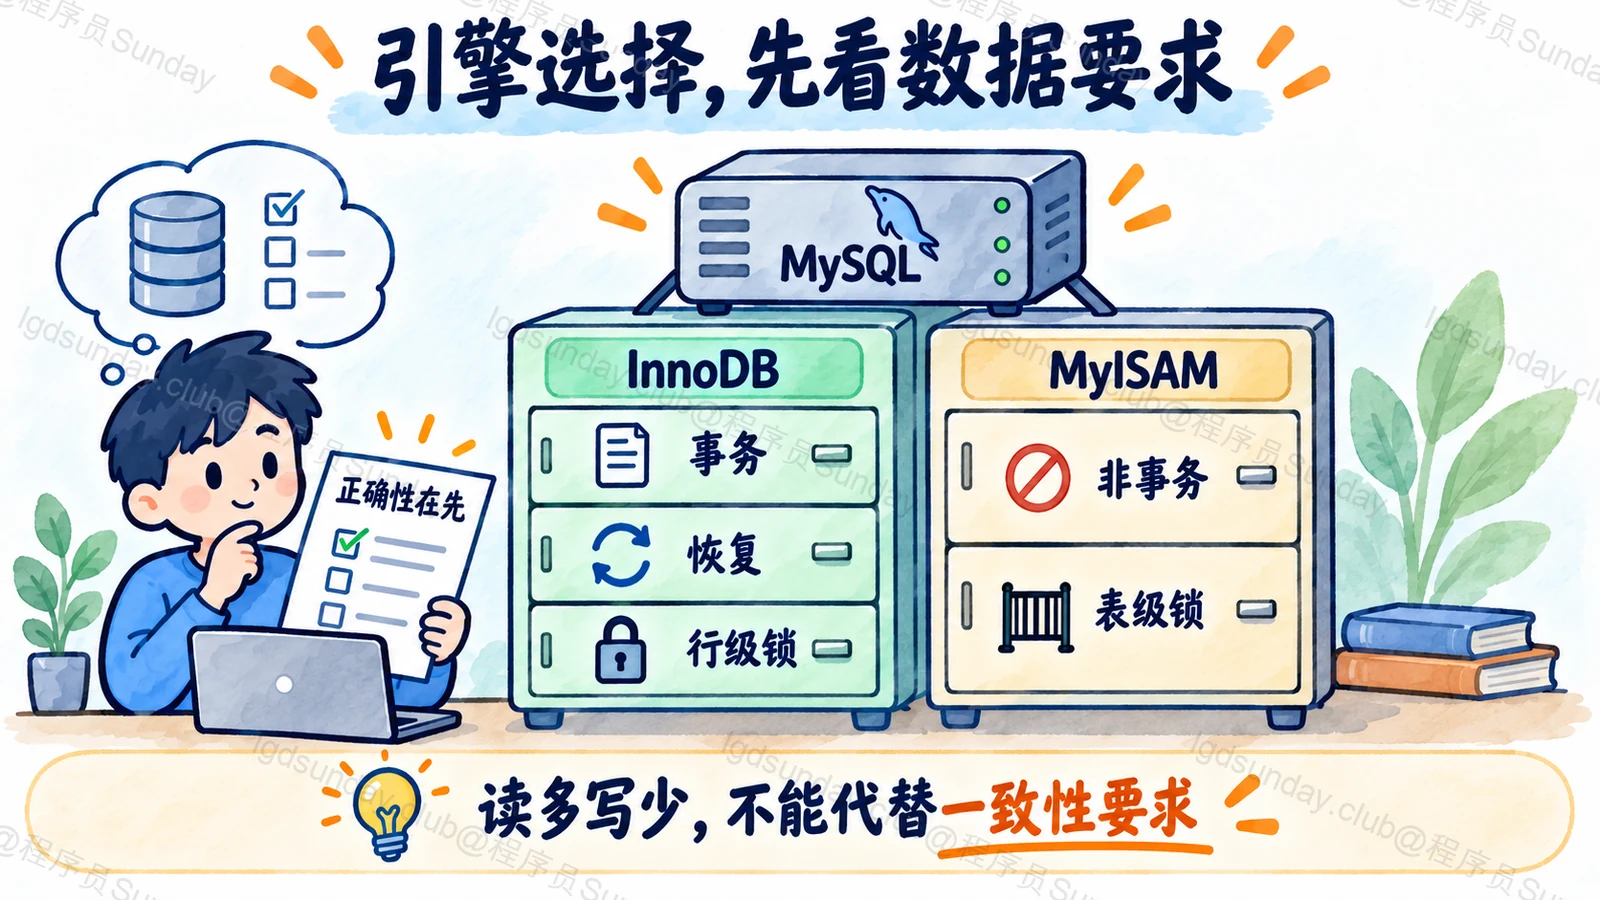
🙋♂️ 我:InnoDB 支持事务和行锁,MyISAM 不支持事务,使用表锁。读多选 MyISAM,写多选 InnoDB。
🧑💻 面试官:订单表每天大部分时间都在查询,你会因此改成 MyISAM 吗?扣库存成功,但插入订单失败,这两步怎么办?
🙋♂️ 我:读写比例不能代替一致性要求,订单和库存仍然需要事务。
🧑💻 面试官:那 InnoDB 的优势只剩一句“有事务”吗?服务突然断电时,两种引擎的恢复方式有什么区别?
先确认数据必须保证什么,再讨论查询性能。“读多写少”不足以替你选存储引擎。
面试速答(60 秒版)
InnoDB 和 MyISAM 都是 MySQL 的存储引擎,负责表数据与索引的具体组织和访问。当前 MySQL 的默认引擎是 InnoDB。
InnoDB 支持事务、崩溃恢复、外键和行级锁,结合多版本机制,适合需要一致性和并发访问的常见业务。MyISAM 不支持事务,主要采用表级锁,也没有 InnoDB 那样的事务崩溃恢复能力。
所以,新项目一般先使用 InnoDB,不能简单按“读多用 MyISAM,写多用 InnoDB”判断。只有明确了解某个历史系统或特殊需求,并用实际测试证明选择合理时,才讨论其他引擎;引擎能力、查询写法和索引设计也要分开看。
知识点详解:一次扣库存,为什么能看出引擎差别?
SQL 一样,不代表底下的存储方式一样
假设咱们有一张 product 表,保存商品和库存。应用发出 SELECT 或 UPDATE 后,MySQL 的服务器层还需要由存储引擎完成具体的读写。
所以,存储引擎不是 SQL 语法的另一种名字,也不是一个数据库服务器只能选一种。不同表可以采用不同引擎,只是使用前需要弄清各自能力。MySQL 存储引擎说明列出了默认引擎和主要能力。
对于普通业务表,先按 InnoDB 设计通常更直接。不要为了让面试回答显得“会选型”,刻意在没有需求依据时混用引擎。
两步操作,事务解决什么?
假设下单需要先扣库存,再写入订单。第一步成功、第二步失败时,咱们希望撤销本次扣减,而不是留下“库存少了,但没有订单”的状态。
InnoDB 可以把这些使用事务型表的操作放在同一个事务中,在约定的范围里提交或回滚。MyISAM 不支持这套事务语义,不能因为代码写了 BEGIN,就把对它的修改变成可回滚事务。
这也提醒咱们:事务是否覆盖所有操作,要看操作涉及的表和系统。把 InnoDB 表与 MyISAM 表混着更新,或者同时调用外部支付接口,不能想当然地认为一个数据库回滚就能撤销所有副作用。
因此,“读操作很多”并不会取消偶尔一次写操作对正确性的要求。订单、账户、库存等数据,不能只按查询数量决定引擎。
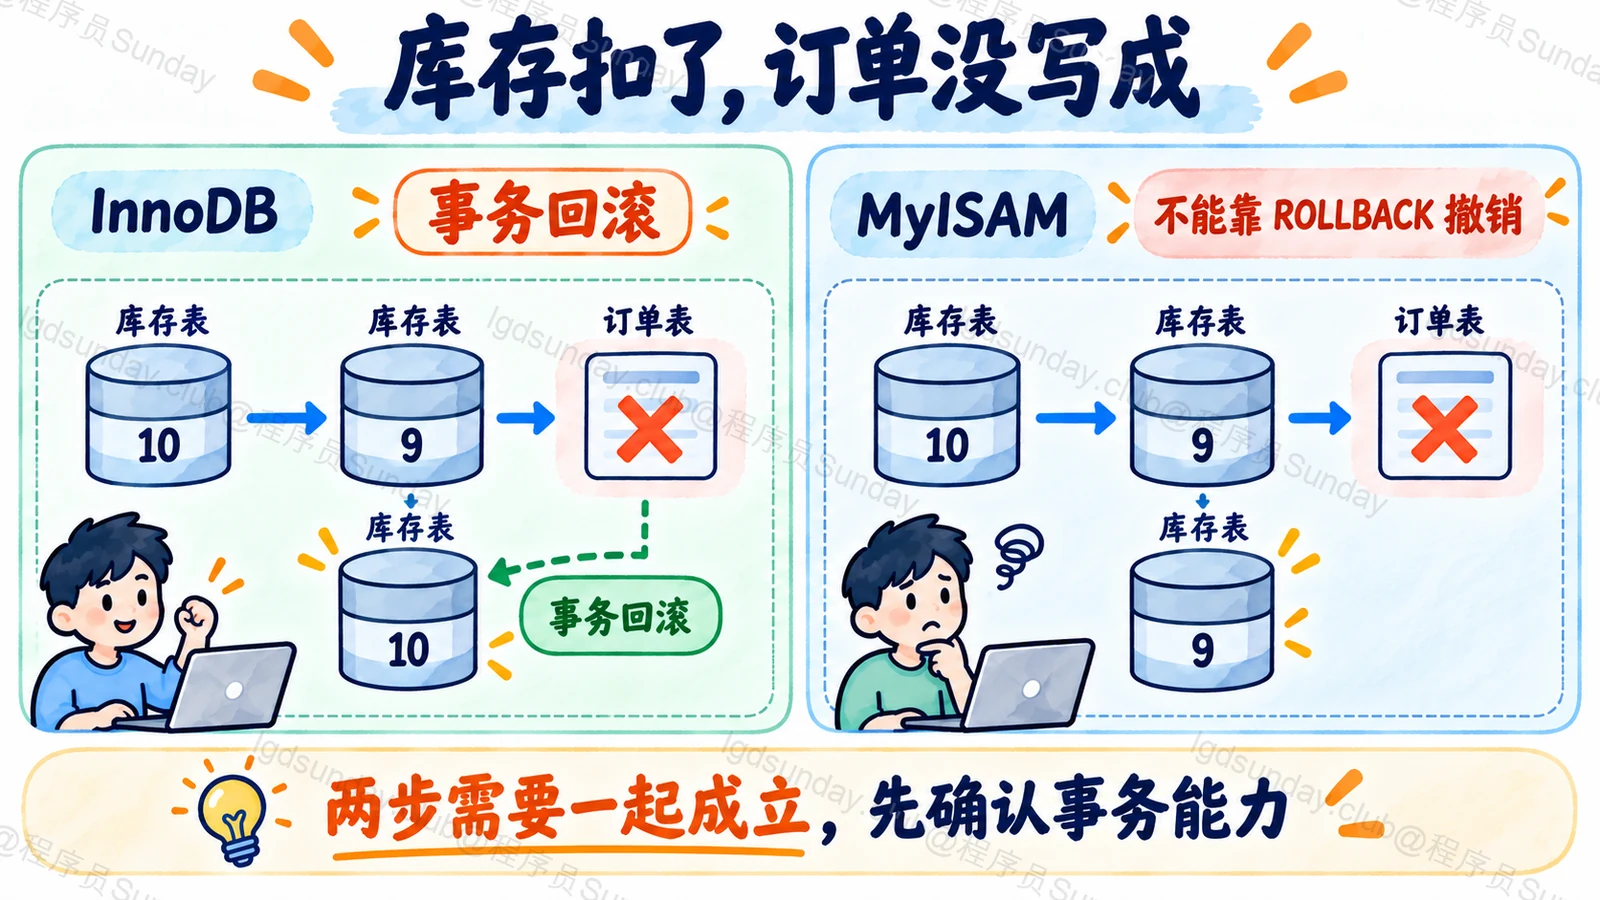
图中回滚指:两步都在同一 InnoDB 事务内,第二步失败后由应用回滚;不是任意语句报错都会自动撤销全部操作。
并发区别,不是“行锁永远没有阻塞”
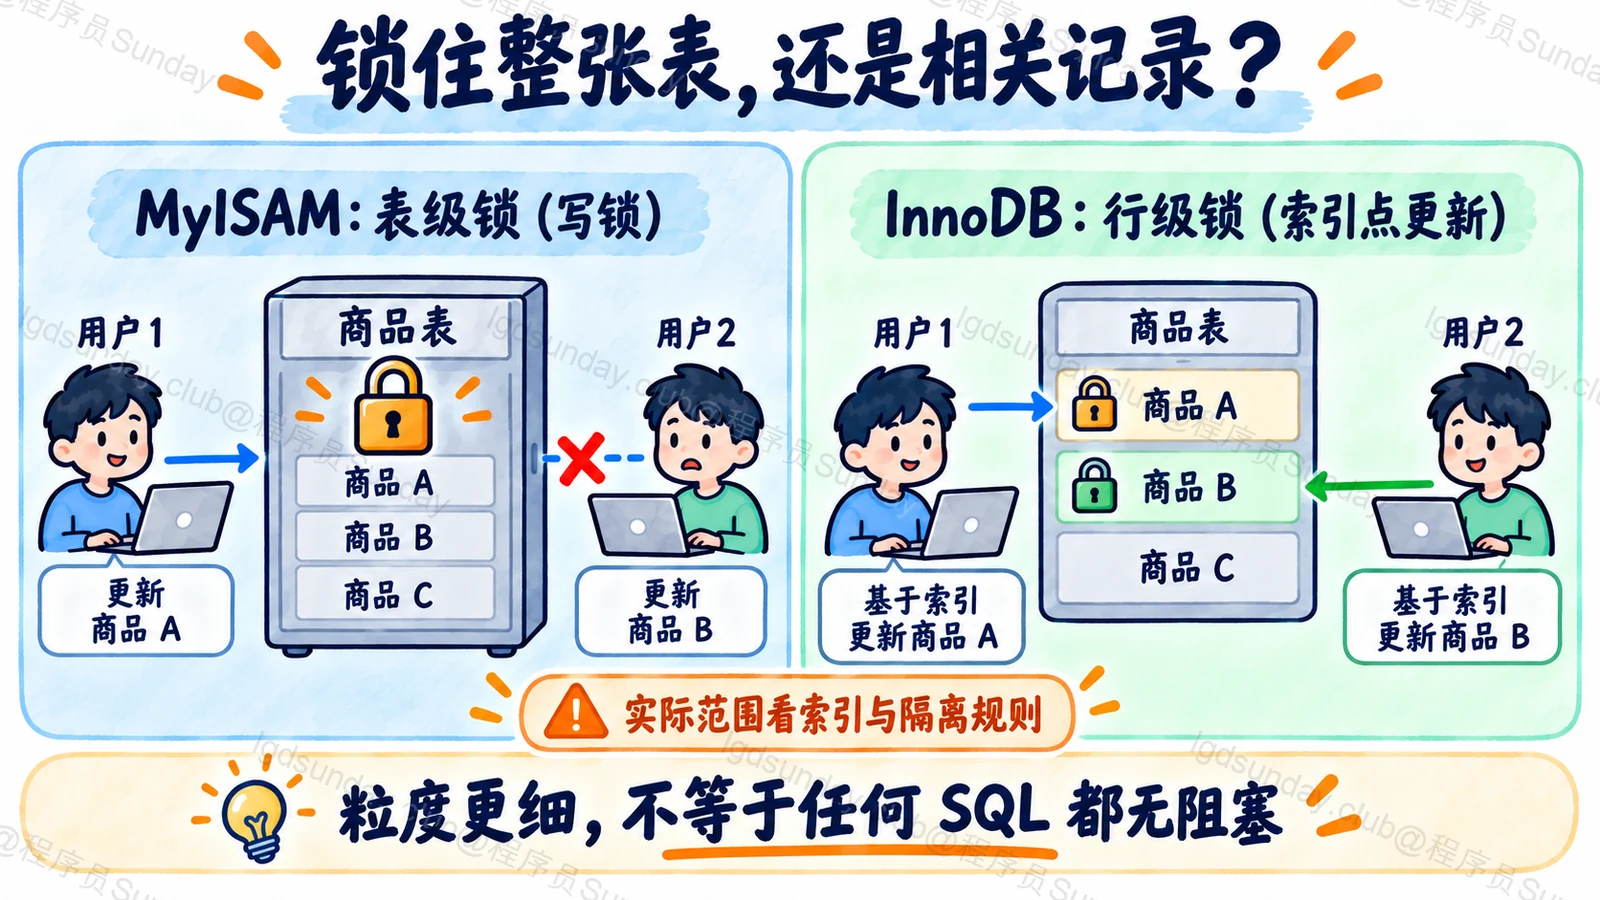
假设两个人分别修改不同商品。表级写锁会影响其他对同一张表的相关访问;行级锁则能够把冲突范围收得更细,让不同记录的操作有机会并发进行。
InnoDB 还通过多版本机制,让常见的一致性读取不必和所有写入互相排队。这是它适合一般并发业务的原因之一。
但 InnoDB 的实际锁范围和查询条件、索引、隔离级别有关。范围操作可能涉及间隙锁,缺少合适索引也可能锁住比预期更多的记录。不能看到“行级锁”,就保证任意两条 UPDATE 都不会互相等待。
已有索引、MVCC 与事务隔离题可以继续展开这些细节;本题的重点,是引擎提供了哪些基础能力,而不是把锁机制全部重新背一遍。
断电以后,恢复的目标是什么?
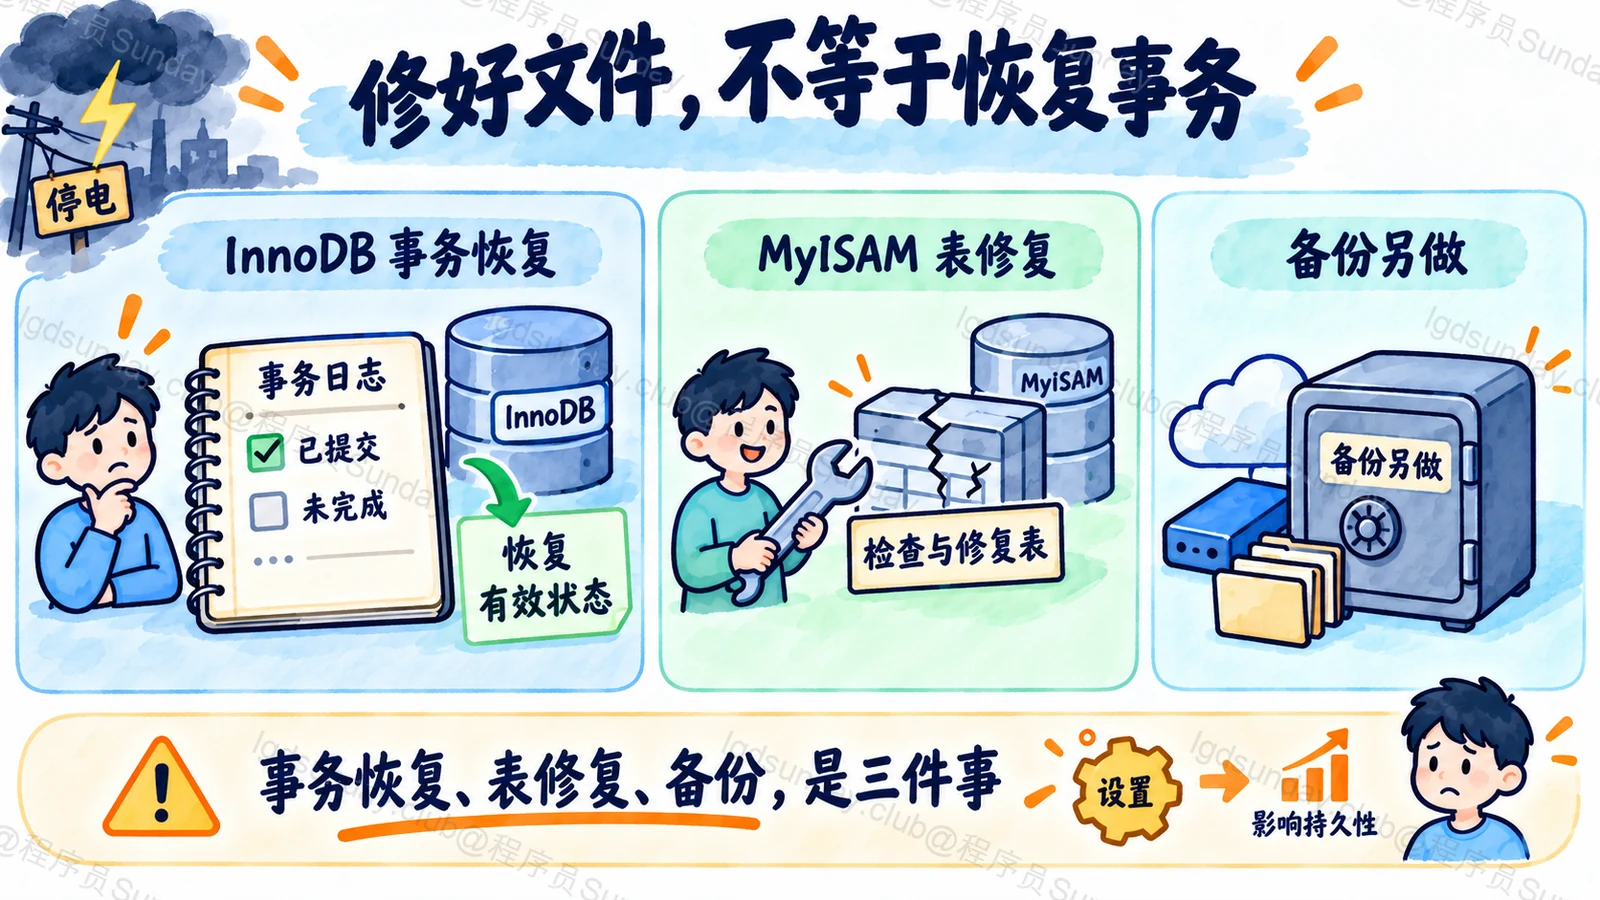
事务执行到一半时,数据页和日志未必处在相同进度。InnoDB 使用日志与恢复机制,在崩溃后处理已提交和未完成的事务,恢复到符合相应规则的状态。InnoDB 介绍把事务与恢复作为核心能力。
MyISAM 没有同等的事务崩溃恢复机制。异常停止以后,表可能需要检查或修复;“文件修复到能读”与“事务语义得到正确恢复”,是不同的目标。
不过,InnoDB 也不等于永远不丢数据。提交时日志刷盘设置、操作系统与硬件行为、复制和备份方案,都影响真实的持久性与故障恢复。
所以,不能用一句“支持 ACID”代替整个系统的数据安全设计,也不能把 crash recovery 当成备份。
面试里的几个老结论,需要加条件
| 对比 | InnoDB | MyISAM |
|---|---|---|
| 事务 | 支持 | 不支持 |
| 主要锁粒度 | 行级,并受查询与隔离规则影响 | 表级 |
| 外键约束 | 支持 | 不支持相同的约束能力 |
| 全文索引 | 支持 | 支持 |
| 无 WHERE 的精确 COUNT(*) | 通常需要访问相应索引记录 | 可利用保存的整表行数 |
“只有 MyISAM 支持全文索引”是过时说法。COUNT(*) 的特例也不能推导成“所有查询都更快”;一旦加条件,已经不是直接读取整表行数的问题。
真的有历史 MyISAM 表需要迁移时,应检查容量、转换耗时、索引、并发访问及结果一致性,并安排备份和验证。不要把修改引擎当成一句不影响生产的配置变更。
面试官继续追问
用 InnoDB,就不用设计索引了吗?
仍然需要。引擎提供能力,但不替你把低效查询变成高效查询。索引、访问路径和锁范围还要结合 SQL 检查。
MyISAM 的读性能一定更好吗?
不一定。数据规模、缓存、索引、并发写入和查询方式都会影响结果。必须针对具体负载比较,不能从一个 COUNT(*) 特例推到整个系统。
外键为什么也需要讨论?
它决定数据库是否替你执行某些关联约束。业务也可以采用其他一致性方案,但那是主动承担相应责任,不是两种引擎在约束能力上没有区别。
面试速记卡
- 存储引擎:决定表数据、索引和具体访问能力,不是另一套 SQL。
- InnoDB:事务、恢复、行级锁与外键,是普通新业务的常见默认选择。
- MyISAM:不支持事务,主要使用表级锁,历史用途要按实际条件判断。
- 选型:正确性要求在先,不用读写比例代替一致性判断。
- 边界:行锁不保证无阻塞,崩溃恢复不代替备份,性能需要实际验证。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
京东 · Java后台 · 校招
InnoDB 和 MyISAM 有什么区别?(题意整理)
京东 Java 后台三面凉经 ↗
原帖编辑于 2019-08-23(历史校招面经)