
MySQL 的 COUNT(*)、COUNT(1)、COUNT(字段) 有什么区别?
🧑💻 面试官:COUNT(*)、COUNT(1)、COUNT(字段),哪个最快?
🙋♂️ 我:COUNT(1) 不读取整行,所以最快。
🧑💻 面试官:COUNT(*) 真会把所有列的值都取出来吗?
🙋♂️ 我:那它应该只是计数。
🧑💻 面试官:如果字段里有 NULL,结果还一样吗?先别比速度,你准备统计什么?
先定义计数对象:数行,还是数某个表达式的非 NULL 值。对象不一样,讨论“哪个更快”就已经跑题了。
面试速答(60 秒版)
COUNT() 数查询结果的行数,不管这一行里有没有 NULL。COUNT(1) 对每行的非空常量 1 计数,因此结果和 COUNT() 一样;在 InnoDB 中,不应宣称它天然更快。
COUNT(字段) 数的是这个字段非 NULL 的行。如果字段有空值,它和数全部行就不是同一个问题。COUNT(DISTINCT 字段) 还会去重,并排除 NULL。
InnoDB 不能用一个全局精确行数回答所有事务,因为不同事务可见的数据可能不同。全表精确计数仍需要访问相应记录或索引。
优化时要看过滤条件、索引、可见性和统计频率。允许近似就用近似统计;需要精确业务数,则单独设计计数的一致性,不能靠换一个 COUNT 写法解决。
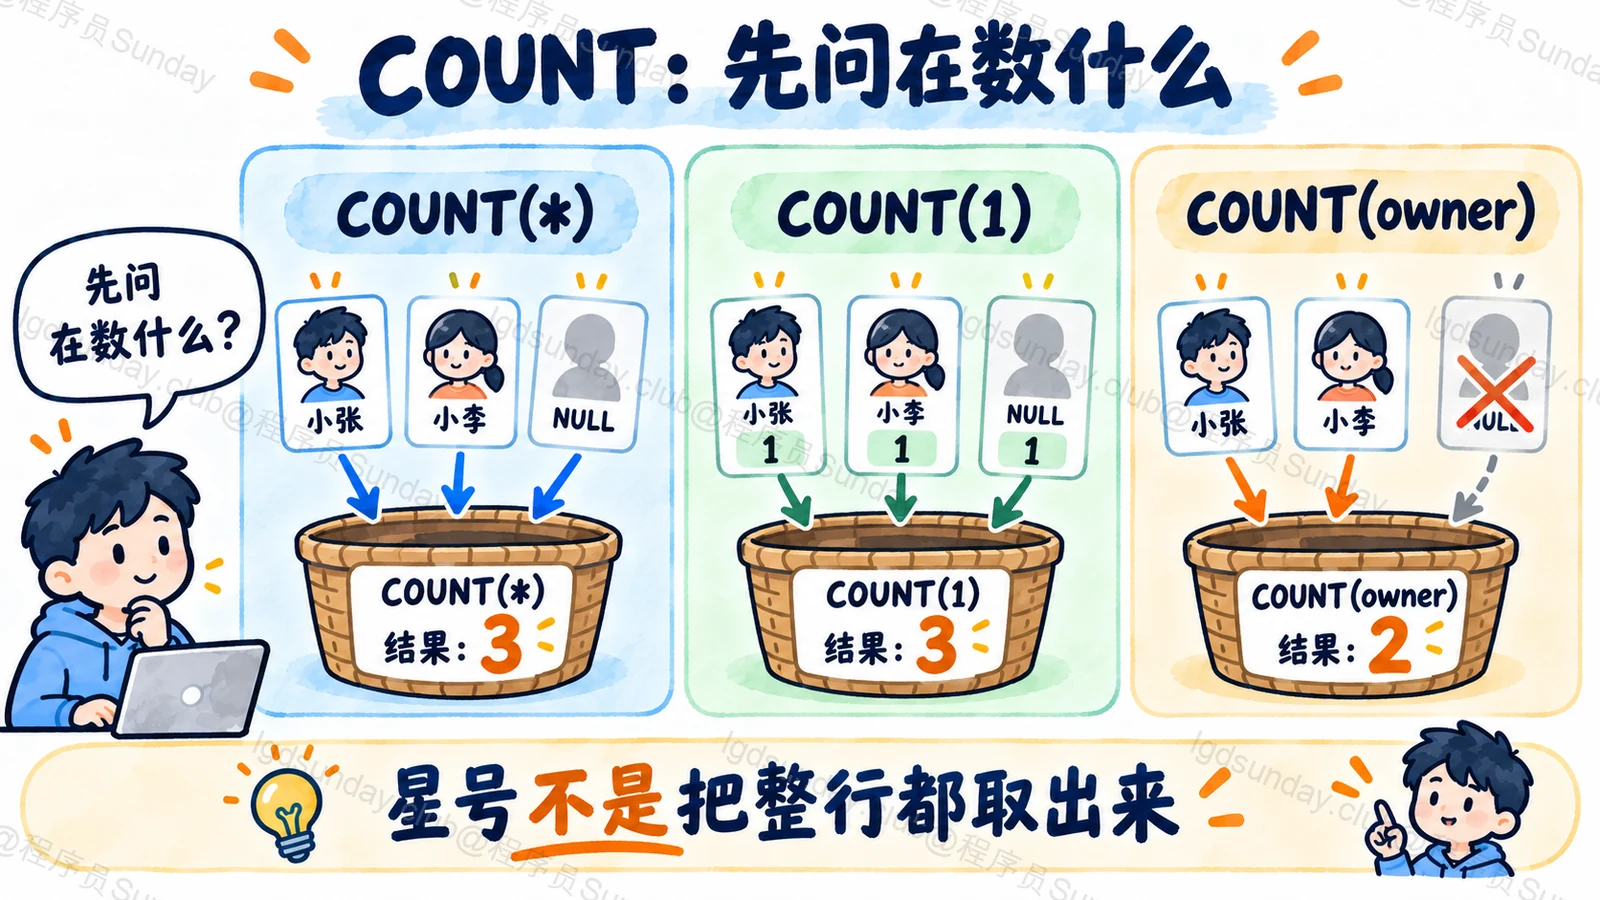
知识点详解:计数函数先决定“这一项算不算”
三条数据,足够看清差别
假设任务表有三条记录,负责人分别是小张、小李、NULL。对于这三条结果:
| 写法 | 结果 | 数的是什么 |
|---|---|---|
| COUNT(*) | 3 | 三行 |
| COUNT(1) | 3 | 每行一个非 NULL 的常量 |
| COUNT(owner) | 2 | 两个非 NULL 负责人 |
| COUNT(NULL) | 0 | 没有非 NULL 项 |
空字符串不是 NULL。如果字段值是空字符串,它仍然会被 COUNT(字段) 计入。先明确缺失值怎么保存,计数才有业务意义。
星号不等于读取整行所有列
SELECT * 取多列,COUNT(*) 的星号不是同样的操作。后者表达的是行计数,并不要求把所有列的值输出或逐个拼成完整结果。
对于常规 InnoDB 计数,官方说明 COUNT(*) 和 COUNT(1) 处理方式相同,不存在靠把星号换成 1 就天然加速的结论。
如果测试出来某次差一点,还要排除缓存、并发、执行计划和测量波动,不能把一次耗时写成通用性能排名。
事务不同,看到的总数可能不同
例如事务 A 已经建立一个一致性读视图,随后事务 B 新增并提交一条任务。A 在它的读取规则下,可能继续看到原来的数量;新事务则能看到新增记录。
因此 InnoDB 没法维护一个精确全局数,让所有事务都不检查可见性就得到正确答案。无过滤的 COUNT(*) 通常选择较小的二级索引扫描,没有二级索引则需要扫描聚簇索引;具体查询仍以计划为准。
加 WHERE 后,还要把筛选范围和索引匹配考虑进去。计数不是免费的元数据查询。
LEFT JOIN 后,COUNT(*) 还可能多算
想统计每位用户的登录次数时,没有登录的用户也会被 LEFT JOIN 补出一行。COUNT(*) 会数这行,于是零次被算成一次。
计数右表的非空登录主键,才会在这份 NULL 补行上得到零。这里不是“字段计数更快”,而是字段计数符合目标。
频繁统计大表时,可以讨论缓存、异步聚合或事务内计数器。但每种方案都有更新时间、热点竞争和修复成本,先说明允许误差,才好选择。
本题机制参考:聚合函数、一致性非锁定读、EXPLAIN 输出。
面试官继续追问
COUNT(DISTINCT owner) 会数 NULL 吗?
不会,单表达式时统计不同的非 NULL 值。两条相同负责人只计一次。
统计总数一定要扫表吗?
精确 InnoDB 计数需要处理当前事务可见记录,但可以利用索引,不等于总是读取整行。MyISAM 的特定元数据优化不能套到 InnoDB。
表状态里的 Rows 能直接用吗?
可以用于允许误差的估计场景,不能当作任意条件和事务视图下的精确业务总数。
面试速记卡
- COUNT(*):数结果行,包含有 NULL 的行。
- COUNT(1):非空常量计数,不天然比星号快。
- COUNT(列):数非 NULL 值,空字符串仍计数。
- DISTINCT:去重后计数,不计 NULL。
- InnoDB:精确计数受事务可见性与访问量影响。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →