
Redis 和 Memcached 有什么区别?纯缓存场景应该怎么选?
以下对话为教学模拟,不是真实面经。
🧑💻 面试官:Redis 和 Memcached 怎么选?
🙋♂️ 我:Redis 功能更多,所以肯定选 Redis。
🧑💻 面试官:如果只需要临时缓存一段序列化数据呢?功能更多会自动让缓存命中率更高吗?
缓存选型先明确需要什么语义,再比较相同条件下的成本。
面试速答(60 秒版)
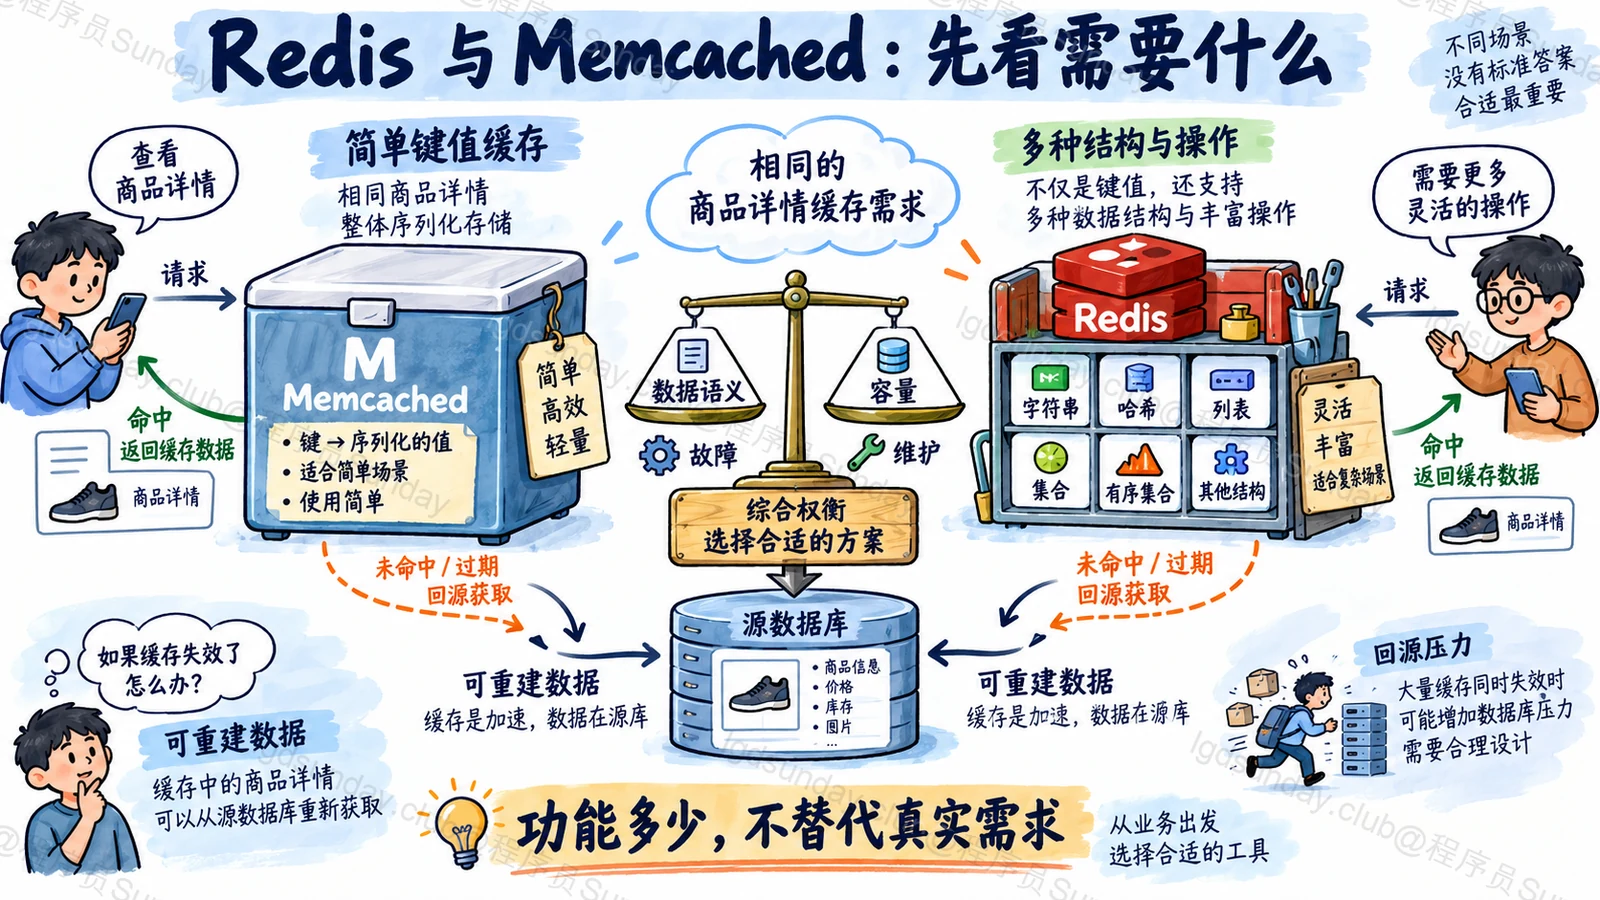
Redis 提供多种数据结构和相关操作,也有持久化、复制等能力。Memcached 更聚焦简单的键值缓存,常见用法是存放可以重新获得的临时数据。
如果需要计数、集合、排序或对数据结构进行操作,Redis 的能力更适合。如果只是缓存序列化结果,Memcached 也值得比较,不能因为功能少就认为不适合生产。
选型还要看缓存是否允许丢失、容量和淘汰策略、并发方式、运维与客户端支持。两者都不会自动解决缓存一致性和源系统过载。
所以,我会用相同对象、有效期和故障条件验证,而不是只比较功能清单或引用一份不说明条件的性能数字。
知识点详解:先判断缓存保存的是结果,还是可操作的数据
简单结果缓存,不一定需要复杂结构
咱们假设商品详情由数据库查询和业务拼装获得,缓存里只保存序列化后的结果。读取时整段拿出来,更新时整段替换。
这种需求主要关注键、值、有效期和容量。Memcached 的核心模型比较贴近这种使用方式。Memcached 用户指南说明了常见键值操作与缓存使用原则。
如果缓存里保存的是排行榜、计数器或需要局部修改的结构,Redis 的数据类型和操作接口可能减少应用工作。这里的价值是具体操作语义,不是“数据结构越多,缓存越好”。
可重建数据,和系统唯一数据必须分开
Memcached 通常用于可丢失、能够从源系统重建的缓存。Redis 可以配置持久化和复制,但配置这些能力,也不等于永不丢失。
Redis 的持久化说明列出了不同方式与取舍。是否把 Redis 当成某项数据的主要存储,应依据实际可靠性设计,而不能只因为它支持落盘。
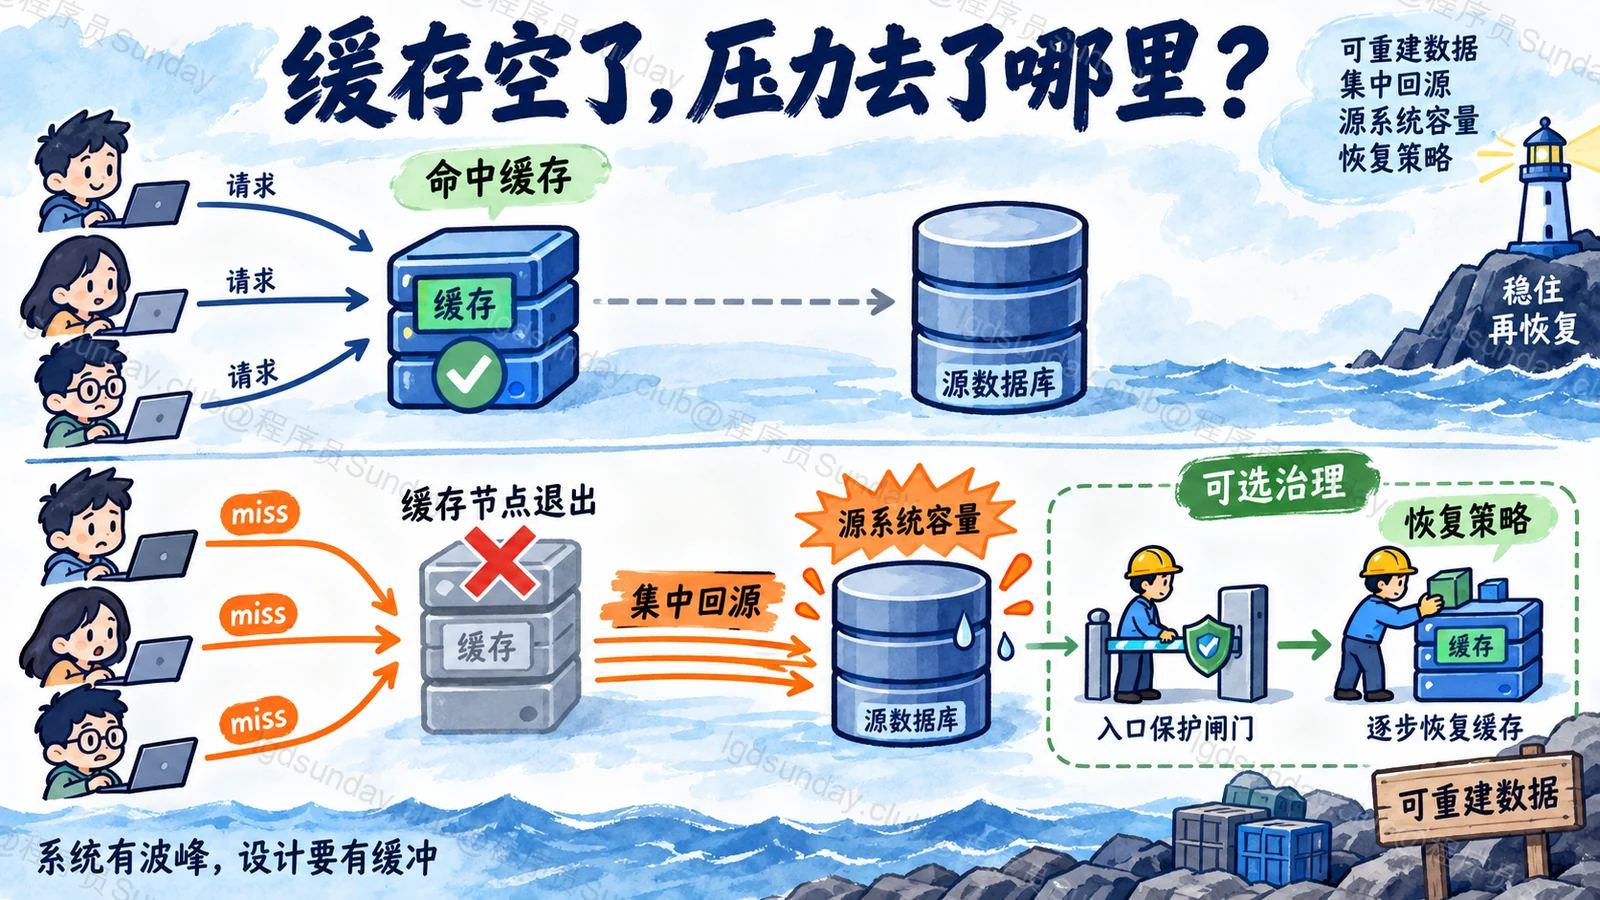
对于普通缓存,最重要的故障问题可能是:缓存清空以后,数据库能不能承受集中回源?即使缓存本身很快,源系统被压垮,用户仍然无法使用应用。
并发与内存,要按版本和工作负载比较
Memcached 与 Redis 的线程、I/O 和执行模型不同,而且版本会持续演进。不能用“Redis 永远只有一个线程”概括整个进程,也不能只根据线程数量推断吞吐。
对象大小、编码方式、分配与淘汰,都影响有效容量。一个产品存储更多键,不代表另一个产品一定浪费;需要确认对象和配置是否相同。
Redis 的对比资料来自供应商,可作为能力入口,但不能把其中的评价直接当成独立性能结论。技术选型应结合两方文档和自己的目标负载。
分布方式与运维责任,也不同
需要多个节点时,键怎样分配、节点故障怎样处理、客户端怎样更新,都要明确。Memcached 常见部署依赖客户端等方式组织分布,Redis 也有不同部署模式,不能把单节点体验直接推导成集群体验。
有效期和淘汰策略则决定数据什么时候消失。应用必须能够处理 miss,不能假设写入成功以后,缓存会一直保留到自己指定的时刻。
权限、网络隔离和监控同样需要设计。缓存里即使不是唯一数据,也可能包含敏感内容,不应直接暴露给不可信网络。
比较一条完整缓存链,而不是只测 set/get
可以固定一组对象大小、访问分布和有效期,观察命中率、尾延迟、内存、回源次数,再模拟缓存节点退出。
还要验证更新和失效流程。Redis 或 Memcached 的选择,不会自动保证数据库更新以后所有缓存都同步改变。
如果系统已经用 Redis,改成 Memcached 需要证明收益足以覆盖迁移和运维成本;反过来也一样。最合适的方案,可能是继续使用已经可靠运行的简单方案。
面试官继续追问
Redis 可以完全代替数据库吗?
不能泛化。是否适合作为主要存储,取决于数据模型、查询、可靠性和故障恢复要求。支持持久化不等于满足所有数据库需求。
Memcached 没有复杂结构,怎样做复杂缓存?
可以在应用中序列化结果,但局部操作与并发更新需要另外处理。是否值得这样做,要比较具体需求。
缓存节点重启最先要关注什么?
数据可恢复性和回源压力。缓存恢复很快,但源系统被集中请求压垮,也可能造成故障。
面试速记卡
- Redis:多种数据结构与操作,可靠性能力需要配置。
- Memcached:聚焦可重建的简单键值缓存。
- 选型起点:数据是整体结果,还是需要结构化操作。
- 共同边界:一致性、miss 和回源压力仍由系统处理。
- 比较条件:同对象、同有效期、同故障目标。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →