
MySQL 的 utf8mb4 和 utf8 有什么区别?Collation 为什么会影响比较和唯一索引?
下面是一段教学用的模拟面试。
🧑💻 面试官: utf8mb4 和 utf8 有什么区别?
🙋♂️ 我: utf8mb4 用四个字节,所以能存 emoji。
🧑💻 面试官: 每个英文字符也都占四字节吗?Alice 和 alice 为什么可能撞唯一索引?
🙋♂️ 我: 编码和比较规则应该是不同设置。
🧑💻 面试官: 只把表改成 utf8mb4,客户端连接还用另一种编码,就一定没问题吗?
这道题有两层:「怎么存」由字符集处理,「算不算相等」还要看排序规则。整条连接链路也不能漏。
面试速答(60 秒版)
在 MySQL 8.4 语境里,utf8 是 utf8mb3 的已弃用别名,只支持最多三字节的 UTF-8 字符;utf8mb4 支持完整 Unicode 范围,包括需要四字节表示的字符。
“四字节”是最大长度,不代表每个字符都占四字节。英文和许多常用字符的编码长度仍然不同。
字符集负责表示和编码,Collation 负责比较与排序。大小写、重音等是否区分,会影响查询、排序,也会影响唯一索引是否认为两个字符串冲突。
实际选型要同时确认数据库、表、列和客户端连接设置。改编码或排序规则之前,还要检查已有数据能否转换,以及新的比较规则是否产生重复。
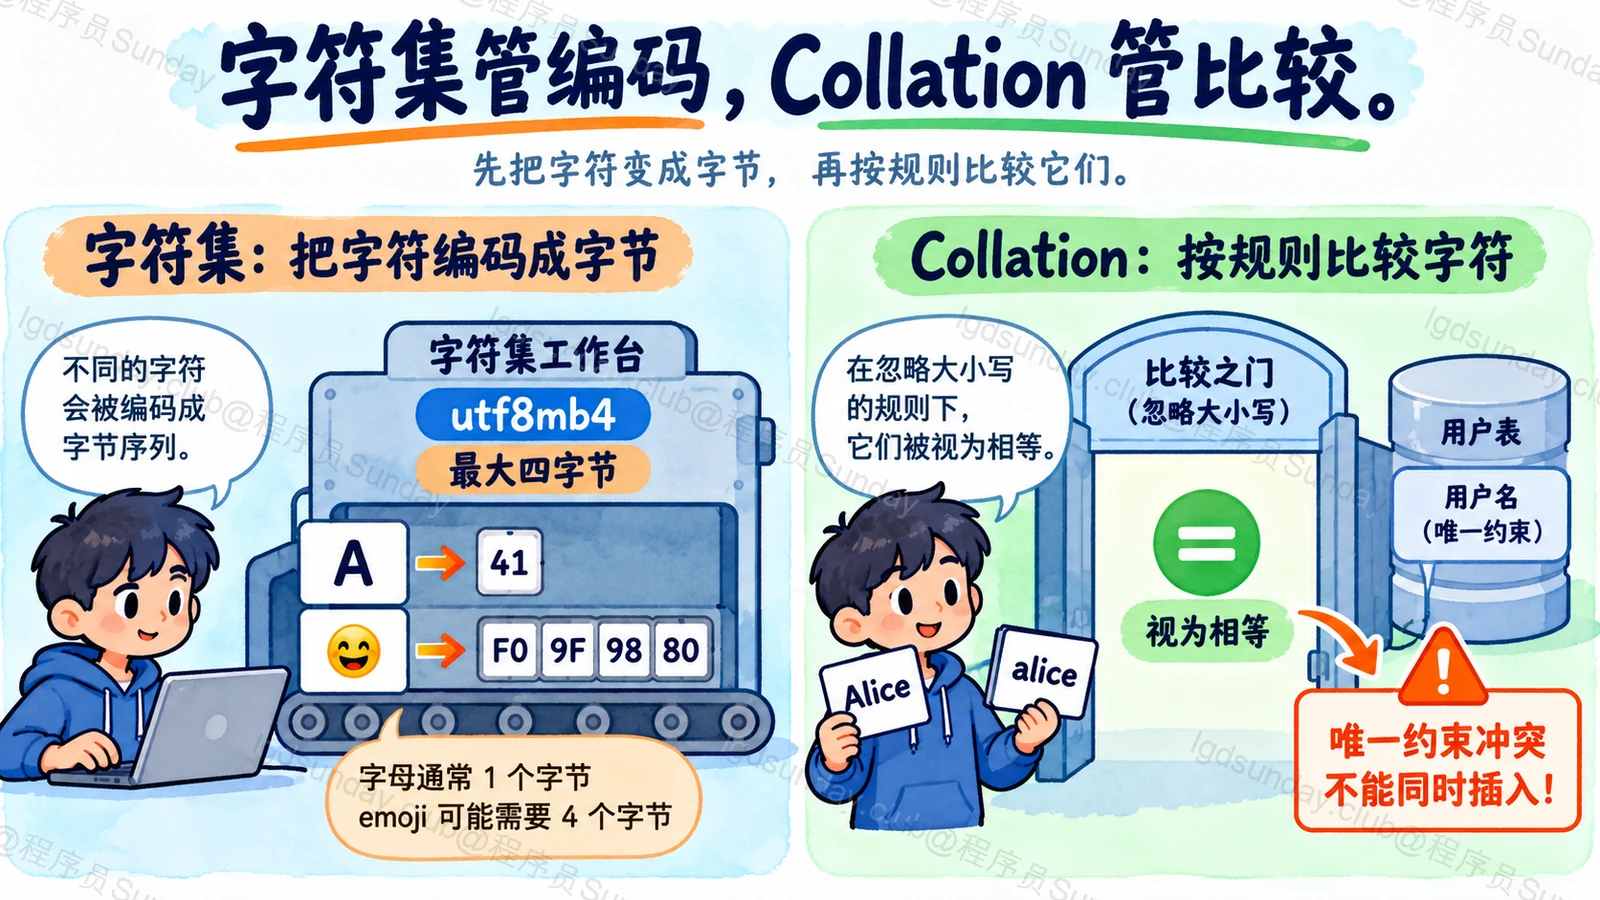
图:字符集管编码,Collation 管比较。
知识点详解:能存下来,与被当成相等,是两件事
utf8mb4 不是“全部字符加长”
UTF-8 是变长编码。utf8mb4 的能力是支持包括补充平面字符在内的完整范围,不是把每个字符硬塞成四字节。
旧的 utf8mb3 支持范围更窄。有些 emoji 在范围之外,所以即使表面上都写着 UTF-8,也可能无法正确保存。具体定义见 MySQL utf8mb4 说明。
另外,“能保存一个 Unicode 字符”不代表所有看起来像一个图案的 emoji 都只有一个码点。产品里的长度和展示规则,还要与业务语义配合。
Collation 为什么影响唯一索引?
假设用户名列使用忽略大小写的排序规则。Alice 与 alice 虽然字节不同,比较规则却可能把它们当成相等。因此,唯一索引会按这份规则判断冲突。
这是约束正常工作,不是数据库突然分不清字符串。如果业务要区分大小写,就需要选择与要求一致的比较规则,并考虑登录、搜索和现有数据迁移的影响。
常见后缀中,ci 表示大小写不敏感,cs 表示敏感;ai 表示重音不敏感,as 表示敏感。具体命名与例外见 MySQL Collation 命名说明。
不要把某一种规则概括成“只比较字节”。文本比较还涉及规则、版本以及字符语义。
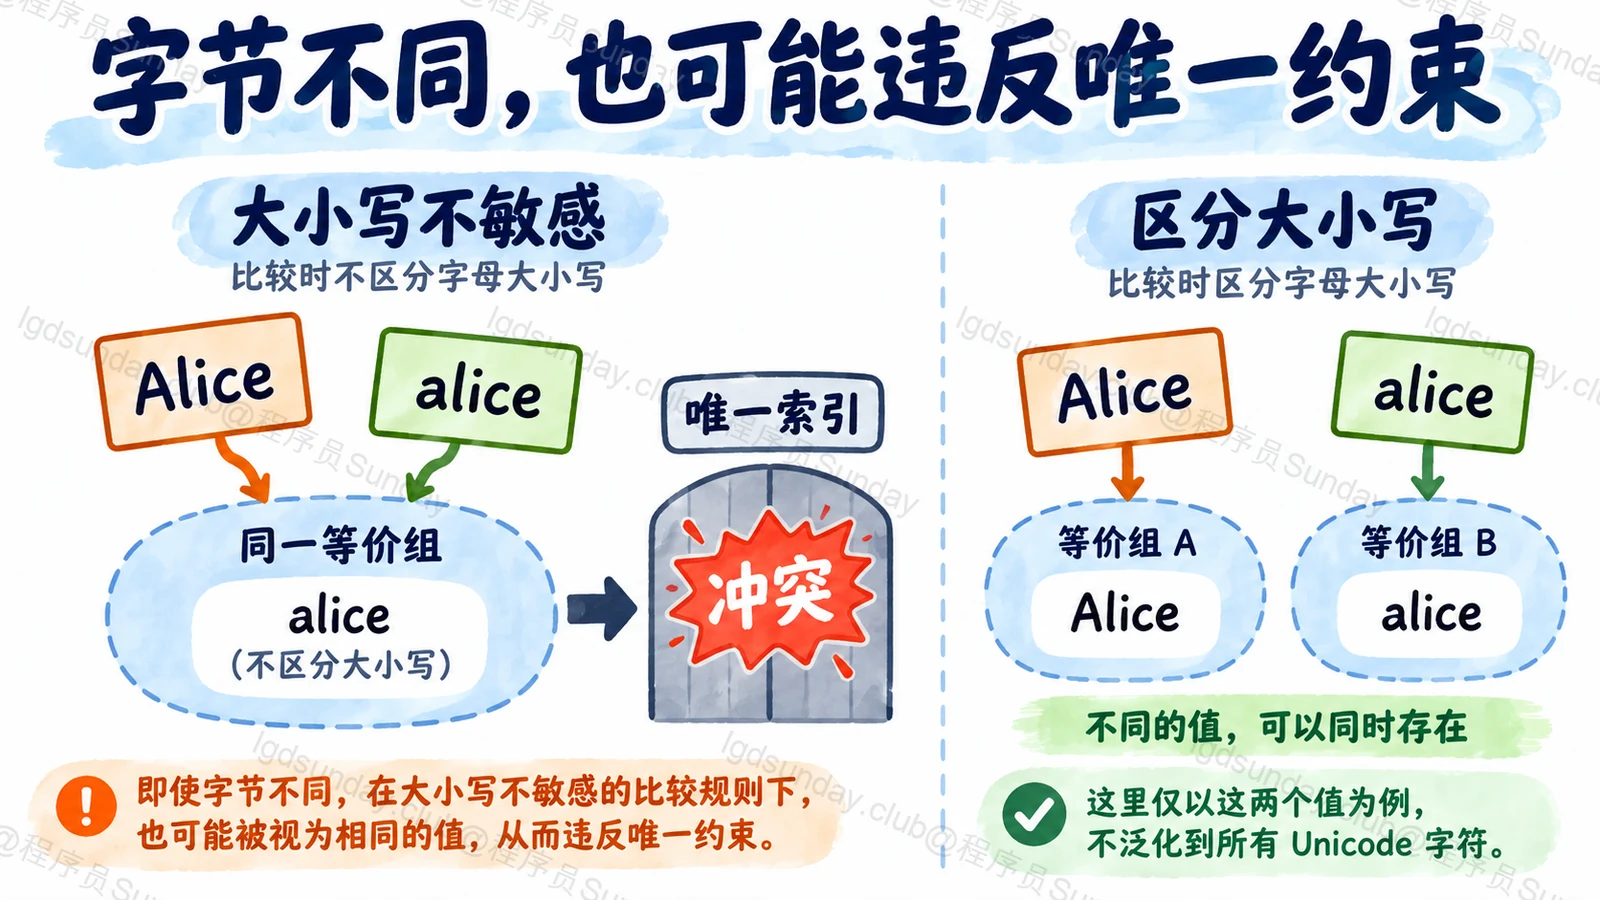
图:字节不同,也可能违反唯一约束。
为什么改表还不够?
客户端发送的字节需要按协商的连接设置解释;表达式、参数和存储列也有各自的设置。
如果客户端按一种编码生成字节,服务端却按另一种理解,即使列支持 utf8mb4,也可能发生错误。排查应沿着输入、驱动连接、数据库比较和返回这条链看,不能只截取表定义。
应用还要确认驱动实际生效的字符设置,而不是看到一项配置名字就结束检查。
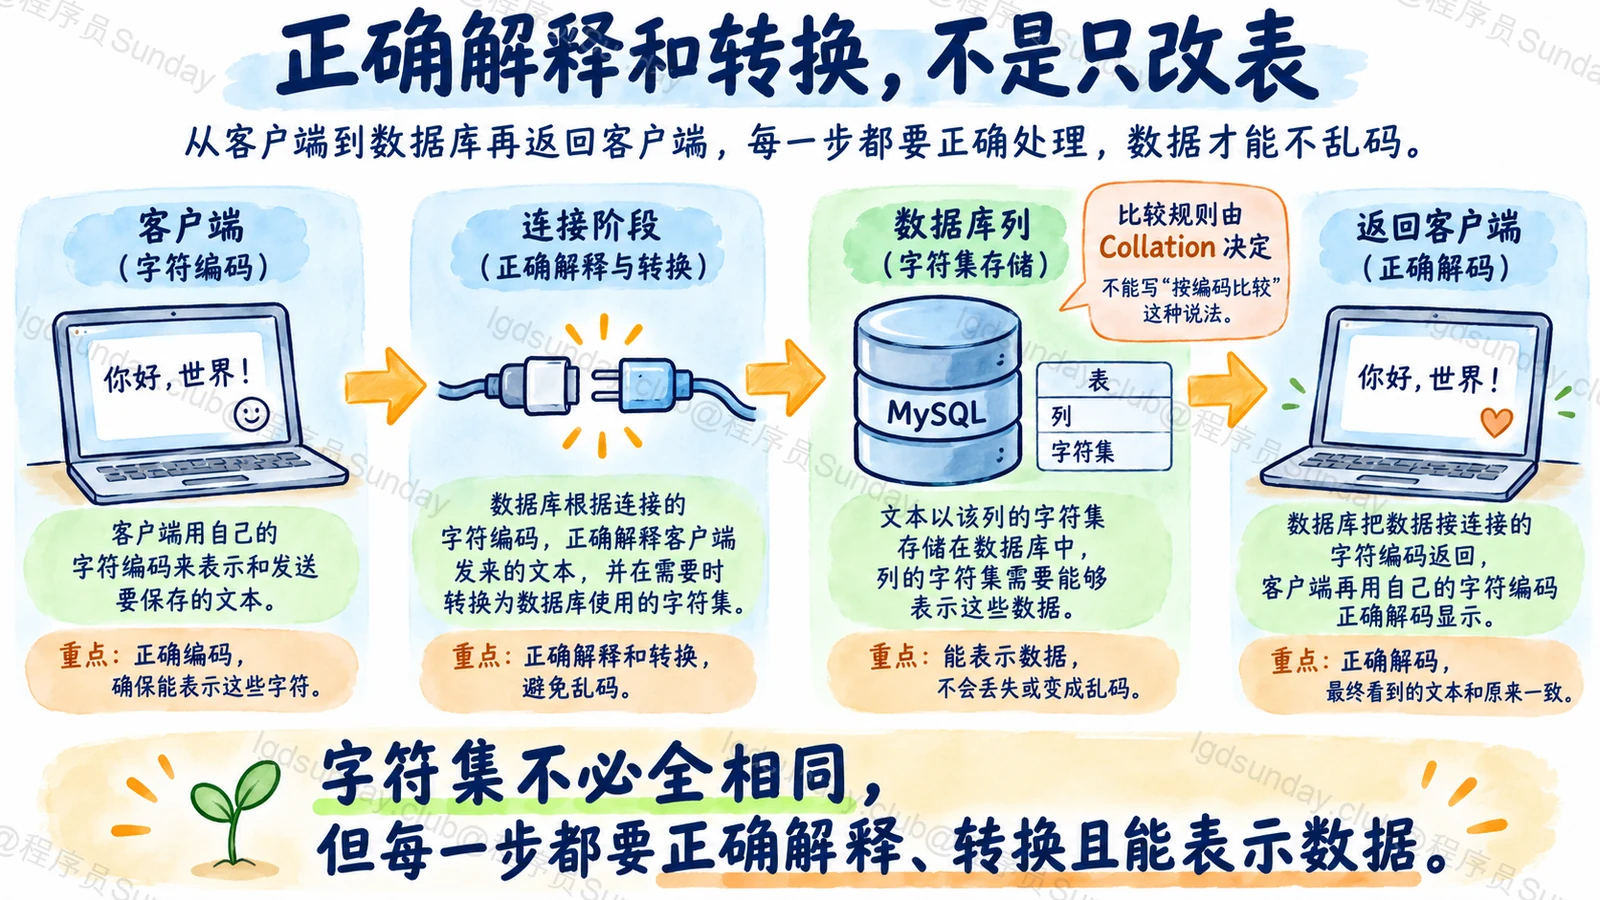
图:编码设置,要看整条链。
迁移规则前,先找可能的新冲突
假设旧规则区分大小写,已经存在 Alice 和 alice 两个账号。改成忽略大小写后,唯一约束的等价类变化,它们可能不能同时存在。
因此,迁移不只是重新保存字节。先按目标规则检查冲突,制定合并、改名或拒绝策略,再处理索引和应用行为。查询结果和排序顺序变化,也需要回归。
本文不提供一条生产“全库一键修改”的脚本,也没有把示意比较写成已经在目标库运行的结果。
面试官继续追问
字符长度与字节长度能混着算吗?
不能。存储容量、索引限制和产品输入长度关注的单位可能不同。先明确算字符、码点、字节还是用户看到的文本单位。
选择 binary 就解决所有用户名问题吗?
不一定。精确比较也是一种业务选择,还要考虑规范化、用户体验和安全要求,不能用一个排序规则代替完整输入设计。
面试速记卡
- utf8mb4:最大四字节,支持范围更完整。
- utf8:在 MySQL 8.4 是已弃用的 utf8mb3 别名。
- 字符集:表示与编码。
- Collation:比较、排序,也影响唯一约束。
- 迁移:连接设置、已有冲突和应用行为一起检查。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →