
MySQL 的 CTE 和子查询有什么区别?WITH RECURSIVE 怎么查询树形数据?
下面是一段教学用的模拟面试。
🧑💻 面试官:CTE 和子查询有什么区别?
🙋♂️ 我:CTE 可以给查询结果起名字,用 WITH 声明。
🧑💻 面试官:它一定会先执行并存到临时表吗?
🙋♂️ 我:不一定,优化器可能采用不同方式。
🧑💻 面试官:树形菜单怎样用 WITH RECURSIVE 展开?错误数据形成环,会自动停吗?
普通 CTE 改善查询组织,递归 CTE 还要设计「起点、每轮扩展和停止条件」。命名不等于自动有性能或安全保证。
面试速答(60 秒版)
CTE 是一条语句范围内命名的查询结果,用 WITH 声明,再在后面引用。它能把复杂查询分成易读的步骤,也能多次引用,但不是永久表。
子查询可以直接嵌入语句。两者有相似用途,实际执行是否合并或物化,由优化器与查询结构决定,所以 CTE 不一定更快。
递归 CTE 由起始查询与递归部分组成。先得到根节点,再用上一轮结果找下一层,直到不再产生新记录。
查询树时,我会检查 parent_id 索引、结果规模、最大深度和环路。使用 UNION ALL 且数据有环时,不能期待自动识别;需要业务条件和资源限制,避免无限扩展。
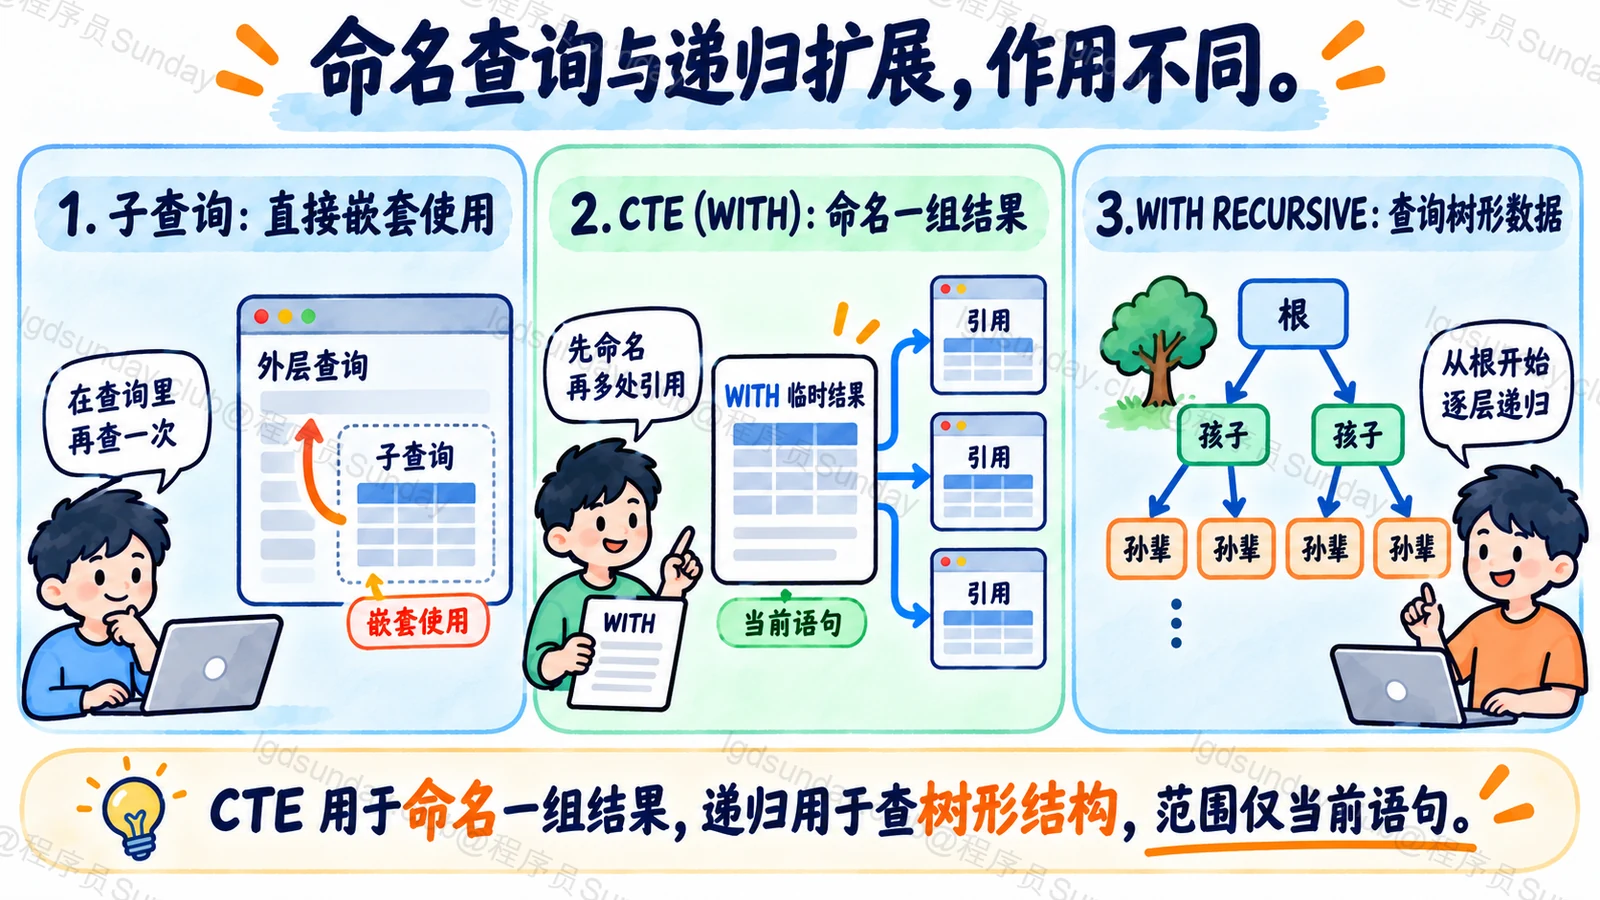
图:这里对比的是查询表达方式;不能从层数推断执行次数,也不能默认每个 CTE 都会物化。
知识点详解:递归查询怎样一轮轮展开树?
普通 CTE,先解决查询表达
假设报表 SQL 多处使用同一组过滤结果。CTE 可以给它命名,让后续计算更清楚。
作用范围是当前语句,不是创建永久表。优化器可能合并进外部查询,也可能物化为临时结果,受结构与规则影响,见 CTE 与派生表优化。
所以不能看到 WITH,就推断“先执行一次并缓存,肯定更快”。需要实际计划与测量。
起始部分选根,递归部分选孩子
假设 category 包含 id 和 parent_id,没有环,id 是唯一主键。查询 id=10 的节点和后代:
WITH RECURSIVE subtree AS (
  SELECT id, parent_id, 0 AS depth
  FROM category
  WHERE id = 10
  UNION ALL
  SELECT child.id, child.parent_id, parent.depth + 1
  FROM category AS child
  JOIN subtree AS parent ON child.parent_id = parent.id
  WHERE parent.depth < 20
)
SELECT id, parent_id, depth
FROM subtree
ORDER BY depth, id;
示例适用于 MySQL 8.4。SQL 不需再写成 TS/Python;应用调用时仍应绑定起点参数。
深度 20 是显式示例上限,不是通用推荐值,也不等于环检测。超过上限会截断,调用方要能识别结果不完整。
每轮使用上一轮新结果
先取得节点 10,再找它的孩子,然后找这些孩子的孩子。递归部分基于上一轮产生的记录继续扩展,直到没有新记录,见 MySQL WITH 文档。
最终 SELECT 负责输出。不要因为按层扩展,就假设最终天然保证展示顺序,需要顺序时显式 ORDER BY。
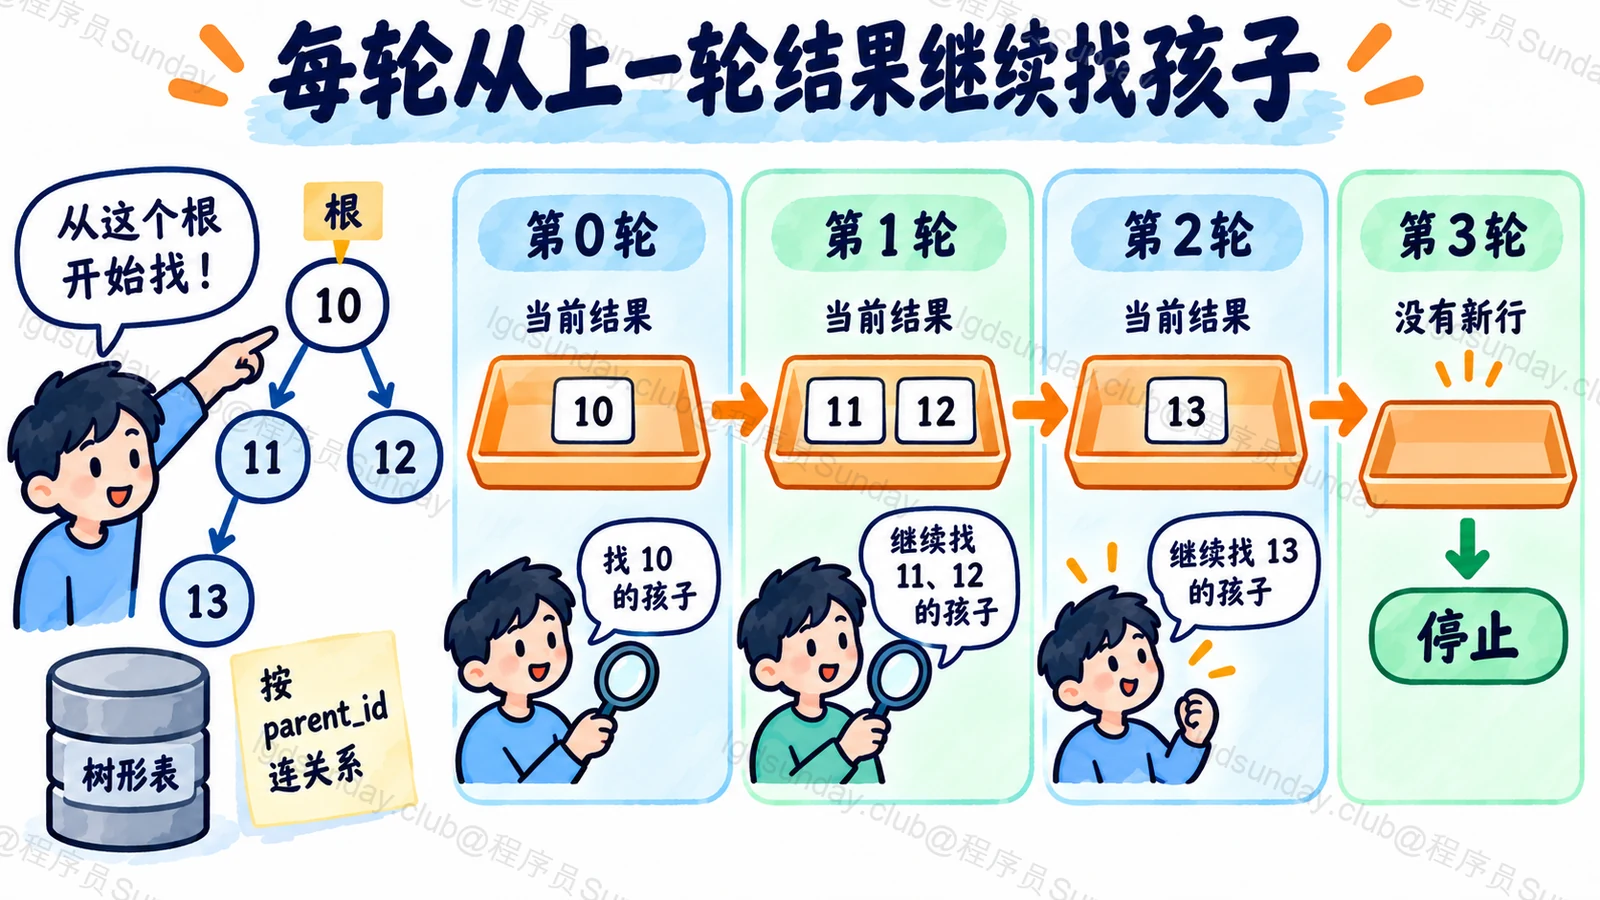
图:每轮从上一轮结果继续找孩子。
有环时,UNION DISTINCT 也未必解决
只返回固定节点身份时,去重可能阻止重复节点。但结果若包含增长的 depth 或 path,同一节点每轮的完整行不同,去重就未必能终止。
应按模型防环,例如维护已访问路径并排除重复节点,同时保留深度和时间限制。数据库递归上限是兜底,不证明数据合法,也不代表结果完整。
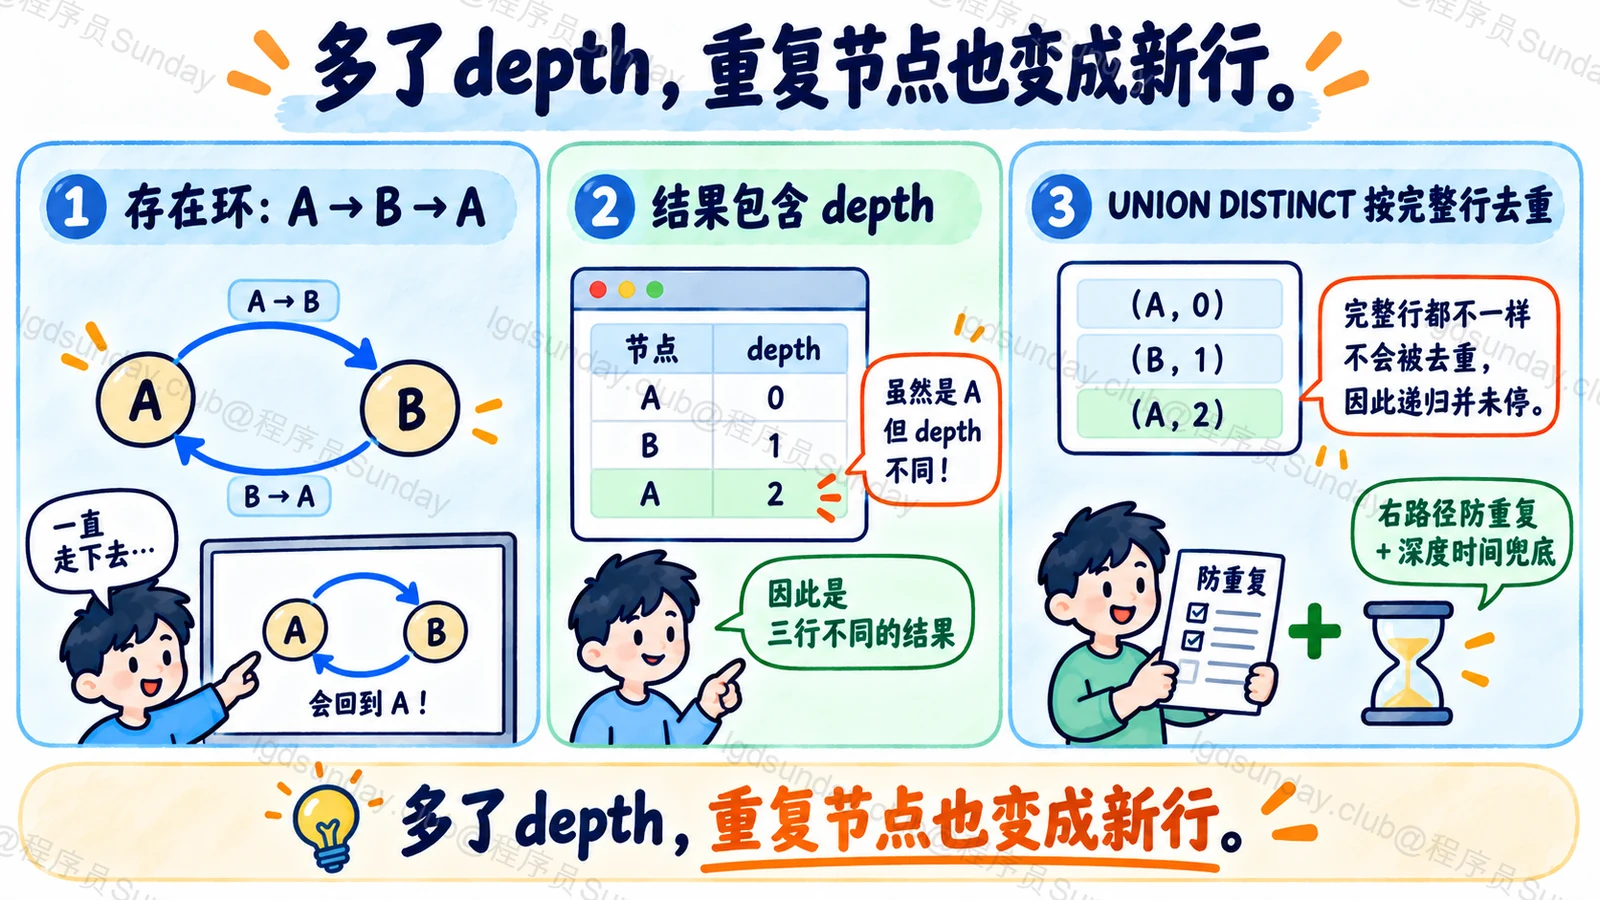
图:多了 depth,重复节点也变成新行。
性能看扩展规模与索引
按 parent_id 找孩子,合适索引很重要。宽树即使深度小,也可能产生大量结果。
限制结果规模,检查执行时间和临时结果开销。若频繁查询大范围祖先后代,可以评估其他树存储模型,而不是不断加大上限。
面试官继续追问
CTE 可以跨两条 SQL 复用吗?
普通 CTE 不能。需要视图、临时表等明确机制。
path 越来越长,有什么风险?
列类型按起始部分确定,可能需要显式扩宽,否则会截断或报错;还要控制总大小。
最大深度设很大就行?
不行,可能只是让错误查询跑更久。先保证停止逻辑,再设置限制。
面试速记卡
- CTE:当前语句内的命名查询结果。
- 执行:合并或物化,不能仅凭 WITH 判断。
- 递归:起点 → 上一轮扩展 → 无新结果停止。
- 环路:去重字段、路径和深度一起考虑。
- 性能:parent_id 索引、树宽度和结果规模。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →