
MySQL 死锁怎么排查?为什么统一加锁顺序能减少死锁?
🧑💻 面试官:两个接口偶尔报 MySQL 死锁,把事务重试一下就行吗?
🙋♂️ 我:数据库会回滚一个事务,重试就能解决。
🧑💻 面试官:如果每秒都出现,而且重试后又调用了一次支付接口呢?
🙋♂️ 我:那要先减少死锁,再保证重试不重复执行。
🧑💻 面试官:具体怎么查出谁拿着什么锁、又在等谁?
死锁不是“等得有点久”,而是等待形成了环。排查要还原加锁顺序,恢复要重试完整事务,并管好事务外副作用。
面试速答(60 秒版)
MySQL 死锁是几个事务各自持有锁,又等待对方的锁,形成无法自行推进的环。InnoDB 检测到后会选择一个事务回滚,让其他事务继续。
我会先保留死锁日志,把事务 SQL、持有锁、等待锁和执行顺序对应起来。当前锁等待可以看 Performance Schema,最近死锁可以看 SHOW ENGINE INNODB STATUS。
常见改进是缩短事务、让相关路径按照一致顺序访问记录,并用合适索引减少扫描和锁范围。不过统一顺序不能保证所有类型的死锁都消失。
应用仍要支持有上限的完整事务重试。支付、通知等事务外动作不能无保护地一起重放,需要幂等或提交后的可靠处理方案。
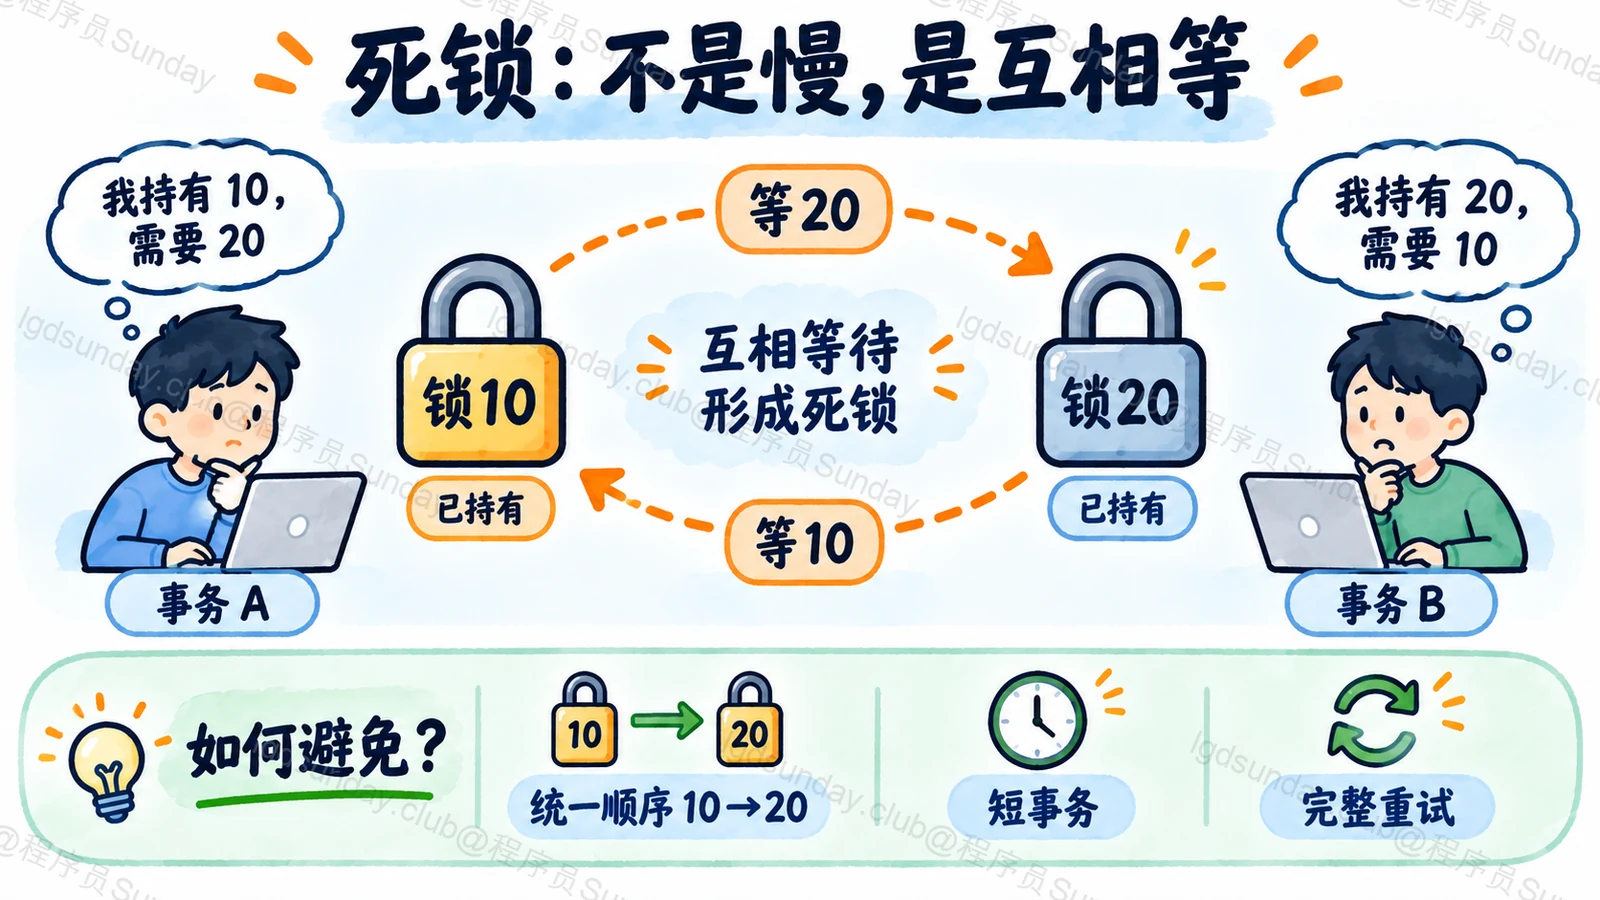
知识点详解:把等待关系画出来,才能知道该改哪里
两条记录就能形成等待环
假设事务 A 先锁住任务 10,再更新任务 20;事务 B 先锁住任务 20,再更新任务 10。
A 等 B 放开 20,B 等 A 放开 10。双方都不提交,锁就无法释放。这和一个慢事务挡住其他事务不同:后者可能等慢事务结束就恢复;死锁必须打破环。
InnoDB 的检测与回滚可以解开当前这一轮,但业务如果一直采用相反顺序,下一轮还会遇到。
日志要对应到实际 SQL,而不是只看错误码
SHOW ENGINE INNODB STATUS 可以查看最近检测到的死锁。频繁发生时,可以按运维流程短期开启全部死锁日志,收集后恢复设置,避免长期增加日志压力。
performance_schema.data_locks 与 data_lock_waits 能观察当前锁与等待关系。已经被检测并处理掉的死锁,未必还能在当前等待表里找到,所以历史日志和实时视图要分工。
还要把应用里的事务边界找出来。日志里一条 UPDATE 等待,不代表这个事务此前只执行过这一条 SQL。
统一顺序,是让争抢尽量排成队
上述例子可以约定所有相关路径先处理 ID 小的任务,再处理 ID 大的任务。这样 B 更可能先等 10,而不是拿着 20 再反向争抢。
不过数据库还可能因为二级索引、范围锁、唯一性检查等出现其他锁关系。并发 INSERT 或 DELETE 也不能被当作“只碰一条记录,绝不会死锁”。
索引可以减少扫描到的记录,从而缩小部分加锁工作量。索引是否有效,要结合实际执行计划和隔离级别,不是把所有字段加索引。
重试要从事务开始,并且有停止条件
收到死锁回滚后,应重新执行完整事务,让检查和修改在新的事务中保持一致。只重试最后一条失败 SQL,可能丢掉此前已经被回滚的步骤。
建议设置次数上限,并采用退避或抖动,记录重试次数与最终失败。持续死锁时,不能用无限重试把数据库压力放大。
如果事务内混了网络支付调用,数据库回滚不会撤回支付。要把事务外副作用单独设计,例如请求幂等、事务消息或 Outbox,而不是以为“ROLLBACK 会回滚所有事情”。
本题机制参考:死锁处理、锁等待视图、InnoDB 错误处理。
面试官继续追问
锁等待超时和死锁是不是一样?
不是。超时表示等待超过限制,不一定有环;错误后的回滚范围也应按引擎设置和具体错误处理,不能机械沿用死锁结论。
改成 READ COMMITTED 就没有死锁了?
不能。它可能减少部分范围锁冲突,但行锁、唯一性检查等仍会形成死锁,还会改变读取语义。
为什么重试仍要保留失败告警?
因为最终成功不代表设计健康。频繁重试会增加延迟和负载,需要跟踪发生率、事务类型和重试成本。
面试速记卡
- 定义:持有锁并互相等待,形成环。
- 证据:历史死锁日志与当前锁等待分开看。
- 减少:短事务、统一顺序、合适索引。
- 恢复:有上限地重试完整事务。
- 边界:数据库回滚不能撤回外部支付。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →