
SQL 的 UNION 和 UNION ALL 有什么区别?什么时候不能省略去重?
下面是一段教学用的模拟面试。
🧑💻 面试官:UNION 和 UNION ALL 有什么区别?
🙋♂️ 我:UNION 去重,UNION ALL 不去重。ALL 少做一步,一般更省开销。
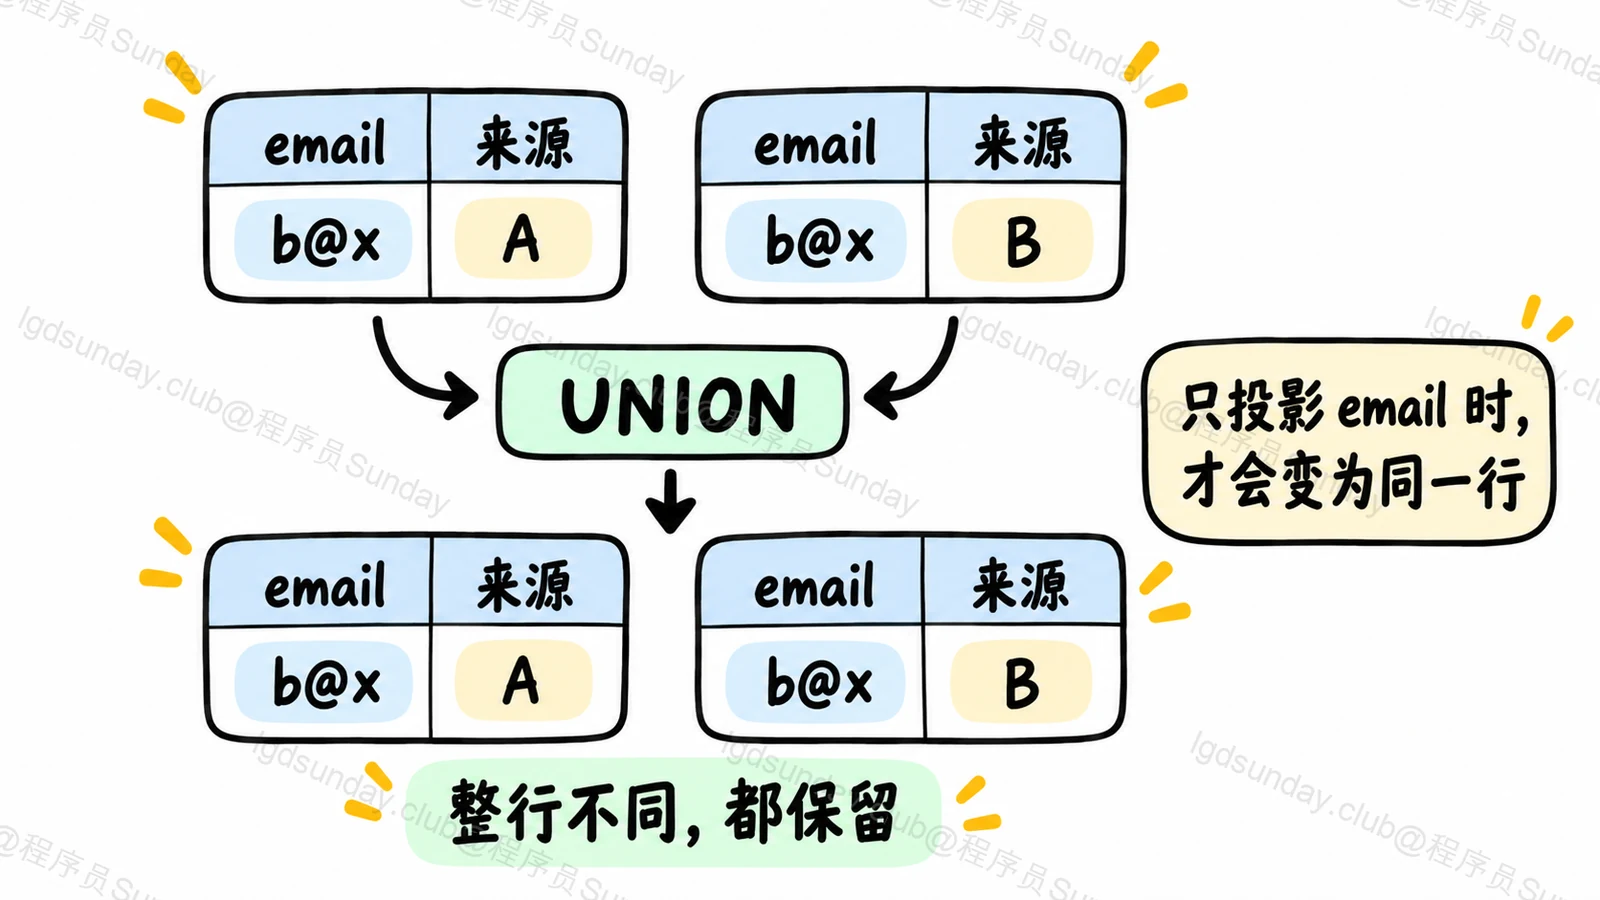
🧑💻 面试官:两份用户查询都包含用户 7,但一个额外返回“来源 A”,另一个返回“来源 B”,UNION 会把用户 7 合成一行吗?
🙋♂️ 我:不会,整行不一样。
🧑💻 面试官:所以这里的“去重”到底按什么判断?你把 UNION 换成 ALL 之后,报表人数翻倍,是性能优化还是改了答案?
合并之前先问:「重复行应当保留吗?」少做去重可能更省,但不能省掉结果本来需要的语义。
面试速答(60 秒版)
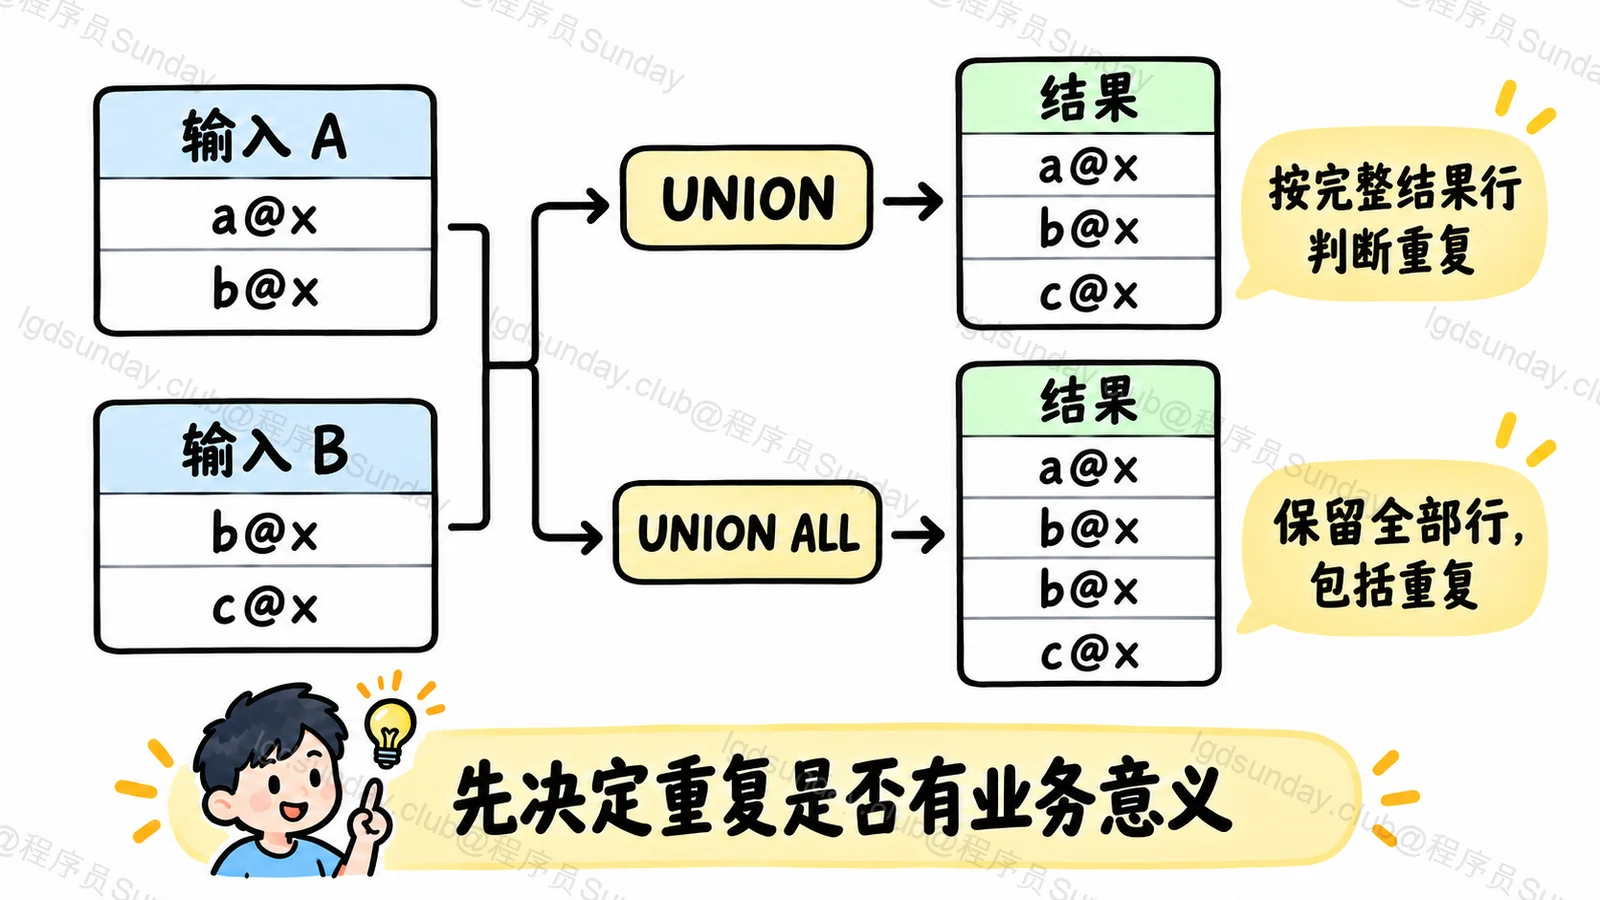
UNION 把多个查询结果纵向合并,并对合并后的重复行去重;UNION ALL 则保留所有行,包括来源之间和单个来源里的重复。
去重比较的是输出行,不是自动按某个用户 ID 合并。每个查询需要有相同列数,相应位置的类型也要能按数据库规则兼容,列名则通常取自第一个结果。
选型时,结果需要唯一行就不能随手改成 ALL;确认来源互斥,或者重复本来有意义时,可以考虑 ALL。性能再结合执行计划和真实数据看。两者都不保证最终顺序,展示排序需要在最终结果上明确写 ORDER BY。
知识点详解:合并两份名单,到底留下几行?
UNION 是往下接,不是按 ID 连在一起
假设咱们有两份活动参与名单。A 活动的用户编号是 7、12,B 活动是 12、20。
UNION ALL 得到四行:7、12、12、20。UNION 得到三种不同的输出行:7、12、20,但显示顺序仍要明确安排。
它们是在把结果一份接在另一份下面,而不是像 JOIN 那样,依据条件把两张表的字段横向组合。MySQL UNION 文档定义了这个结果合并操作。
所以,如果需求是给每个用户补上另一个表里的资料,通常先考虑连接关系;如果需求是合并两批同形状的记录,才讨论 UNION。
去重比较整行,不会猜业务身份
先只查询 user_id,两个 12 是相同输出行,UNION 可以去掉重复。
再给每行增加 source:
SELECT user_id, 'A' AS source FROM activity_a
UNION
SELECT user_id, 'B' AS source FROM activity_b;
这时 (12, ‘A’) 和 (12, ‘B’) 不一样,两行都应保留。数据库不会替你猜“这两个其实是同一个人,所以不要管来源列”。
如果想得到唯一用户,应只合并需要去重的身份列,或者另外定义按业务键处理来源的规则。把更多字段随手带进 SELECT,可能已经改变了去重口径。
同样,NULL 与 NULL 在集合去重中的处理,不应简单套用 WHERE 里 NULL = NULL 的三值逻辑直觉。字符串的比较还受数据库类型与排序规则影响,不能保证文本外观稍有不同就一定被视为不同输出行。
为什么两个 SELECT 的列要对得上?
数据库需要给合并结果确定一个稳定的列结构。
因此,各查询的列数要一致,第一列与第一列、第二列与第二列按位置对应。它不是按字段名自动找同类字段。
例如一份返回 user_id、name,另一份返回 name、user_id,即使列名看起来都存在,也不能认为顺序会自动修正。类型转换可能让查询能执行,却得到不是你想要的结果。
本题按 MySQL 8.4 讨论,具体兼容与转换规则仍应按目标数据库确认。集合操作规则给出了相应要求。SQL 本身已足以说明,不额外复制 TypeScript 和 Python 客户端代码。
UNION ALL 为什么可能省开销?
去重需要判断哪些输出行重复。数据库可能为此采用排序、临时结果或其他执行方式,实际方法要看版本与执行计划。
ALL 不要求消除重复,因此经常能少做相关工作。但不能直接保证所有查询都“快一倍”,也不能据此改掉报表原来的去重规则。
假设统计活动参与人数。相同用户参加两项活动,业务要求只算一人,那么直接用 ALL 后计数就是改了结果。更快地得到错误人数,不是完成了同一个优化。
如果两份查询覆盖互斥的日期分区,并且单份结果也不会产生重复行,就可以讨论 ALL。这种互斥应来自可靠的数据与查询约束,不是靠“目前碰巧没重复”。
排序和 LIMIT,放在哪里会改变结果?
假设咱们想找两类日志合起来最新的十条。
最终 ORDER BY 与 LIMIT 应作用于合并结果,才能表达“整体最新十条”。如果每份来源先 LIMIT 十条,但没有明确排序,截出来的就不是可靠的候选。
每份来源是否能先裁剪,需要证明裁剪不会删掉最终需要的行;不同数据库对括号和局部排序也有语法要求。不能随便把 LIMIT 往里移,就声称只是减少计算量。
另外,UNION ALL 不保证先完整显示 A 再显示 B。执行与展示顺序不是一个可以依赖的接口,页面想稳定排序就明确写出来。
怎样证明改成 ALL 没改答案?
准备来源间重复、来源内重复、相同 ID 不同字段、NULL,以及字符串排序规则相关数据。
先确定正确的结果集合或多重集合,再对照两种查询。不能只比较总行数,因为不同内容也可能恰好有相同行数。
性能验证再比较参与数据规模、执行计划、时间和资源。正确性与成本都符合要求,才有理由替换,而不是先替换再找一个没有重复的样本证明自己。
面试官继续追问
UNION 只去掉不同来源之间的重复吗?
不是。它对整体合并结果去重,也会影响单个来源原来就有的重复输出行。ALL 才保留这些次数。
已经用 GROUP BY 去重,还需要 UNION 吗?
看最终口径。各来源内部唯一,不保证两个来源互不重叠。不能因为局部去重,就推导整体一定不重复。
UNION 结果可以理解为按主键唯一吗?
不可以。只有输出行的组成恰好表达了那个唯一身份时,结果才可能符合相应业务需求。否则需要额外定义按键合并规则。
面试速记卡
- 合并方向:UNION 纵向拼结果,JOIN 按条件组合字段。
- 去重:UNION 按输出整行去重;ALL 保留全部行与重复次数。
- 列结构:列数一致,按位置对应,类型遵守数据库规则。
- 性能:先保证语义,再比较成本,不为速度省掉必要去重。
- 顺序:最终结果明确 ORDER BY,局部 LIMIT 不能随意搬动。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →