
MySQL 回表、覆盖索引和索引下推有什么区别?它们分别减少了什么开销?
下面是一段教学用的模拟面试。
🧑💻 面试官: 回表、覆盖索引和索引下推有什么关系?
🙋♂️ 我: 都是让查询尽量走索引,减少全表扫描。
🧑💻 面试官: 已经用了二级索引,为什么还要查主键?覆盖索引和 ICP 是同一种优化吗?
🙋♂️ 我: 应该一个不需要再取完整行,另一个先过滤。
🧑💻 面试官: 那你能指出,过滤发生在哪里,以及哪些字段足够返回结果吗?
这道题要盯住一次动作:「取完整行」。覆盖索引尽量省掉它,ICP 尽量让更少候选行走到它。
面试速答(60 秒版)
在 InnoDB 里,二级索引记录包含索引列和主键值。如果查询还需要二级索引中没有的列,通常要按主键到聚簇索引取行,这就是常说的回表。
覆盖索引是查询需要的信息可以从所选索引取得,通常避免再为这些列取完整行。但实际访问行为还要结合执行计划、事务可见性等条件判断。
ICP,也就是索引条件下推,是把能利用索引记录判断的部分条件交给存储引擎先检查。不符合条件的候选记录,就不必为了它取完整行。
因此,两者不一样:覆盖索引关心“要的信息在哪里”,ICP 关心“什么时候过滤候选”。具体收益取决于数据分布和执行计划。
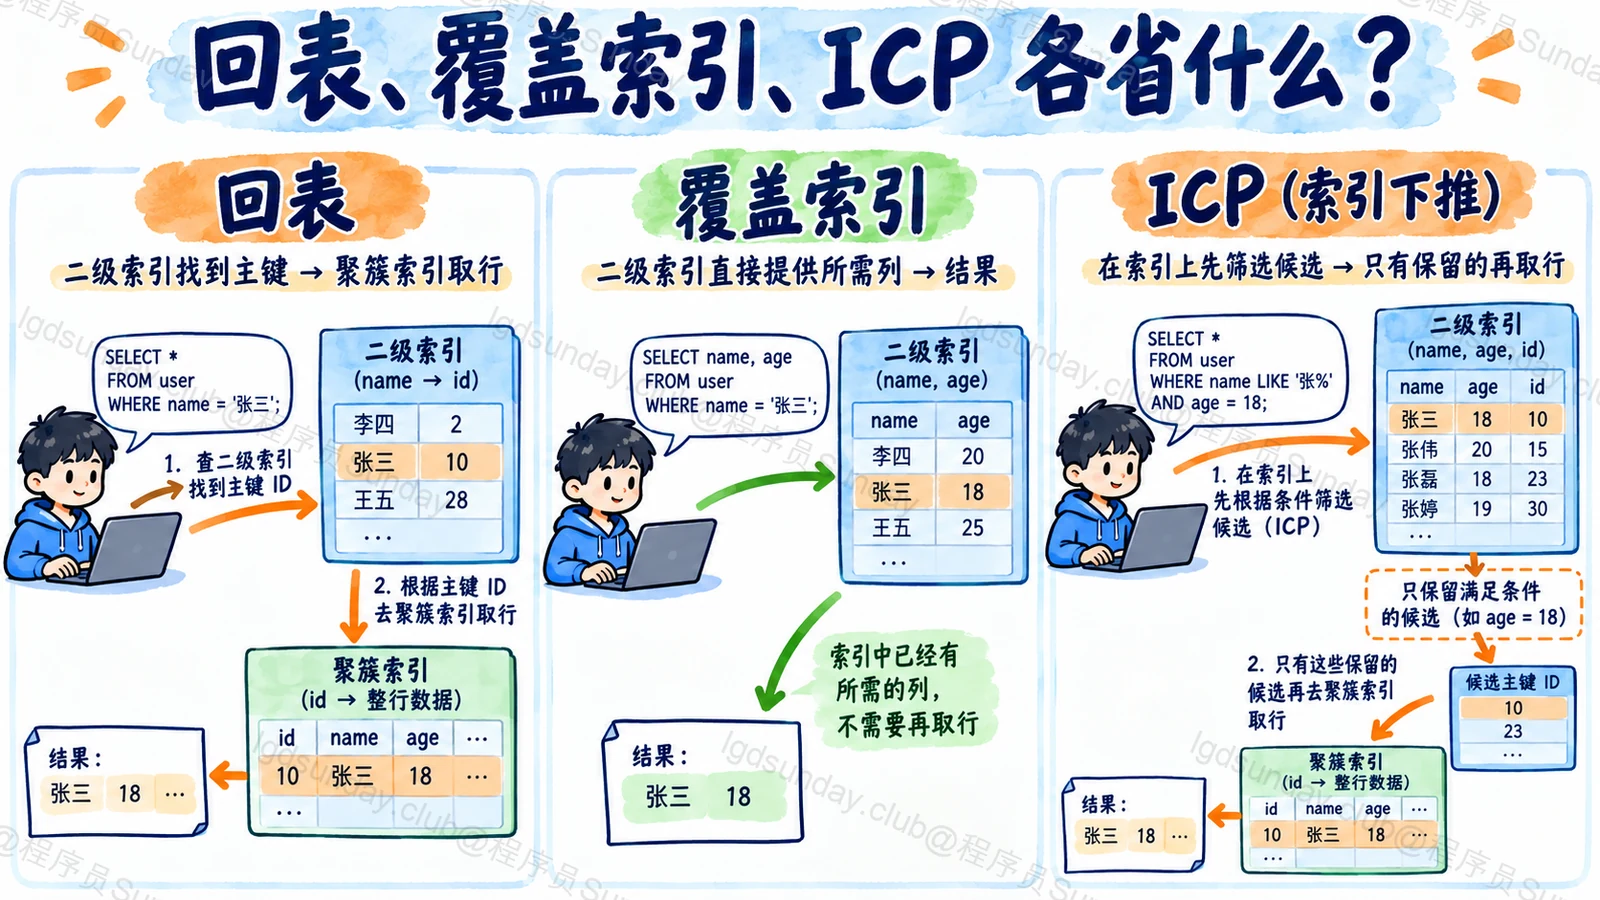
图:回表、覆盖索引、ICP 各省什么?。
知识点详解:沿着一条查询看完整行被取了几次
二级索引为什么只带一部分信息?
假设用户表有主键 id,以及联合索引 city、age。二级索引里能够找到 city、age 和对应主键,但不包含用户表的所有列。
查询满足城市条件的用户姓名,索引可以帮助定位候选,但 name 不在这个索引里。于是需要沿着主键去聚簇索引拿到所需的行内容。
这个过程并不等于“先全表扫描一遍”。它是索引定位候选后,再通过另一个访问路径取行。
覆盖索引:返回的信息已经够了
如果同样的条件只要求返回 id、city、age,所选二级索引已经能提供这些信息,就有机会形成覆盖访问。
所以,SELECT * 与只取需要的列,不只是代码长短不同。取列的范围会影响是否需要额外访问完整行。
不过,不能为了覆盖每条查询,把所有列都塞进一个很宽的索引。索引会占空间,也会增加写入和维护成本。某些事务可见性检查还可能需要进一步访问,不能从术语推出“底层永远零行访问”。
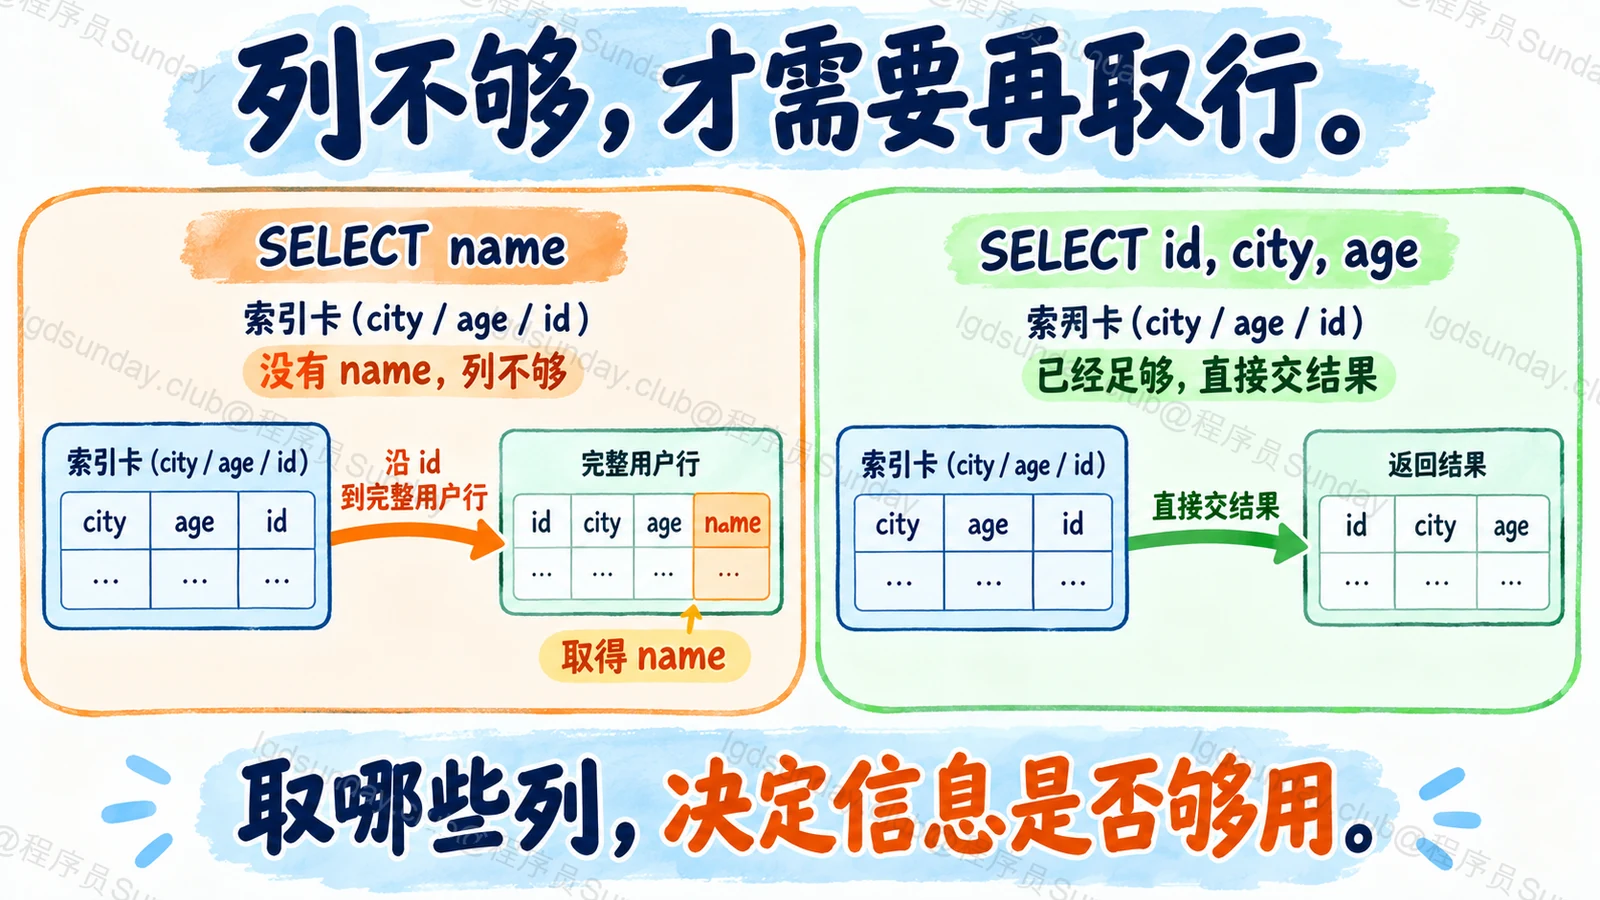
图:列不够,才需要再取行。
ICP:先筛掉能在索引上判断的不合格记录
仍用 city、age 索引。假设通过 city 范围定位了一批候选,同时还有可以用索引里的 age 检查的条件,最终又需要 name。
没有相应下推时,可能先取候选行,再检查这个条件。使用 ICP 时,存储引擎先在二级索引记录上检查 age;不符合的候选,就少一次为了它取完整行的机会。
重点在于:过滤能提前,但需要返回的 name 仍不在索引里。保留下来的候选还可能需要回表。机制和支持范围见 MySQL 8.4 ICP 文档。
并不是全部 WHERE 条件都可以下推。条件是否适用、索引类型和优化器选择,都需要检查。
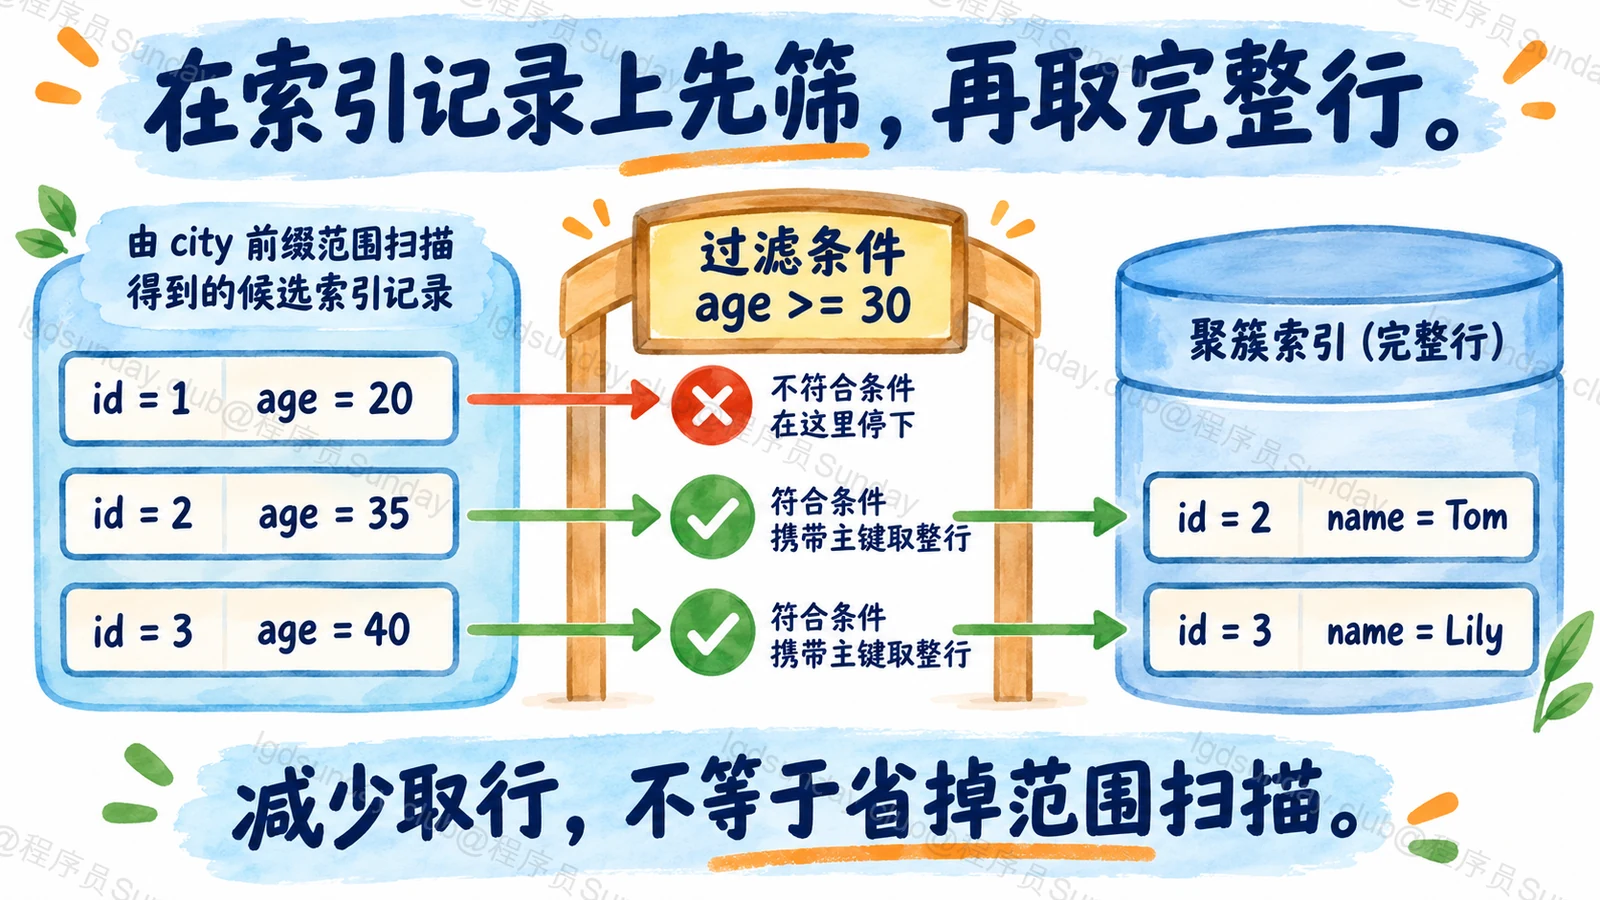
图:先在索引里筛,再取完整行。
执行计划怎样读,才不混淆?
EXPLAIN 里常见的 Using index 通常提示覆盖访问;Using index condition 提示索引条件下推。两串文字看起来相近,指的事情不同。
还要结合所用索引、访问类型、估计与实际候选数量理解。不能只看出现一个 index 单词,就断言回表已经消失,更不能用“走索引”直接替代性能测试。
本题不需要应用语言代码。真正验证应使用目标 MySQL 版本和数据集;本文的示意不冒充已经跑过真实库的结果。
面试官继续追问
ICP 会减少二级索引候选扫描吗?
不要混淆扫描候选与获取完整行。它主要让存储引擎在索引记录上提前检查适用条件,可能减少取行;并不自动改变整个范围扫描的定位方式。
覆盖索引一定更值得建吗?
要权衡读收益与索引大小、写放大、缓存占用。读得少、写得多的宽索引,可能不值得。
面试速记卡
- 回表:按二级索引里的主键,再去聚簇索引取行。
- 覆盖:所选索引能提供查询需要的信息。
- ICP:索引上先检查适用条件,减少不必要取行。
- 计划:Using index 与 Using index condition 不是同义词。
- 取舍:读收益要对照写入、空间和缓存成本。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · Java后端 · 实习
聚簇与非聚簇索引有什么区别,什么是覆盖索引?(题意整理)
4.21美团Java实习一二面面经 ↗
面试记录为 2020-04-21、2020-04-24;原帖编辑于 2020-11-14