
MySQL 的 Nested Loop Join 和 Hash Join 有什么区别?关联查询为什么会慢?
下面是一段模拟面试对话。
🧑💻 面试官:两张表做 JOIN,数据库怎么找到匹配行?
🙋♂️ 我:逐行遍历第一张表,再去第二张表找对应记录。
🧑💻 面试官:第二张表有连接字段索引,还需要每次扫完整张表吗?
🙋♂️ 我:不需要,可以用索引查找。
🧑💻 面试官:如果两边都有很多行,连接字段又没有可用索引呢?Hash Join 为什么可能更合适,内存放不下又怎么办?
连接查询要分开看「结果应该是什么」和「数据库怎样匹配」。算法名称只有结合输入规模、索引与内存,才能解释快慢。
面试速答(60 秒版)
Nested Loop Join 会从一个输入取出一行,再到另一个输入查找匹配行。如果内层有可用索引,每次可以做索引查找;没有有效访问路径时,就可能重复扫描很多数据。
Hash Join 则为一侧输入建立哈希表,再让另一侧按连接键查找匹配项,适合某些需要处理较多数据、缺少合适索引的关联查询。MySQL 8.4 的 Hash Join 说明。
因此,不能简单说 Hash Join 一定更快。少量外层行配合内层索引,Nested Loop 可能很高效;Hash Join 需要构建和内存,数据放不下还可能使用磁盘。
排查时应核对实际计划、输入行数和过滤位置,再看实际 rows、loops 和耗时,避免仅根据 JOIN 写法猜执行算法。
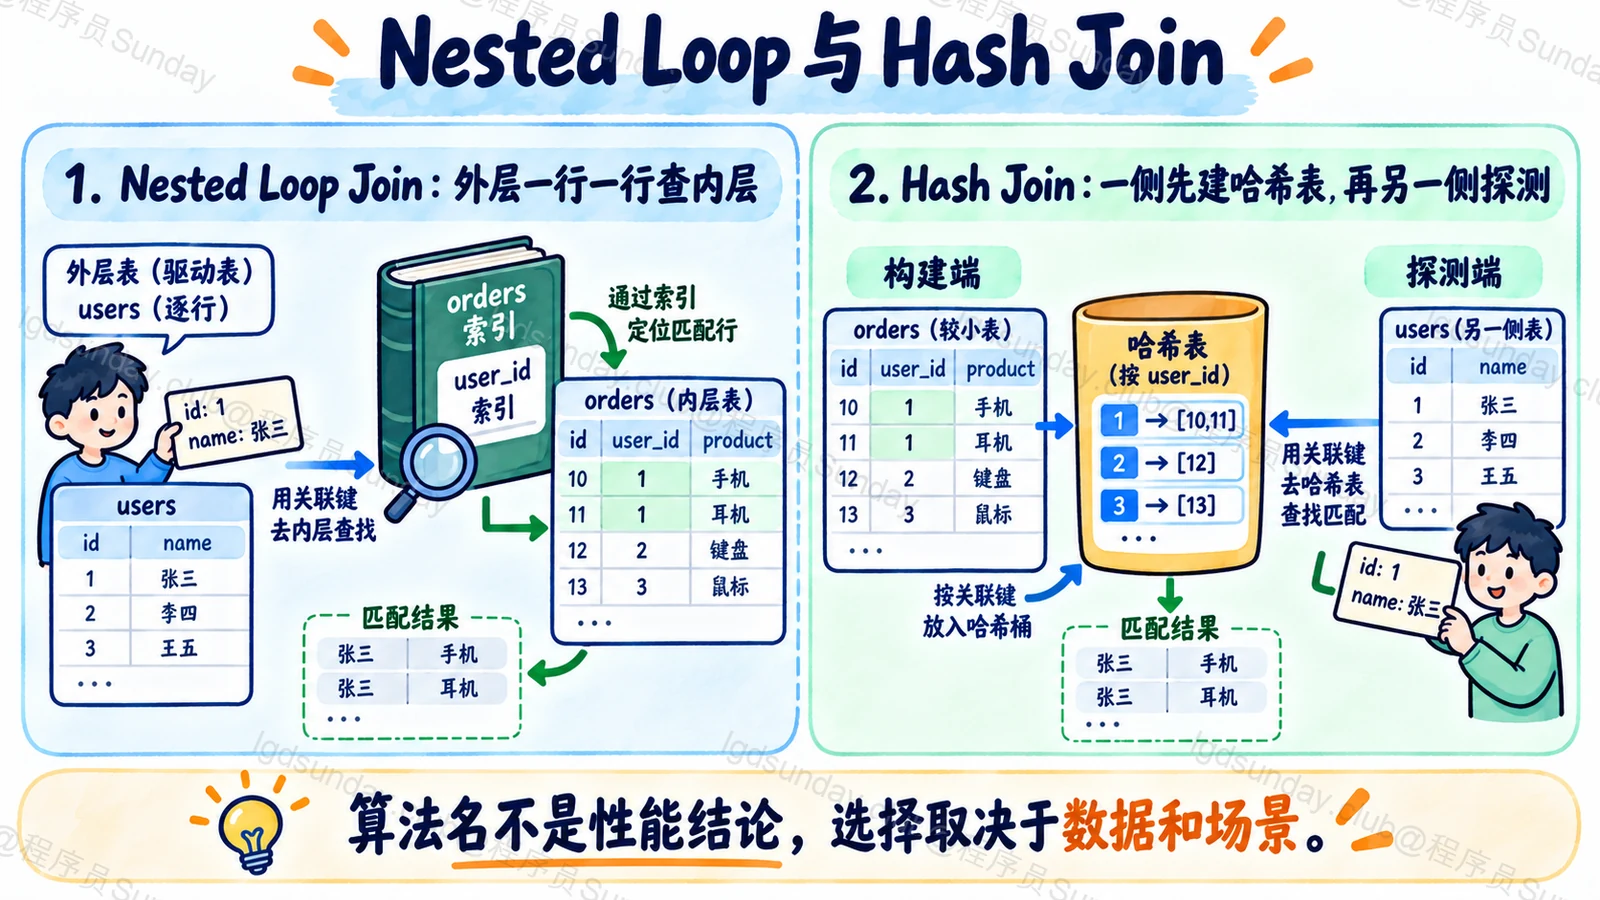
知识点详解:两种办法怎样完成同一项匹配
索引嵌套循环,不等于两张表反复全扫
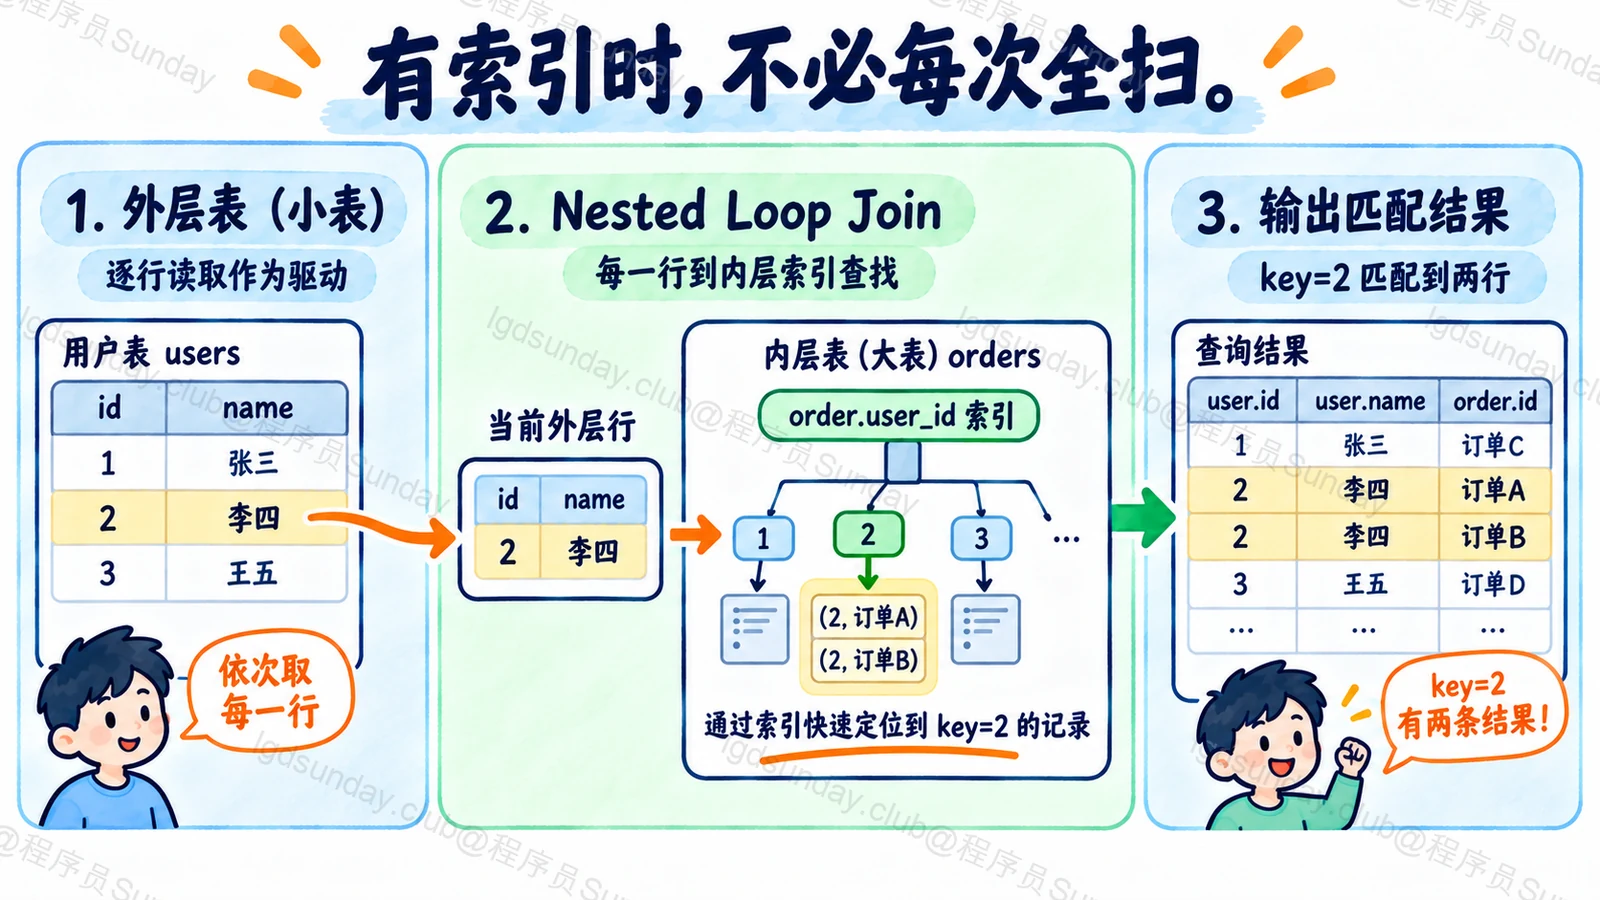
假设要查询一小批用户的记录。用户表经过条件过滤以后,只剩三位用户;记录表的 user_id 有可用索引。
执行器可以先取一个用户,再按这个用户的编号查记录索引。找完以后取下一位用户,继续查对应记录。Nested-Loop 官方说明。
因此,外层有几行,内层就会被驱动几次;每次访问的代价,还要看索引定位和匹配行数。不能把所有 Nested Loop 都套成两张表行数相乘。
如果外层行很多,或者每个用户有大量记录,索引查找和后续读取也会积累成本。“有索引”说明有一种访问办法,仍然要检查到底读取了多少数据。
Hash Join 先整理一侧,再查另一侧
现在假设需要关联两侧的大量记录,连接字段没有合适索引。
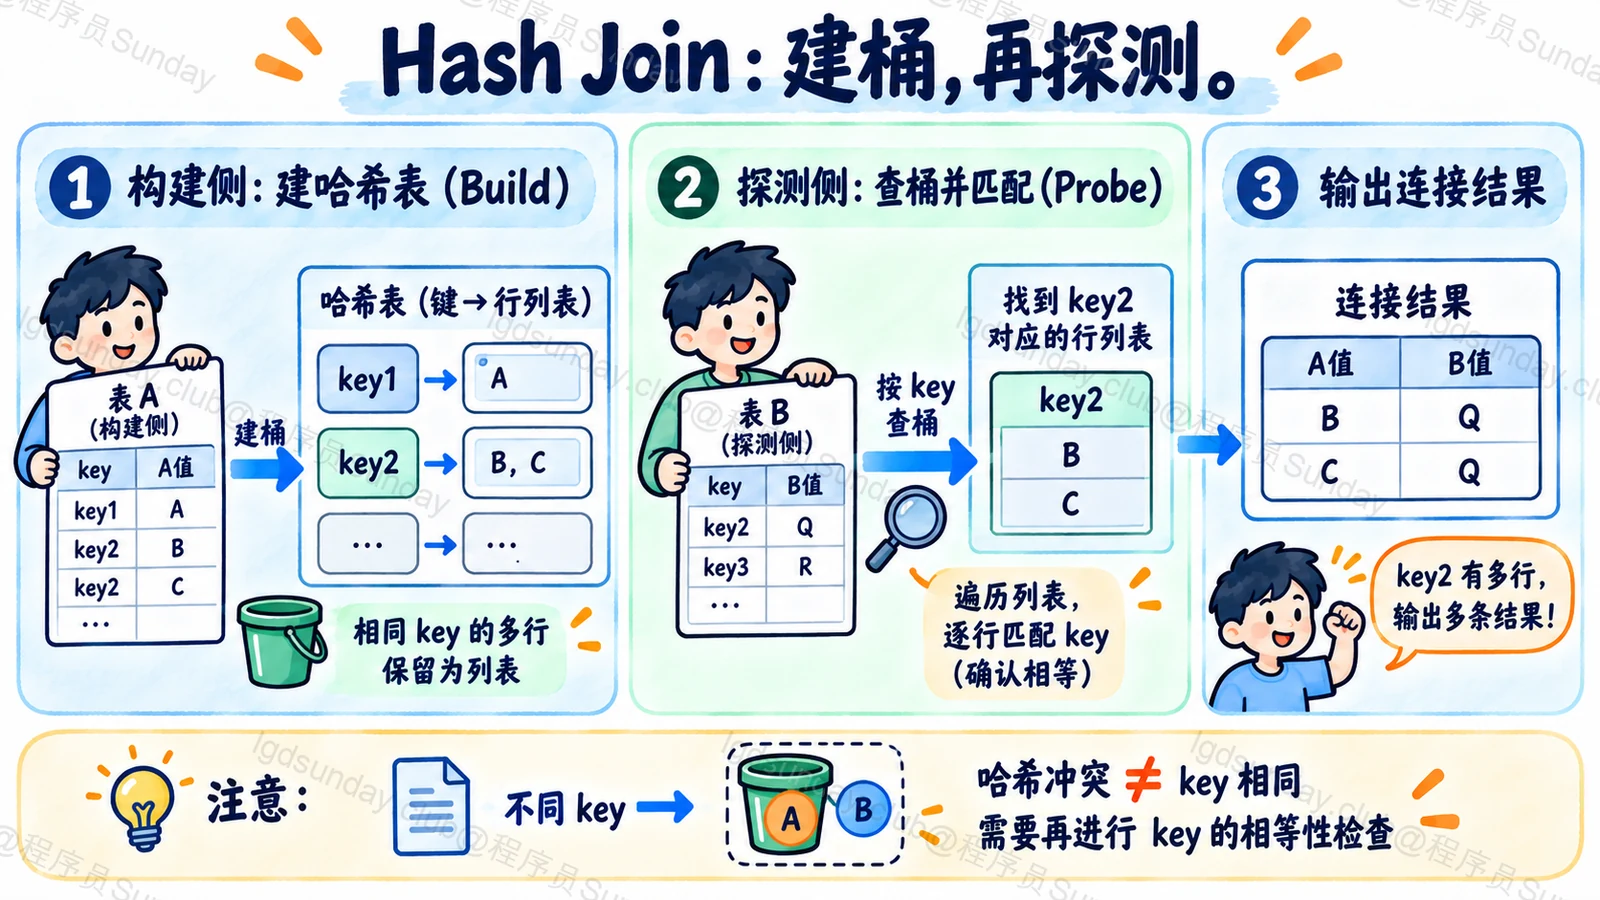
以等值连接为例,Hash Join 可以先把一侧按连接键整理成哈希表,这一侧叫构建侧。另一侧逐行计算连接键,再到表中寻找匹配项,这一侧叫探测侧。
连接键不是唯一值时,一个桶可能关联多条记录,不能只保存一条就认为完成连接。哈希冲突以后,也需要继续核对真实连接条件。
这张临时哈希表不是数据库里新增了一个永久哈希索引。它服务于当前执行,也不是应用自己把 SQL 改成内存 Map。
通常希望构建侧经过过滤后较小,以减少构建成本,但实际两侧选择要看计划,不能认定 SQL 左边永远是构建侧。
内存限制会改变成本
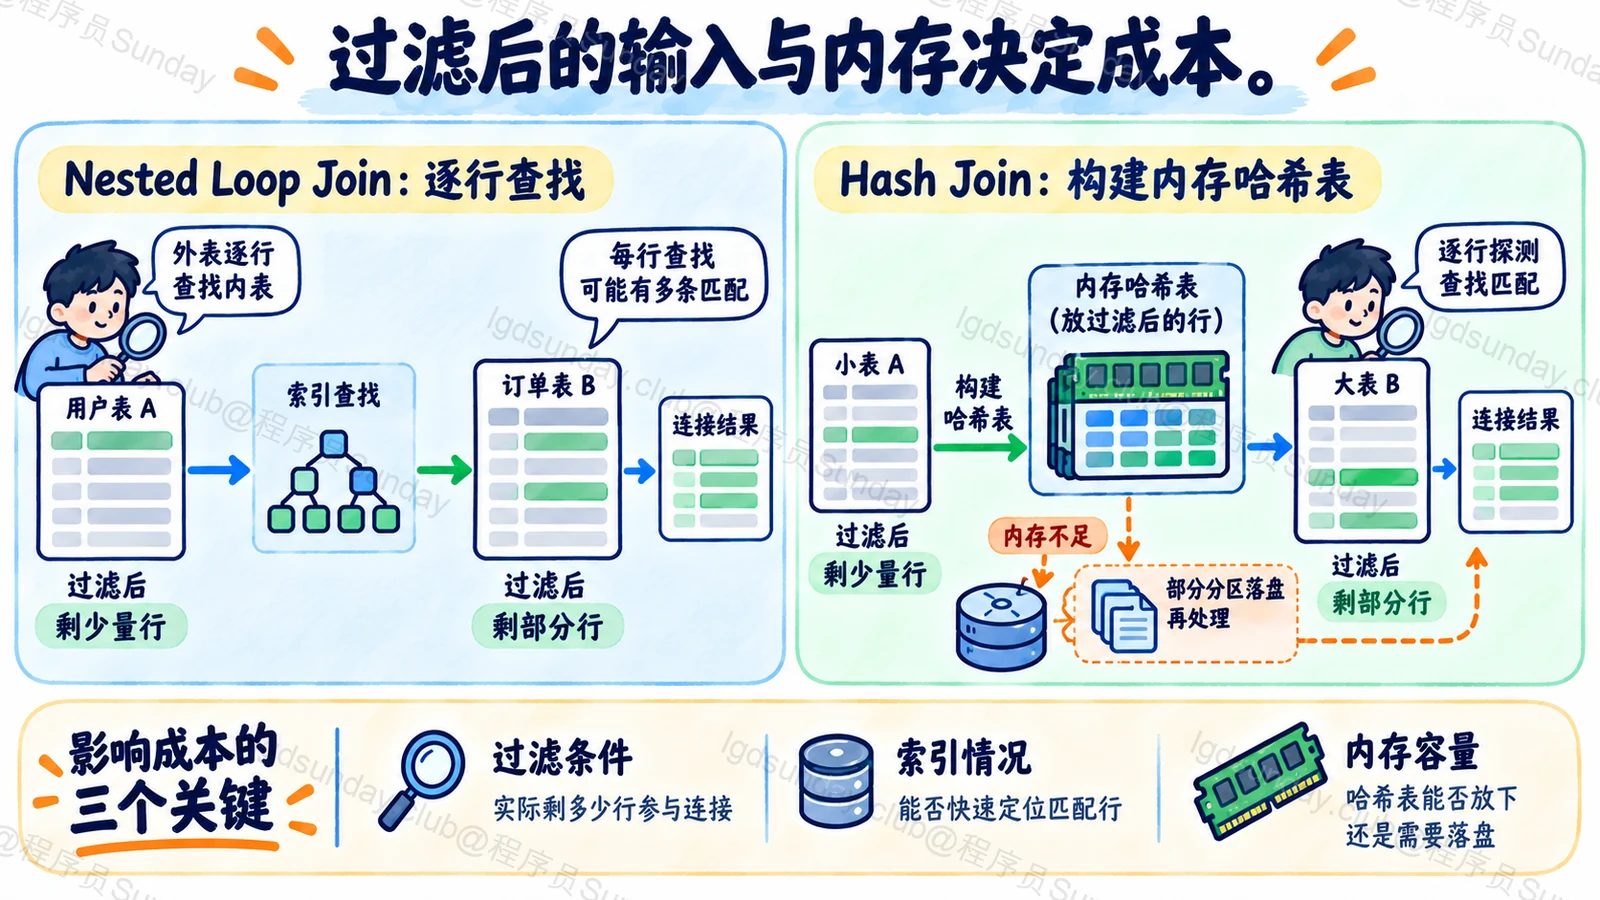
哈希表不能无限占用内存。MySQL 对 Hash Join 的内存使用有相应配置和限制;需要时会将部分工作转到磁盘处理。内存与落盘行为。
因此,两个看起来相似的 Hash Join,一次完全在内存中处理,另一次需要落盘,耗时可能不同。还要考虑行宽:相同行数不代表相同占用。
不能看到落盘就无限调高 join_buffer_size。并发查询也会占资源,调整以后要观察整体内存和系统延迟,而不只看单条 SQL。
先过滤多少行,比算法名字更值得看
假设业务只要最近一天的记录,却让大量历史数据参与连接,再在后面筛掉,工作量可能已经增加很多。
优化器会在语义允许的情况下处理过滤和执行次序。但有些条件、表达式或估计偏差,会影响实际计划。
用 EXPLAIN 的 TREE 形式可以观察算子关系;EXPLAIN ANALYZE 会实际执行支持的语句,帮助比较估计与实际行数、执行次数和时间。计划文档。
本文以 MySQL 8.4 为范围,不把旧 BNL 算法当成当前通用路径,也不提供未经运行的“真实执行计划”。
面试官继续追问
INNER JOIN 写法相同,为什么换数据以后计划变了?
数据规模、分布、过滤效果和统计估计可能变化。优化器根据当前条件比较成本,并不承诺永久采用同一种算法。
Hash Join 只能处理等值连接吗?
不能用本文的等值示例限制整个实现。MySQL 当前版本也支持其他相关连接形态,具体条件应回到版本手册和实际计划。
等值连接更适合先讲清构建与探测,但不是所有支持范围的完整清单。
能否强制某个算法解决性能问题?
某些版本提供优化控制,但先要明确错误估计或实际瓶颈。强制计划可能只适合当前数据,一旦规模变化,就可能变成新的问题。
面试速记卡
- Nested Loop:一侧逐行驱动另一侧,内层可使用索引。
- Hash Join:构建临时哈希表,再由另一侧探测匹配。
- 选择变量:过滤后的行数、索引、行宽、内存与并发。
- 性能误区:有索引或用了 Hash Join,都不能直接证明查询快。
- 排查证据:实际计划、rows、loops、耗时及落盘情况。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
百度 · 数据库工程(运维部) · 原帖未明确批次
数据库的 Nested Loop Join 和 Hash Join 有什么优缺点,分别适合什么场景?(题意整理)
2016年8月百度运维部数据库岗位内推面经 ↗
一面记录为 2016-08-25;原帖编辑于 2016-09-27