
Redis 的 SCAN 和 KEYS 有什么区别?COUNT 是每次固定返回的数量吗?
下面是一段教学用的模拟面试。
🧑💻 面试官: 为什么线上通常用 SCAN,而不是 KEYS?
🙋♂️ 我: SCAN 分页,不会阻塞,而且 COUNT 可以指定每页数量。
🧑💻 面试官: COUNT 设成 100,却只返回几条,正常吗?返回空列表,能结束吗?
🙋♂️ 我: 还要看游标是不是零。
🧑💻 面试官: 扫描时有人增加、删除键,你拿到的是某一时刻的快照吗?
SCAN 是「分批遍历」,不是稳定分页。把游标当页码,把 COUNT 当精确条数,都会写错。
面试速答(60 秒版)
KEYS 通常在一次命令里扫描并返回匹配键,键空间很大时会明显影响其他请求。SCAN 用游标把完整遍历拆成多次命令,让客户端在调用之间安排其他工作。
从游标 0 开始,把返回游标原样传给下一次调用,直到返回 0 才结束。某轮没有匹配结果,不代表遍历结束。
COUNT 是工作量提示,不是固定返回数量;MATCH 也不把扫描变成索引查询。SCAN 可能返回重复项,而且并发增删时不提供快照。
因此,处理逻辑要能应对重复和消失的键,并控制批次与节奏。分批降低单次影响,不等于完全没有开销。
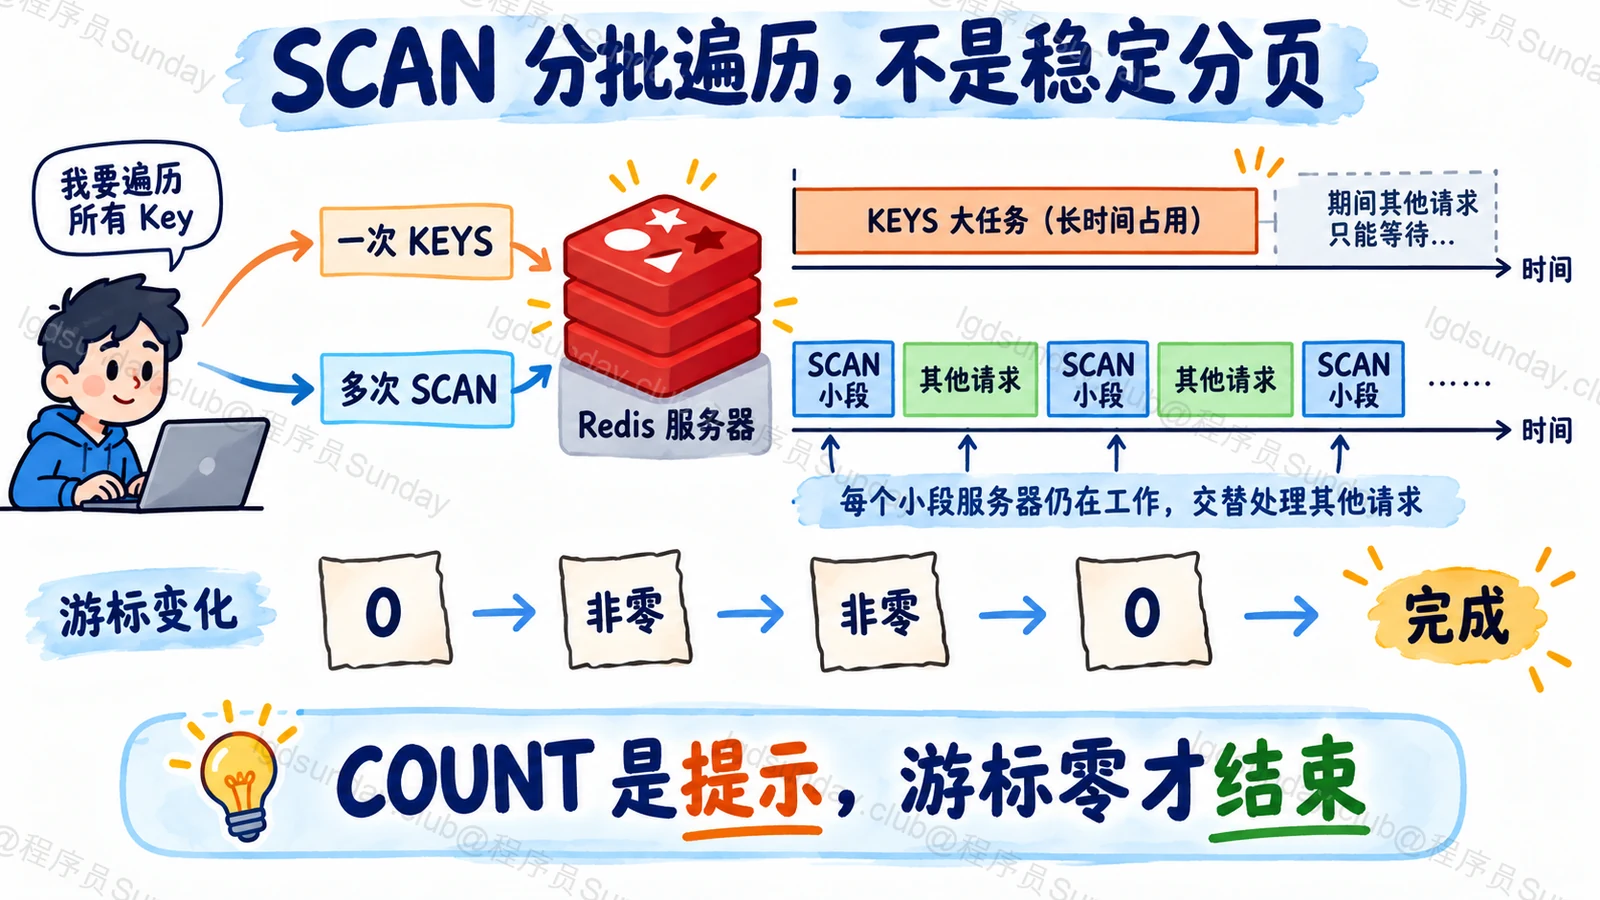
图:SCAN 分批遍历,不是稳定分页。
知识点详解:游标告诉你怎样继续,不告诉你这是第几页
KEYS 的问题,在于一次做了太多工作
假设后台巡检需要找一批缓存键。开发环境只有几十个,KEYS 看起来很方便;线上键空间很大,同一条命令的成本就不同了。
匹配模式不是神奇的业务索引。即使最后匹配的键不多,也要根据命令、版本和数据布局考虑扫描工作。不能拿返回条数推断扫描一定很轻。
KEYS 并不是永远不能使用,但在未知规模的在线实例上随手运行,是不合理的运维习惯。
SCAN 怎样完成一整轮?
第一次传入 0,服务器返回一个新游标和一批键。下一次继续传这个新游标,而不是自己加一,也不是用返回条数算偏移。
游标不应被当成可排序的页码。它是继续遍历所需的不透明信息。
只有返回游标再次为 0,才表示这次完整迭代结束。中间某轮可能没有匹配项,尤其使用 MATCH 时;此时仍然要按新游标继续。契约见 Redis SCAN 文档。
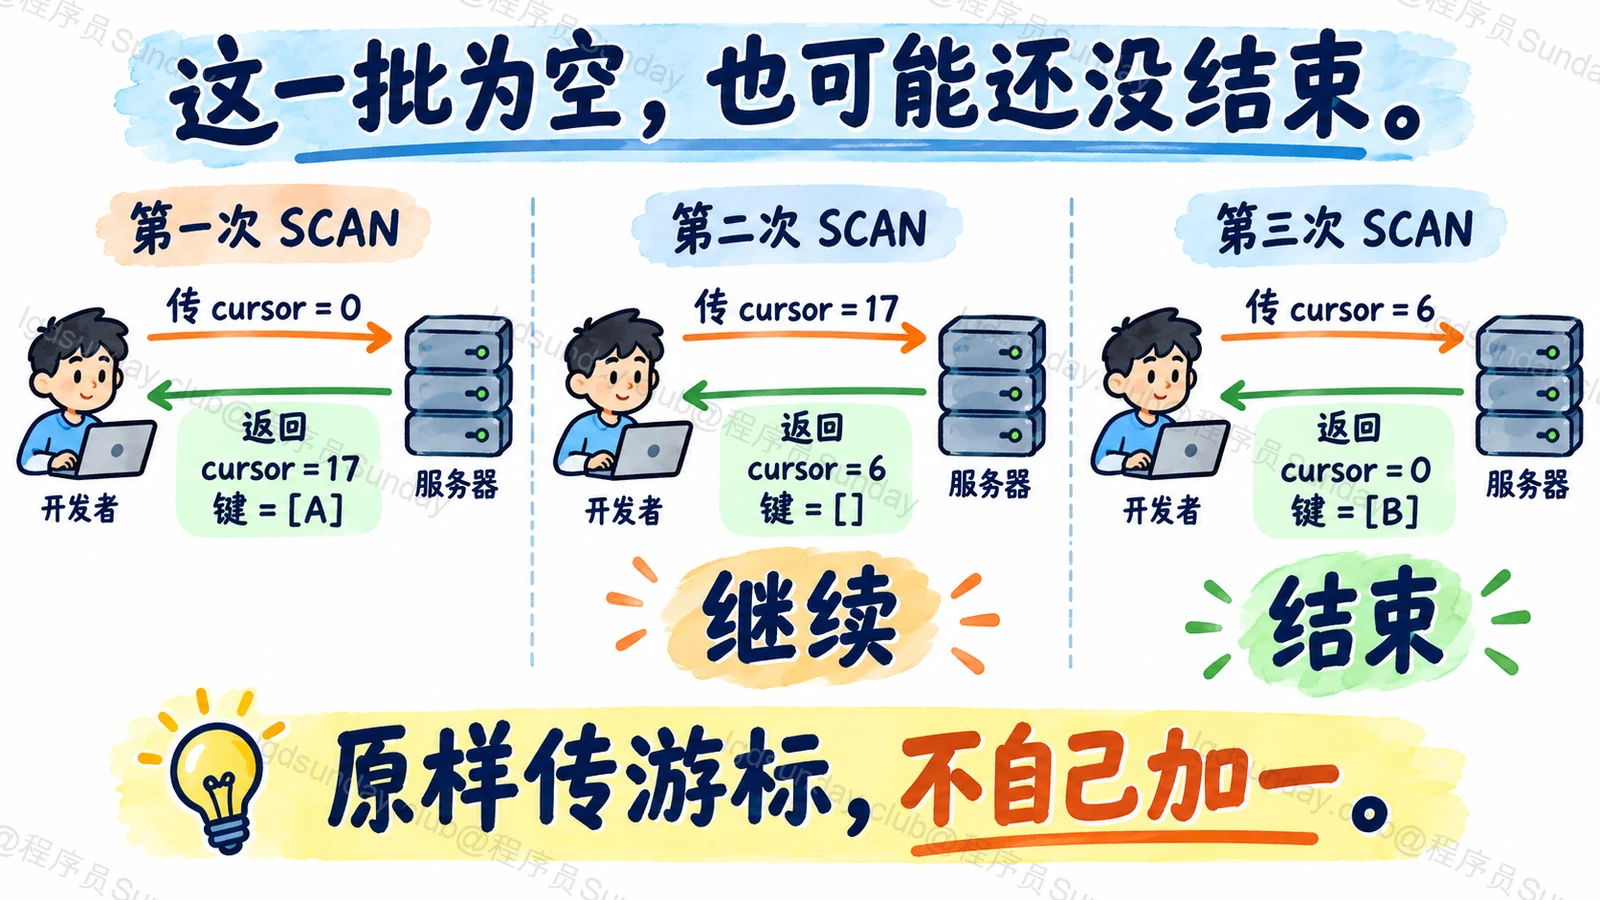
图:这一批为空,也可能还没结束。
COUNT 为什么不是 LIMIT?
COUNT 告诉服务器希望每次做多少工作,但实际返回数量受数据结构、过滤等影响。可能少于预期,也可能多于预期,甚至为零。
因此,不能把它做成“第 3 页固定 100 条”的用户分页接口。要做稳定列表,应该使用适合业务排序与分页的数据结构,而不是把键空间扫描包装成普通查询。
同样,不要说“SCAN 完全不阻塞”。每次命令依然要处理工作,COUNT 很大或调用过密,仍可能影响延迟。
重复与并发变化要怎样处理?
完整迭代对在整个期间持续存在的元素有相应保证,但可能重复返回;扫描过程中新增、删除的元素,不能当成某一时刻的完整快照解释。
假设巡检拿到一个键,稍后读取时它已经过期,这是正常情况。处理代码需要容忍键不存在,而不是把所有此类结果都算异常事故。
如果扫描后要执行有副作用的动作,必须考虑重复处理。幂等、去重和条件判断,比把 COUNT 调成一个“刚好好看”的值重要。
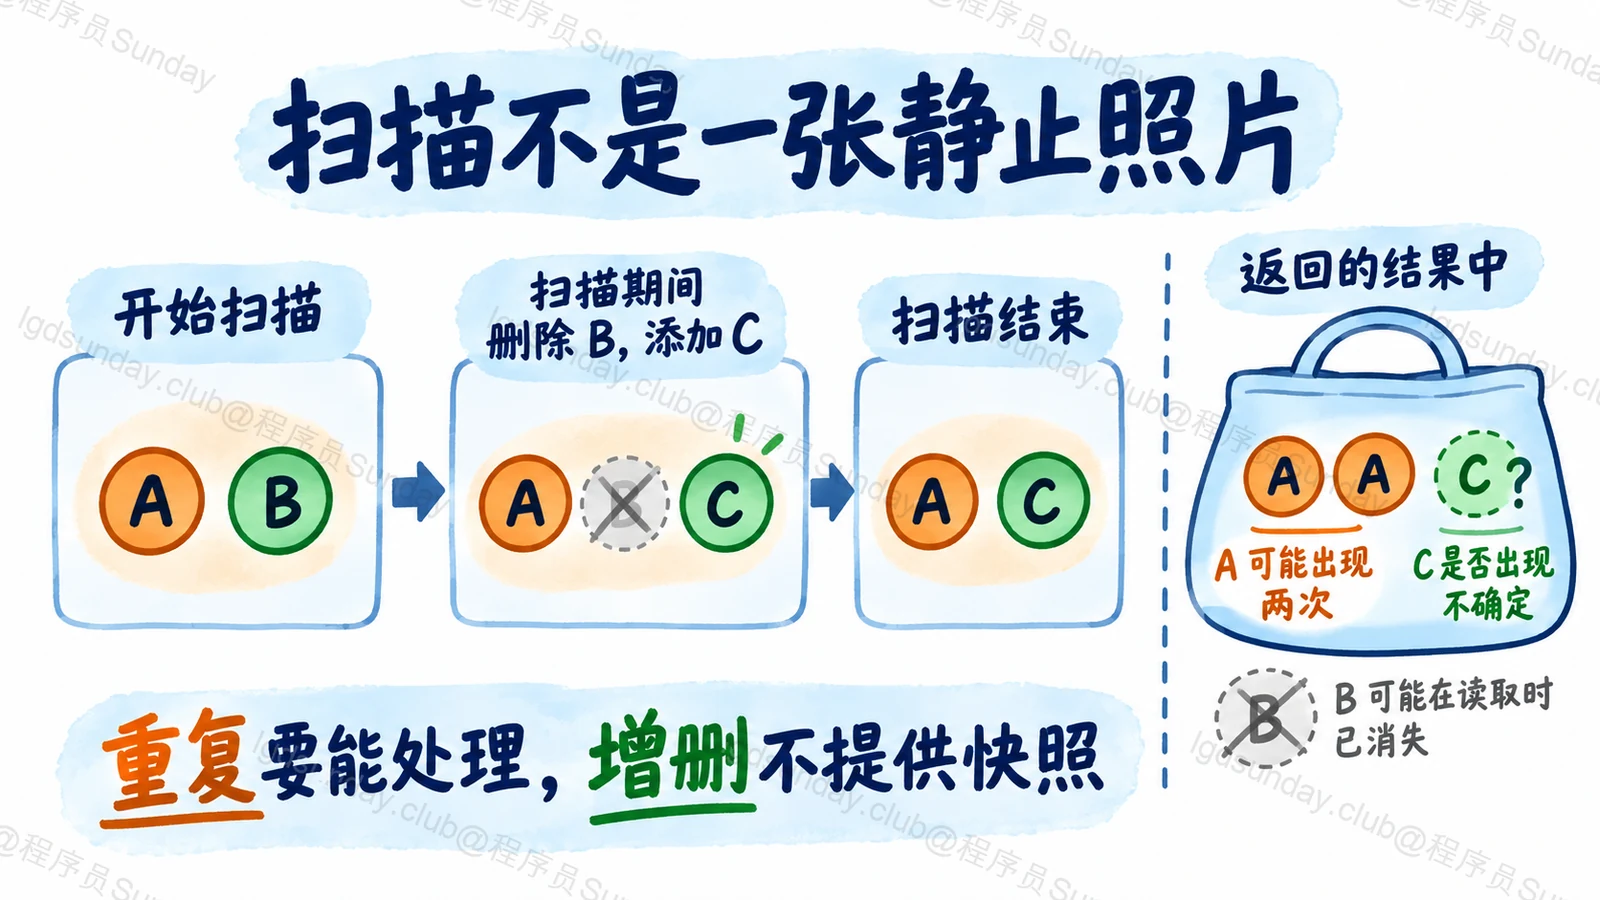
图:扫描不是一张静止照片。
集群还要注意覆盖范围
一个节点上的 SCAN,不自动代表整个集群所有节点。实际工具需要按拓扑与客户端能力覆盖相应节点,还要考虑拓扑变化。
本文解释命令契约,不提供一段默认删除匹配键的脚本。扫描和删除是不同权限、不同风险的操作。
面试官继续追问
重复项一定要在内存里全局去重吗?
不一定。若操作本身幂等,可以避免存下巨大集合;若确实要做唯一统计,需要选择能承受规模的去重方案。先明确目标。
能把一次返回的游标保存起来,长期当断点吗?
不能当稳定分页或持久快照。重启、数据变化和拓扑变化都会影响解释,任务恢复要按自身正确性要求设计。
面试速记卡
- KEYS:单次扫描,规模大时影响其他请求。
- SCAN:多次游标调用,返回 0 才结束。
- COUNT:工作量提示,不是固定条数。
- 结果:可能重复,变化中的键不构成快照。
- 工程:节奏、幂等、键消失和集群覆盖都要处理。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →