
Redis 为什么使用 SDS 而不是 C 字符串?二进制安全和预分配是什么?
下面是一段教学用的模拟面试。
🧑💻 面试官: Redis 为什么用 SDS,不直接用 C 字符串?
🙋♂️ 我: SDS 更快,而且能保存二进制。
🧑💻 面试官: “更快”发生在哪个动作?内容中间有一个零字节,怎么知道后面还有数据?
🙋♂️ 我: 它另外记录了长度,不只找结束符。
🧑💻 面试官: 连续追加数据时,长度、容量和结尾的零字节又各管什么?
SDS 的关键不是多了一个名字,而是把「内容长度」与「分配容量」明确记录下来。
面试速答(60 秒版)
传统 C 字符串通常用零字节表示结束,取得长度需要扫描,也不能直接把中间零字节当作普通内容处理。
SDS 是 Redis 使用的一种动态字符串表示。它通过头部元数据记录长度,并按相应类型记录容量,后面保存字节内容;同时保留结尾零字节,方便部分 C 字符串操作。
读取逻辑长度不必每次扫描,内容也可以包含零字节。追加前检查剩余空间,必要时扩容,并可能预留空间,减少连续追加时的分配次数。
不过二进制安全依赖使用正确的长度型操作;把内容交给 strlen 等接口,仍会遇到零字节边界。具体头部类型和扩容策略是版本实现,不是客户端协议。
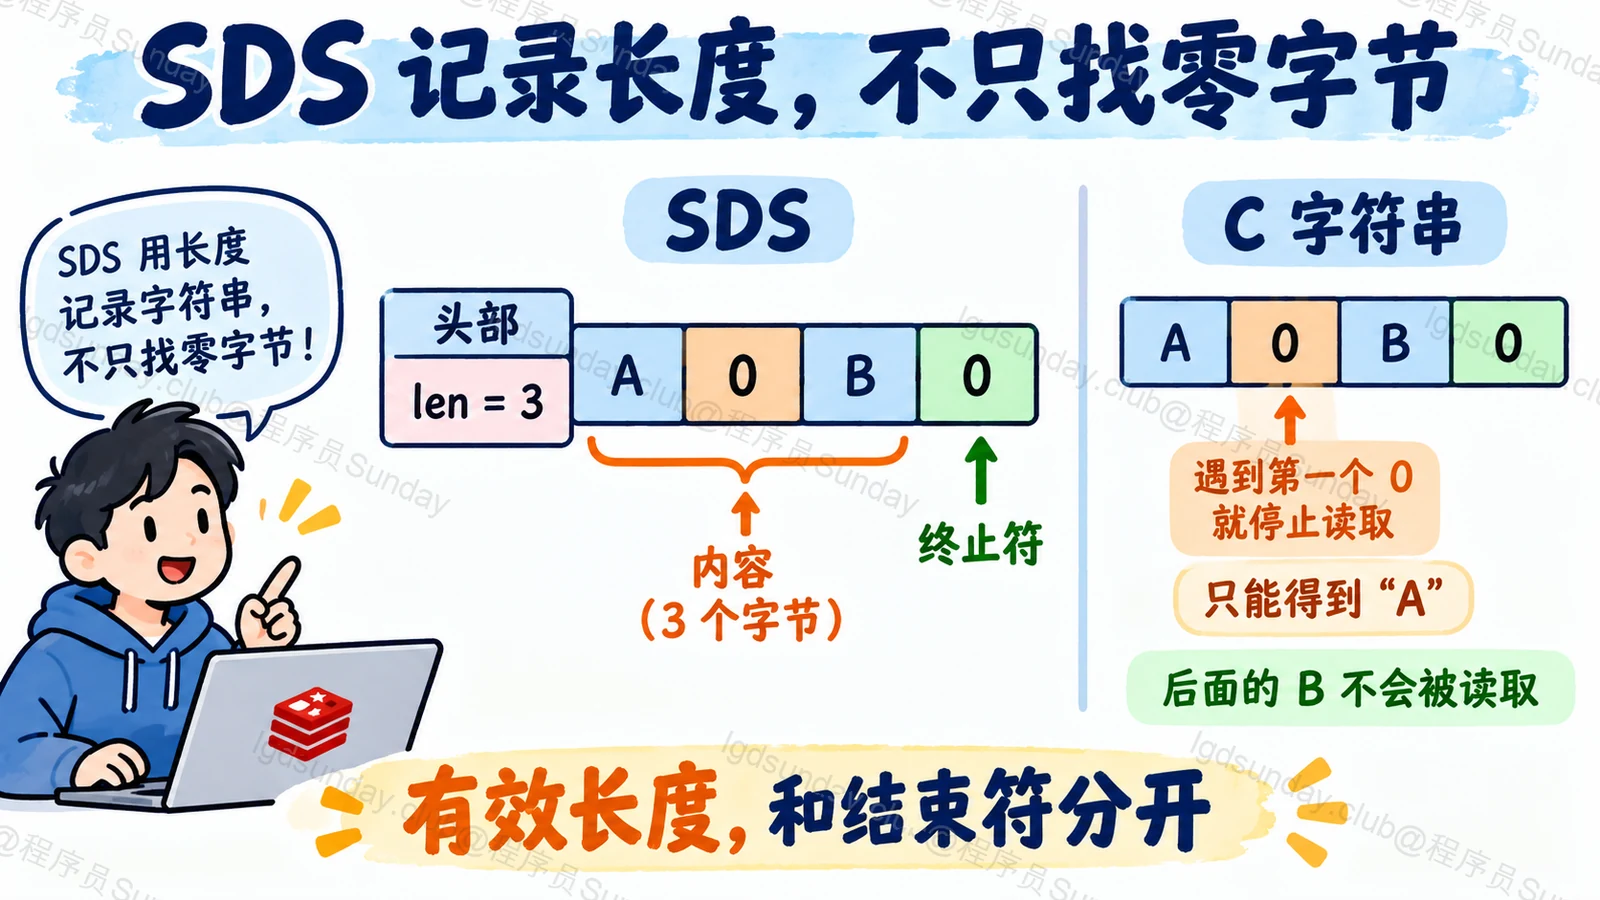
图:SDS 记录长度,不只找零字节。
知识点详解:字符串里有零字节,长度该从哪里来?
C 字符串通常怎样确定结束?
假设字节内容是 A、零字节、B。如果按常见 C 字符串约定找终止符,看到中间的零就会认为内容结束,无法把后面的 B 当作同一段字符串继续读取。
这种约定适合很多文本接口,但对任意二进制数据不够。问题不在于零字节不能存在于内存,而在于接口怎样知道有效内容有多长。
SDS 把长度放进元数据
SDS 可以把有效长度记录为 3,数据区保存这三个字节。末尾还可以有额外的零终止符,但它不属于有效内容长度。
读取二进制内容时,按记录的长度处理,因此中间零字节不再意味着“这里结束”。同样,取得长度可以直接读取元数据,而不是从头扫描整段内容。
Redis 8.2 的 sds.h定义了不同大小的头部形式。教学图里常画 len、alloc、buf,是便于理解的概念布局;不能认为所有短字符串头部都逐字长得一样。
长度与容量为什么要分开?
假设内容已经用了 8 字节,分配的内容空间有 16 字节。追加少量内容时,可以直接利用剩余空间,不必每次重新申请内存。
空间不够,才需要扩容,并把新内容与长度信息更新正确。常见追加路径可能预留更多空间,让接下来的追加不必立刻再分配。实际策略见固定版本的 sds.c。
预留空间是在用一定内存换取较少分配,不是让所有修改都零成本。过大的字符串和频繁改写,仍有内存与复制成本。
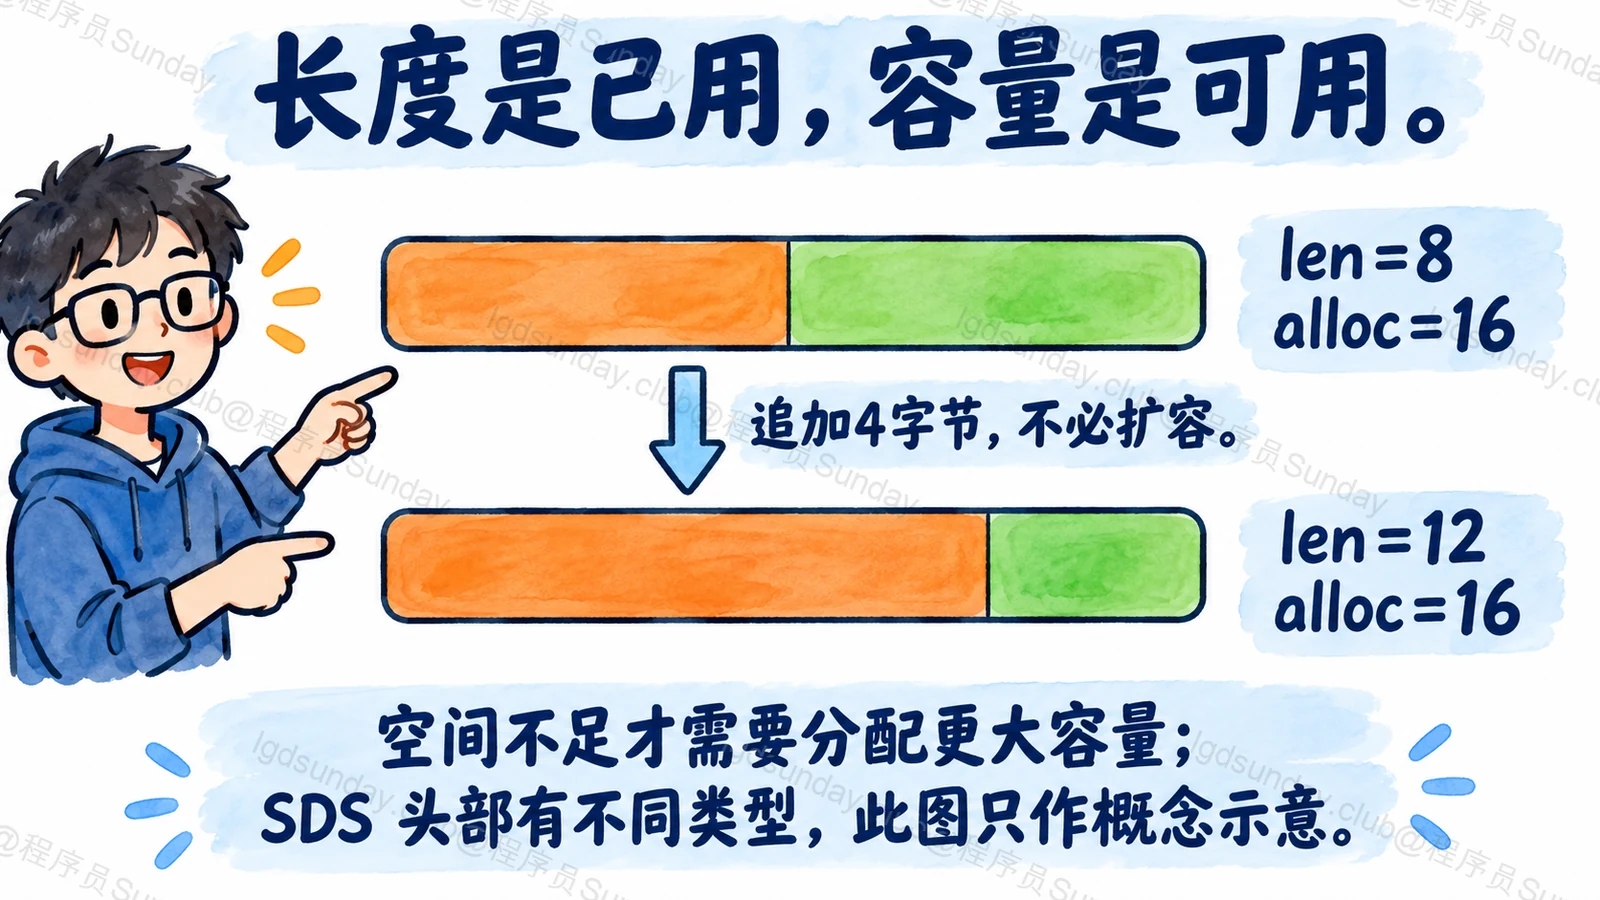
图:长度是用了多少,容量是能放多少。
二进制安全不是所有函数自动安全
如果我们拿到 SDS 内容,却把它传给只认零终止符的接口,接口仍会在中间零字节处停下。
因此,准确说法是:这份表示和相应的长度型操作支持任意字节。不能把“底层使用 SDS”推广成“任何调用方式都能正确处理二进制”。
终止符的保留,主要帮助兼容部分 C 接口;它没有取代元数据,也不代表所有兼容调用都适合任意内容。
Redis String 就永远只是一张 SDS 吗?
客户端看到的是 Redis 的字符串类型与命令行为;内部还涉及 Redis 对象、不同编码与小值优化。
所以,不能把一个内部示意图当成每个 String 键完整的内存结构,更不能据此直接计算生产内存占用。实际统计要考虑对象、键、分配器与版本条件。
本文是源码解释,不用 TS、Python 的字符串实现伪装成 SDS,也不提供未验证的跨版本容量公式。
面试官继续追问
SDS 能避免缓冲区溢出吗?
相应 API 通过长度、容量检查管理写入,降低直接拼接 C 缓冲区的风险。但绕开 API 随意写内存,仍可能破坏结构。
删除内容后,容量一定立即缩小吗?
不能按“长度变小”推出“内存立刻回收”。是否收缩、何时释放,要看调用路径和实现。
面试速记卡
- C 字符串:通常靠零终止符找结束。
- SDS:记录有效长度,并管理容量与字节区。
- 二进制:中间零字节可属于内容,按长度处理。
- 追加:先检查空间,必要时扩容与预留。
- 边界:内部格式随实现变化,strlen 仍不等于二进制读取。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · Java后端 · 社招
Redis SDS 与 C 字符串有什么区别,为什么预分配?(题意整理)
社招一年半面经分享 · 美团部分 ↗
历史面经,面试年份未明确;页面编辑于 2024-07-19