
Redis Pipeline 为什么能提高吞吐量?和批量命令、事务有什么区别?
🧑💻 面试官:Pipeline 一次发很多命令,算不算一个 Redis 事务?
🙋♂️ 我:算,命令是一起提交的。
🧑💻 面试官:别的客户端会不会在这些命令之间执行?
🙋♂️ 我:可能会,Pipeline 只是少等几次网络。
🧑💻 面试官:第一条读出的值决定第二条怎么写,你还能提前把第二条放进去吗?
Pipeline 优化的是等待交互的次数,不是命令的业务边界。有没有依赖、能否穿插、失败后怎么重试,要另行设计。
面试速答(60 秒版)
Redis Pipeline 是客户端连续发送多条命令,不在每条后都停下来等待回复,再按顺序处理结果。它主要减少往返等待,并提高批量 IO 效率。
服务器仍要执行这些命令,Pipeline 不把十条操作变成一条,也不保证整批原子执行。某条失败也不能自动回滚其他命令。
适合多个可以提前准备的独立操作;如果后一个操作依赖前一个返回值,普通 Pipeline 无法消掉这个计算依赖,可以考虑原子命令或短脚本。
批次还要有数量和字节上限,避免回复积压占内存。不同客户端的批量 API 有差异,例如 Python 的 pipeline 默认可能开启事务,必须看配置,不能只凭方法名判断。
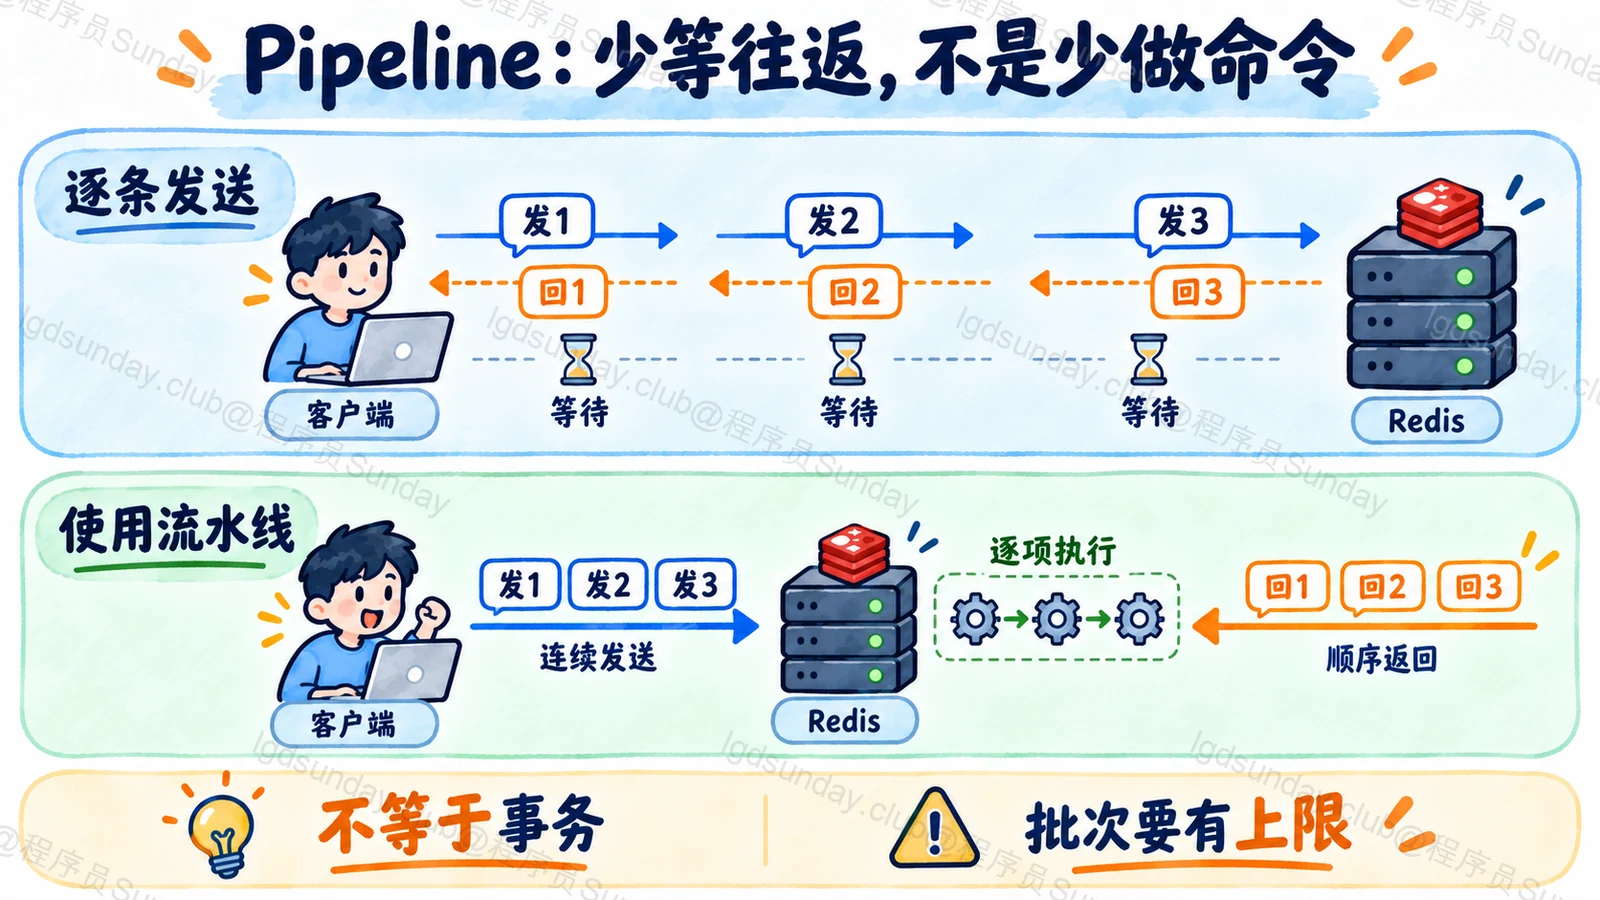
知识点详解:少等网络,不等于少做服务器工作
把每条都等回复,改成先连续发送
假设需要读十个互不依赖的缓存。逐条执行时,每发一条都等回复,网络往返会反复出现在串行路径上。
Pipeline 可以先发送这一批,再接收这一批的结果。它也有助于减少一些读写调用与调度成本,但不是把命令处理时间变成零,更不能承诺任何场景都精确快十倍。
这里的“批量”是客户端与协议交互方式,不是服务器给整个批次加了一把事务锁。
数据依赖会阻止提前准备命令
例如先 GET 额度,客户端判断大于零以后才决定扣减。没拿到前一个结果,就不能正确准备后一个更新。
如果直接把 GET 与 SET 一起发送,只是在提前写一个自己并不知道是否正确的值,也没有解决其他客户端的竞争。
这种需求应先找原子命令;确实需要读取、判断、修改组合时,可以评估 Lua 或 WATCH。选择是由依赖与一致性要求决定,不是哪个接口名字听起来更快。
客户端 API 需要看实际语义
node-redis 提供自动流水线等行为,常见用法是在同一事件循环批次里发起多个独立请求。redis-py 的 pipeline 默认可以带事务,非事务流水线需要明确 transaction=False。
因此本文把协议层 Pipeline 和某个库叫 pipeline 的对象分开。两个库方法名字相似,未必有相同默认配置。
Cluster 客户端还可能按节点拆分请求,返回顺序、重定向和支持命令都要按实际库核验,不能把单连接说明机械搬过去。
失败后可能不知道哪些命令已执行
假设已经发出一批写入,回复回来之前连接中断。应用不能仅根据没收到回复,认定所有命令都没执行。
对于 INCR 这类重放会再次改变结果的操作,整批无脑重试会重复修改。需要依据业务请求 ID、幂等设计或可查询的完成状态处理不确定结果。
另一方面,大批次会让服务器缓存较多回复,客户端也要存放结果。用合理分批、字节限制和背压控制资源,并在测试中覆盖部分错误、断连与大返回值。
本题机制参考:Pipelining、redis-py Pipeline、node-redis Pipeline。
面试官继续追问
MGET 和 Pipeline 一样吗?
不是。MGET 是一条多键命令,Pipeline 是多条命令的发送方式;Cluster 下的键槽与客户端行为也要区分。
Pipeline 中某条失败,怎么知道?
读取逐项结果和错误,不能只检查整批有没有网络异常。断连时还可能进入结果不确定状态。
批次越大越快吗?
不一定。网络效率可能提升,但回复内存、尾延迟和错误恢复成本也增加,应按命令与结果大小测试。
面试速记卡
- 作用:减少往返等待与批量 IO 开销。
- 不保证:整批原子、自动回滚、零执行成本。
- 适用:能提前准备的独立操作。
- 依赖:读后判断再写,考虑原子命令或脚本。
- 工程:看库默认、限制批次、处理断连后的不确定结果。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 后端(抖音) · 社招
Redis Pipeline 有什么用途,是否保证原子性?(题意整理)
社招一年半面经分享 · 抖音部分 ↗
历史面经,面试年份未明确;页面编辑于 2024-07-19