
Redis 的 ZSet 是怎么实现的?为什么会用跳表?
🧑💻 面试官:Redis 的 ZSet 为什么用跳表?
🙋♂️ 我:因为跳表查询快,都是 O(log N)。
🧑💻 面试官:按成员找分数,和按分数查一段,用的都是同一条查找路径吗?
🙋♂️ 我:可能还需要哈希表。
🧑💻 面试官:只有十几个短成员时,也一定要建立完整跳表吗?
ZSet 同时要解决“按成员找”和“按顺序找”。先分清这两种需求,再谈字典、跳表与小集合编码。
面试速答(60 秒版)
ZSet 的成员唯一,每个成员有一个 score。它既支持按成员查分数,也支持按分数或排名读取有序范围。
在常见的跳表编码中,字典帮助按成员定位,跳表负责维护顺序和范围。跳表用多层前向指针跳过一部分节点,通常能以期望 O(log N) 定位;取出 M 个结果还需要相应遍历,不能把所有操作都说成 O(log N)。
小规模、短成员的 ZSet 可以使用 listpack 紧凑编码,不一定有跳表。是否转换要看实际版本和配置阈值。
所以我会从操作需求回答,而不是只背“Redis 选跳表因为比红黑树快”。它是时间、内存、范围访问和实现复杂度之间的选择。
知识点详解:成员查询与有序查询为什么需要不同入口
排行榜里,至少有两种查法
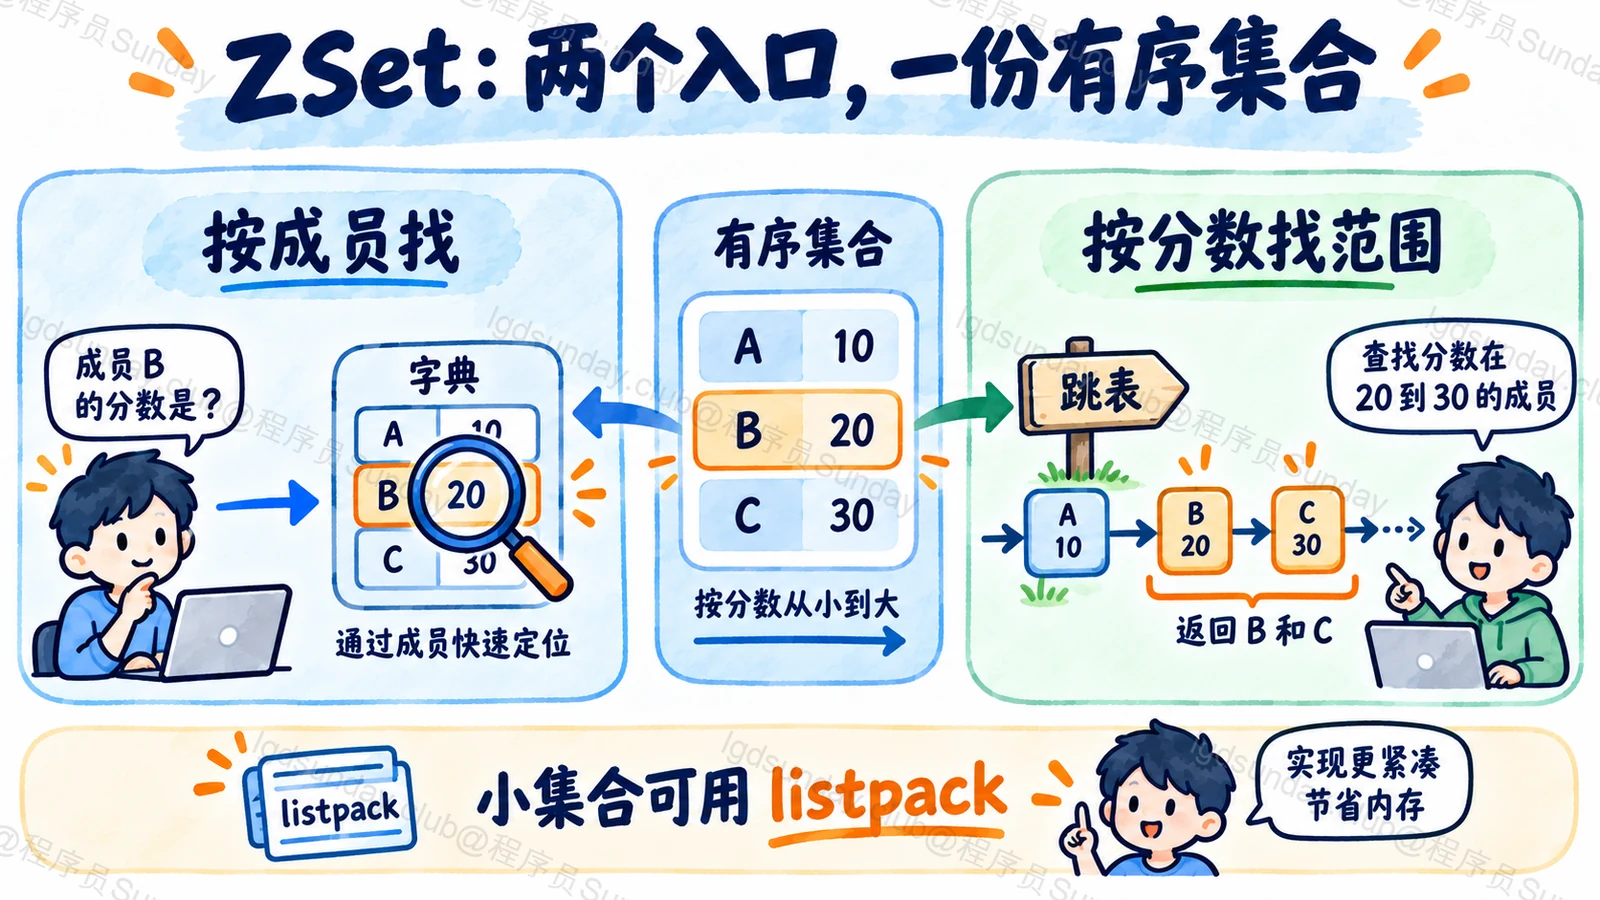
假设学习排行榜记录三位用户:A 为 10 分、B 为 20 分、C 为 30 分。用户查自己的分数,是按成员找;页面取 15 到 30 分的人,是按分数范围找。
如果只用普通哈希表,找到 B 很方便,但要返回有序范围就要额外组织顺序。如果只用简单有序链表,范围遍历方便,找到起点却可能经过很多节点。
ZSet 需要同时支持这些访问模式,而不是“把数组排一次序”就结束。分数更新后,顺序也要维护。
字典找成员,跳表找位置
跳表编码里的字典把成员与分数等信息关联起来,适合成员查找;跳表按 score,并在相同 score 时按成员字节序维护顺序。
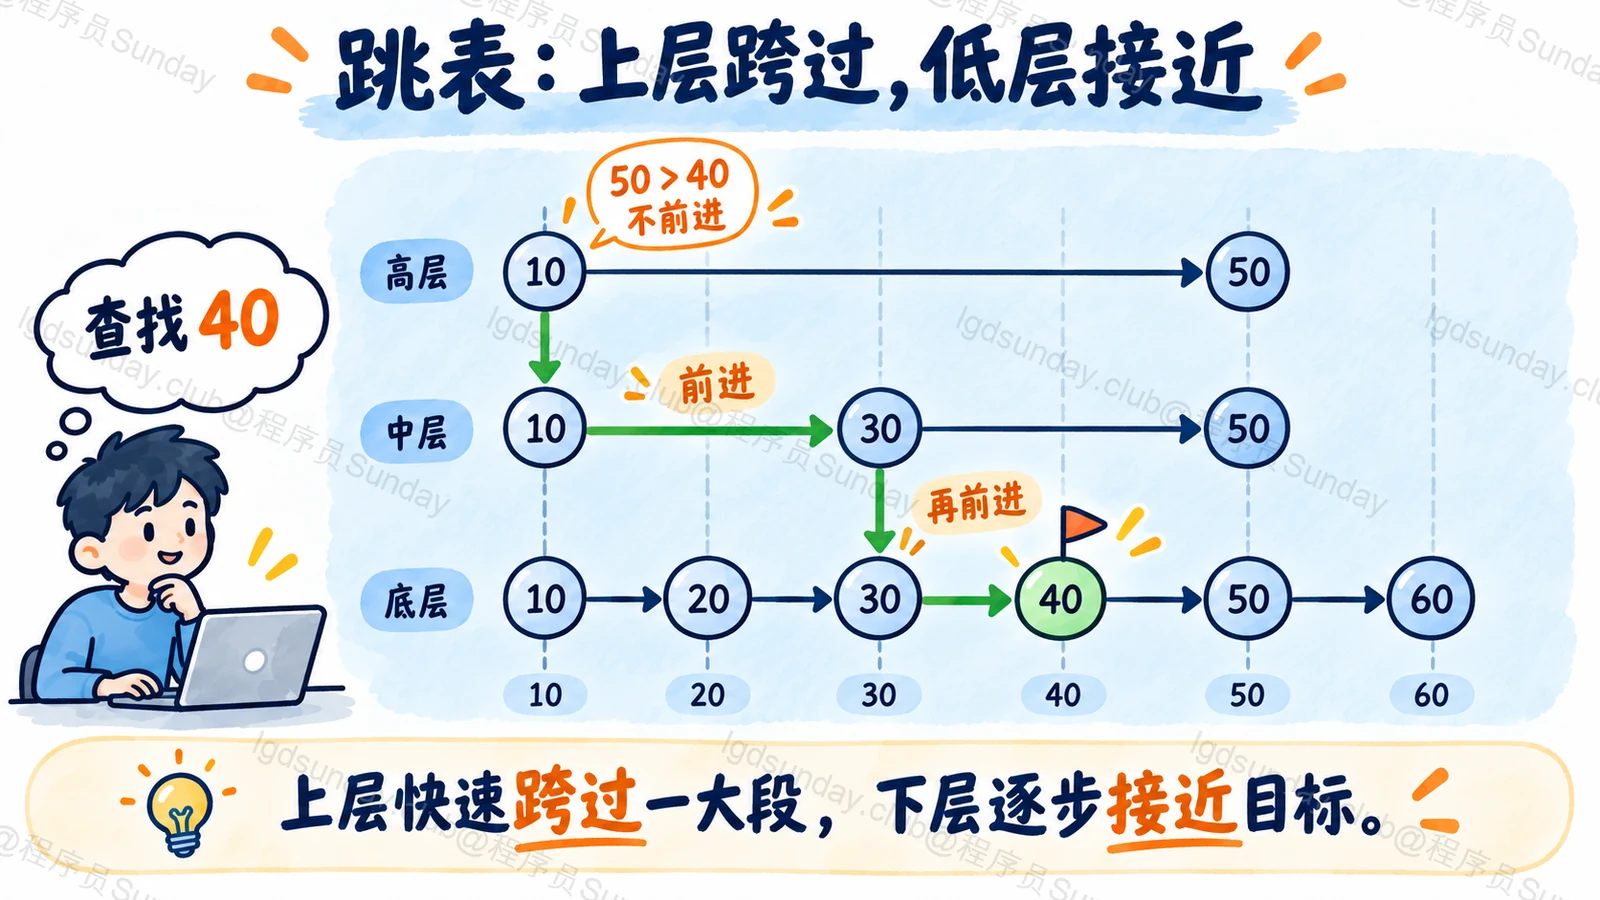
跳表底层保存完整有序节点,较高层只连接部分节点。查找时先在高层跨过较大区间,快到目标时再下到低层,从而减少逐个经过的节点。
层高具有随机性,通常分析的是期望复杂度,不是每次都严格只走 log N 步。找到起点以后,还要顺序读取返回的那些成员。
排名还需要知道跨过多少节点
如果只保存前向指针,能够找到目标,却未必快速知道它是第几名。Redis 跳表还维护跨度信息,记录相应前向连接跨过的底层节点数量。
查询排名时把经过的跨度累加,就能得到位置。插入、删除或分数变化时,需要维护这些信息,而不只是把一个分数字段原地改掉。
同分并不会导致成员自动合并。成员必须唯一,但 score 可以相同;同分次序也不是谁先写入谁在前。
小集合不一定值得付出多指针开销
只有十几个短成员时,紧凑连续编码能节省内存。Redis 7 及之后的相关版本使用 listpack 处理符合条件的小 ZSet,阈值是配置,不是所有环境不变的常数。
因此看一次 OBJECT ENCODING,可能得到 listpack,而不是 skiplist;这并不意味着 ZSet 不再有序。
选择结构要看规模和操作。读取巨大范围仍会消耗服务器时间、网络和客户端内存,不能因为索引定位快就一次把全部排行榜取出来。
本题机制参考:Sorted sets、内存优化、Redis 8.2 ZSet 源码。
面试官继续追问
为什么不用红黑树?
平衡树也能支持有序访问,不是不可行。需要结合范围遍历、排名信息维护、代码复杂度和内存比较;不能凭数据结构名字做普遍速度排名。
两个用户同分,谁排前面?
按该操作方向和成员的字节字典序规则决定,不按写入时间。业务需要另一个同分规则时,应明确设计,不靠隐含顺序。
ZSet 的 score 能直接存任意超大整数吗?
它使用双精度浮点数。精度边界要核验,不能把任意 64 位整数都当成能精确表示的 score。
面试速记卡
- 需求:成员查询与有序范围查询。
- 常规编码:字典管成员,跳表管顺序。
- 复杂度:定位成本与返回 M 项的成本分开。
- 排名:跨度帮助累计位置。
- 边界:小集合可用 listpack,同分不按写入时间。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · Java后端 · 社招
Redis 有序集合怎样实现,为什么使用跳表?(题意整理)
社招一年半面经分享 · 美团部分 ↗
历史面经,面试年份未明确;页面编辑于 2024-07-19